動態規劃(DP)
範圍 — DP 的主文件 — 狀態設計、模式目錄,以及每個必會 DP 家族各一份標準模板;實作解法庫、冷門技巧,以及五個最重的子題目都各自獨立成篇,從這裡連過去。 另見 — 從本檔拆出:dp_examples.md — LC 實作解法庫與依模式分類的題目索引;dp_advanced.md — 賽局理論、樹上 DP、區間與字串的深入探討、機率 DP;knapsack.md — 0/1 vs 完全背包、子集和、組合 vs 排列(knapsack_01_zh.md — 0/1 背包的中文詳解版);dp_string.md — 雙序列格子家族;dp_bitmask.md — 狀態壓縮;dp_digit.md — 按位數計數;dp_monotonic_stack.md — 堆疊裡帶著 DP 值;dp_loop_order.md — 為什麼轉移式會決定迴圈的巢狀與方向,並把 LC 139 用五種寫法走一遍。 相鄰文件:dp_pattern.md — 精簡的模板索引,一個經典模式一節;recursion_to_dp.md — 一步步把能跑的遞迴改寫成 DP;kadane_algorithm.md — 最大子陣列家族的深入版;stock_trading.md — LC 121/122/188/309/714 的狀態機。
LeetCode 題目清單
總覽
動態規劃是一種演算法典範:把複雜問題拆成較簡單的子問題,並把子問題的答案存起來,避免重複計算。
關鍵性質
- 時間複雜度:因題而異,通常是 O(n²) 或 O(n³)
- 空間複雜度:記憶化表格通常是 O(n) 到 O(n²)
- 核心想法:把重疊的子問題記下來,用空間換時間
- 什麼時候用:具備最佳子結構與重疊子問題的題目
- 關鍵技巧:記憶化(由上而下)與表格化(由下而上)
核心特徵
-
最佳子結構:最佳解由子問題的最佳解組成
-
重疊子問題:同一個子問題被算很多次
-
記憶化:把結果存起來,避免重算
-
狀態轉移:定義狀態之間的關係
-
核心變數:
state、transition -
注意!!
什麼都可以塞進 state 裡
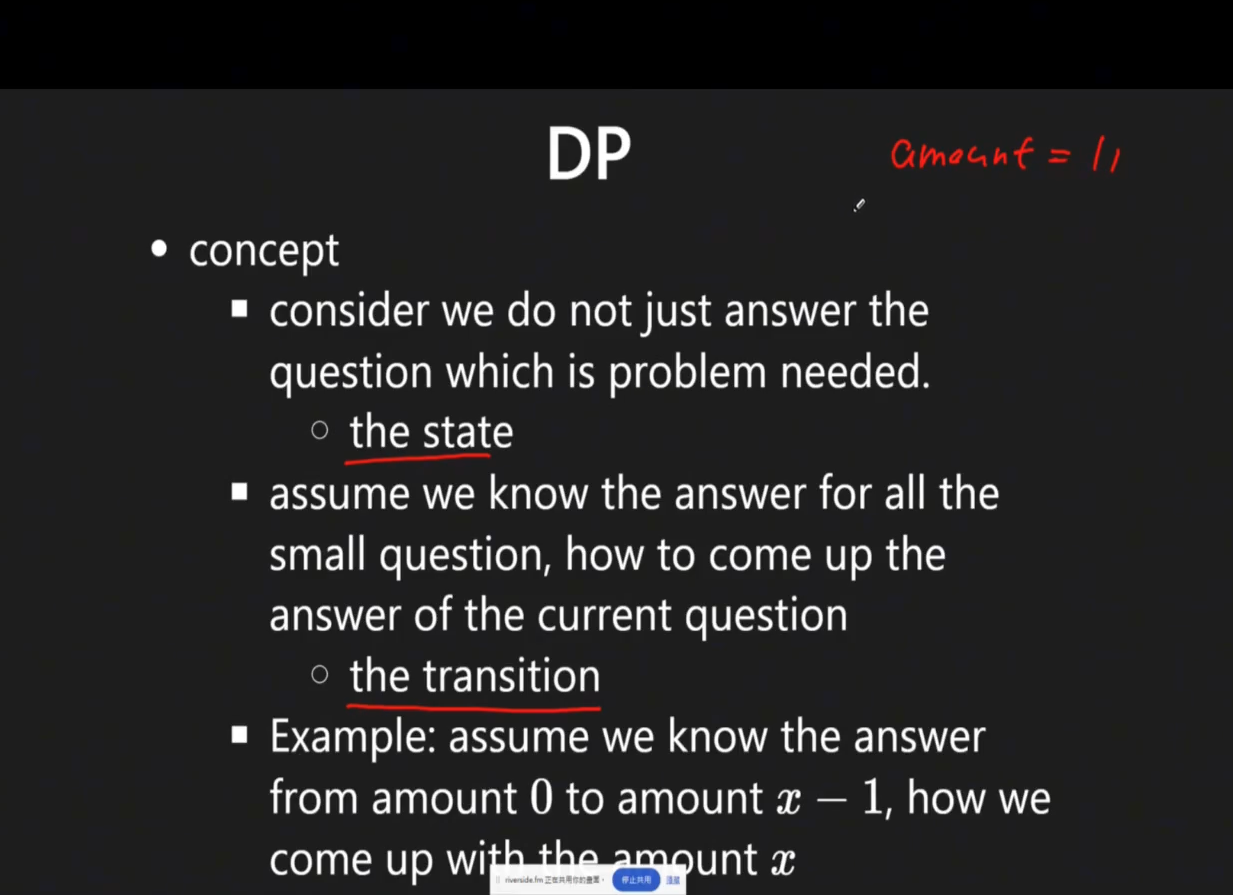
步驟
第 1 步:定義 dp def
第 2 步:定義 dp eq
第 3 步:檢查邊界條件、題目要求、邊界情況
第 4 步:取出答案
參考資料
題型分類
分類 1:線性 DP
- 說明:單一序列、相依關係呈線性的題目
- 範例:LC 70(Climbing Stairs)、LC 198(House Robber)、LC 300(LIS)
- 模式:dp[i] 依賴 dp[i-1]、dp[i-2] 等等
- 子型態 — 前綴切分:dp[i] 改成掃過每一個切點 j < i,並檢查整段 s[j:i] — LC 139(Word Break)、LC 132、LC 279。見 Template 1b。
分類 2:格子/二維 DP
- 說明:在二維格子或矩陣上的題目
- 範例:LC 62(Unique Paths)、LC 64(Minimum Path Sum)、LC 221(Maximal Square)
- 模式:dp[i][j] 依賴鄰居
分類 3:區間 DP
- 說明:在區間或子陣列上的題目
- 範例:LC 312(Burst Balloons)、LC 1000(Minimum Cost to Merge Stones)
- 模式:dp[i][j] 表示區間 [i, j]
分類 3-2:賽局理論/Minimax DP → dp_advanced.md
- 說明:兩名玩家在陣列上做最佳決策;每人只能從頭或尾取
- 範例:LC 486(Predict the Winner)、LC 877(Stone Game)、LC 1140(Stone Game II)
- 模式:
dp[i][j]= 在nums[i..j]上的最大相對分差(當前玩家減對手) - 遞迴式:
dp[i][j] = max(nums[i] - dp[i+1][j], nums[j] - dp[i][j-1])— 推導與模板見 dp_advanced.md
分類 4:樹上 DP
-
說明:在樹狀結構上做 DP
-
範例:LC 337(House Robber III)、LC 968(Binary Tree Cameras)
-
模式:每個節點的狀態取決於它的子節點
-
📚 實作方式:樹上 DP 靠 DFS 走訪來實作。DFS 的走訪模式見 dfs.md 模板 6(由下而上的 DFS)
-
子模式:由下而上(後序)的樹上 DP,以及換根 DP(兩趟 DFS)— 都在 dp_advanced.md
分類 5:狀態機 DP
-
說明:具有多個狀態與轉移的題目
-
範例:LC 714(Stock with Fee)、LC 309(Stock with Cooldown)、LC 122(Stock II)
-
模式:不同狀態各用一個 DP 陣列
-
關鍵特徵:狀態轉移取決於前一個狀態 + 動作限制
-
子模式:2 狀態(LC 122)、含冷卻期的 3 狀態(LC 309)、k 次交易的 2k 狀態(LC 123 / 188)— 全都在 stock_trading.md
分類 6:背包 DP
- 說明:帶限制的選取問題
- 範例:LC 416(Partition Equal Subset)、LC 494(Target Sum)
- 模式:dp[i][j],i 是物品、j 是容量/目標
分類 7:字串 DP
- 說明:字串比對、轉換與子序列問題
- 範例:LC 72(Edit Distance)、LC 1143(LCS)、LC 5(Longest Palindromic Substring)
- 模式:dp[i][j] 表示兩個字串各自的位置
分類 8:狀態壓縮 DP
- 說明:用位元遮罩表示狀態,壓低空間複雜度
- 範例:LC 691(Stickers to Spell Word)、LC 847(Shortest Path Visiting All Nodes)
- 模式:dp[mask],mask 表示已走訪/已選取的項目
分類 9:單調堆疊 + DP → dp_monotonic_stack.md
訊號:暴力解是一輪一輪把元素移除(每個元素在有更大的元素追上它時被刪掉), 或是直方圖上的面積/矩形問題。這兩種用模擬都是 O(n^2),改用帶 DP 值的單調堆疊就是 O(n)。
| 題目 | LC | 堆疊裡帶的東西 |
|---|---|---|
| Steps to Make Array Non-decreasing | 2289 | dp[i] = 元素 i 能撐幾輪;被彈出的一整串貢獻 max(...) |
| Largest Rectangle in Histogram | 84 | 前一個比它矮的柱子索引 → 以此結尾的矩形寬度 |
| Maximal Rectangle | 85 | 把 LC 84 逐列套用在累積的直方圖上 |
| Maximal Square / Count Square Submatrices | 221 / 1277 | dp[i][j] = 1 + min(up, left, up-left)(格子 DP,不是堆疊) |
| Flip String to Monotone Increasing | 926 | 單趟計數 DP |
dp_monotonic_stack.md 完整涵蓋:存活輪數的轉移式與實際推演、 LC 2289 的 Java 與 Python 模板、直方圖面積 DP、最大正方形的遞迴式,以及 LC 926 的單趟 DP。
模板與演算法
模板比較表
| 模板類型 | 適用情境 | 狀態定義 | 什麼時候用 |
|---|---|---|---|
| 一維線性 | 單一序列 | dp[i] = 位置 i 的狀態 | 費氏數列類題目 |
| 二維格子 | 矩陣路徑 | dp[i][j] = 座標 (i,j) 的狀態 | 路徑計數、求最小/最大 |
| 區間 | 子陣列/子字串 | dp[i][j] = 區間 [i,j] | 回文、分割 |
| 背包 | 帶容量上限的選取 | dp[i][w] = 物品與重量 | 0/1、完全背包 |
| 狀態機 | 多個狀態 | dp[i][state] = 在 i 且處於 state | 買賣股票 |
通用 DP 模板
def dp_solution(input_data):
    # Step 1: Define state
    # dp[i] represents...

    # Step 2: Initialize base cases
    dp = initialize_dp_array()
    dp[0] = base_value

    # Step 3: State transition
    for i in range(1, n):
        # Apply recurrence relation
        dp[i] = f(dp[i-1], dp[i-2], ...)

    # Step 4: Return answer
    return dp[n-1]
模板 1:一維線性 DP — LC 53Priority 5 of 5 — Must know — expect it in almost every loop
def linear_dp(nums):
    """Classic 1D DP for sequence problems"""
    n = len(nums)
    if n == 0:
        return 0

    # State: dp[i] = optimal value at position i
    dp = [0] * n
    dp[0] = nums[0]

    for i in range(1, n):
        # Transition: current vs previous
        dp[i] = max(dp[i-1], nums[i])
        # Or with skip: dp[i] = max(dp[i-1], dp[i-2] + nums[i])

    return dp[n-1]
遞迴式目錄(一維)
| 題型 | 遞迴式 | 範例 | 時間 | 空間 |
|---|---|---|---|---|
| Fibonacci | dp[i] = dp[i-1] + dp[i-2] | LC 70 Climbing Stairs | O(n) | O(1) |
| House Robber | dp[i] = max(dp[i-1], dp[i-2] + nums[i]) | LC 198 House Robber | O(n) | O(1) |
| Decode Ways | dp[i] = dp[i-1] + dp[i-2](合法時) | LC 91 Decode Ways | O(n) | O(1) |
| Word Break → Template 1b | dp[i] = OR(dp[j] AND s[j:i] in dict) | LC 139 Word Break | O(n²) 個切點,算進切片是 O(n³) | O(n) |
最大子陣列(Kadane)→ kadane_algorithm.md
dp[i] = max(nums[i], dp[i-1] + nums[i]) 就是同一個一維形狀,只是多了「重開還是延續」的抉擇,
所以根本不需要表格。kadane_algorithm.md 完整涵蓋這個家族 —
LC 53、LC 152(最大乘積)、LC 918(環狀)、LC 1191(重複陣列)— 包含索引追蹤與分治法版本。
模板 1a:一維陣列大小與迴圈邊界(n vs n+1)
關鍵問題:為什麼有些一維 DP 題的迴圈跑 0 到 n,有些卻跑 0 到 n+1?
差別在於你的 DP 陣列裡,單一個索引代表什麼。兩個理由就涵蓋幾乎所有題目; 第三個理由 — 實體「階梯」vs「目標」,LC 746 — 在 dp_advanced.md。
1.「索引」vs「數量」(偏移量)
這是最常見的原因。
-
跑到
n(陣列大小 =n):你把索引當成輸入陣列裡的某個具體元素dp[i]意思是「用到第 i 個元素時的最佳結果」- 例:
dp[3]代表「在元素索引 3 的結果」
-
跑到
n+1(陣列大小 =n+1):你把索引當成數量或長度dp[i]意思是「用前 i 個元素的最佳結果」- 例:
dp[3]代表「用前 3 個元素的結果」
範例:LC 198(House Robber)
# Approach 1: Array size = n (index-based)
def rob_v1(nums):
    n = len(nums)
    if n == 0: return 0
    if n == 1: return nums[0]

    dp = [0] * n
    dp[0] = nums[0]
    dp[1] = max(nums[0], nums[1])

    for i in range(2, n):  # Loop to n
        dp[i] = max(dp[i-1], dp[i-2] + nums[i])

    return dp[n-1]  # Answer at last index

# Approach 2: Array size = n+1 (count-based)
def rob_v2(nums):
    n = len(nums)
    dp = [0] * (n + 1)  # Extra space for "0 houses"
    dp[0] = 0  # Robbing 0 houses = 0
    dp[1] = nums[0] if n > 0 else 0

    for i in range(2, n + 1):  # Loop to n+1
        dp[i] = max(dp[i-1], dp[i-2] + nums[i-1])  # Note: nums[i-1]

    return dp[n]  # Answer at position n
The s[i-1] trap — it is the current character, not the previous one
Once the table is n+1 long, i stops being a position and becomes a length. That single
change is what makes s[i-1] read wrong at first glance: the -1 looks like “step back one
character”, but it is only the conversion from a length to the index of that length’s last
character.
dp[i]  = a claim about the FIRST i CHARACTERS  ->  i is a LENGTH (0 .. n)
s[j]   = the character sitting AT position j   ->  j is an INDEX  (0 .. n-1)

a prefix of length i ends at index i-1
        -> s[i-1] is the newest character inside dp[i]  ->  the CURRENT one
Line the two rows up once and the confusion goes away — they are off by one by construction, because the length row carries an extra “empty prefix” slot at the front:
s        =        0     1     0          (n = 3)
index    =        0     1     2          <- s is indexed 0..n-1
                  ^     ^     ^
dp slot  =  0     1     2     3          <- dp has n+1 slots
            |     |     |     |
           ""    "0"   "01"  "010"       <- the prefix dp[i] talks about
| loop step | i (length) |
prefix s[:i] |
its last char | val = s[i-1] |
|---|---|---|---|---|
| 1st | 1 | "0" |
'0' |
s[0] = '0' ✅ current |
| 2nd | 2 | "01" |
'1' |
s[1] = '1' ✅ current |
| 3rd | 3 | "010" |
'0' |
s[2] = '0' ✅ current |
s[i-1] is never the previous character — the previous character is s[i-2], and you almost
never need it, because everything already decided about it is folded into dp[i-1].
LC 926 (Flip String to Monotone Increasing) written in this view — dp[i] = min flips to make
the first i characters monotone increasing:
# LC 926 - Flip String to Monotone Increasing
# IDEA: dp[i] = min flips over the PREFIX OF LENGTH i, so the char decided at step i is s[i-1]
dp = [0] * (n + 1)          # n+1 slots: dp[0] = empty prefix = 0 flips
one_so_far = 0              # '1's kept so far in s[:i-1]

for i in range(1, n + 1):   # i = prefix LENGTH, not a position
    val = s[i - 1]          # the character being decided right now

    if val == '0':
        # keep this '0' -> every earlier kept '1' must flip -> one_so_far
        # flip this '0' -> 1 more than dp[i-1]
        dp[i] = min(one_so_far, dp[i - 1] + 1)
    else:
        dp[i] = dp[i - 1]   # a '1' at the end is always safe, costs nothing
        one_so_far += 1

return dp[n]                # dp[n], NOT dp[n-1]
Trace on s = "010":
i=1  val=s[0]='0'  dp[1]=min(one_so_far=0, dp[0]+1=1) = 0
i=2  val=s[1]='1'  dp[2]=dp[1]=0                 one_so_far -> 1
i=3  val=s[2]='0'  dp[3]=min(one_so_far=1, dp[2]+1=1) = 1
answer = dp[3] = 1     ("010" -> "011" or "000")
Three tells put you in the length view, and all three must agree — dp = [0] * (n + 1),
for i in range(1, n + 1), return dp[n]. Mix one of them with the index view and you either
read s[n] off the end of the string or silently skip its last character.
2. 處理「空」的初始條件
很多 DP 題需要一個代表「什麼都沒有」的初始條件(目標和 = 0、空字串等等)。
範例:
- 背包/Coin Change:需要
dp[target + 1],因為dp[0]代表總和 = 0 - 最長公共子序列:用
(n+1) x (m+1)的矩陣,第一列/第一行代表空字串
# LC 322: Coin Change
def coinChange(coins, amount):
    dp = [float('inf')] * (amount + 1)  # Need amount+1
    dp[0] = 0  # Base case: 0 coins needed for amount 0

    for i in range(1, amount + 1):  # Loop to amount+1
        for coin in coins:
            if i >= coin:
                dp[i] = min(dp[i], dp[i - coin] + 1)

    return dp[amount] if dp[amount] != float('inf') else -1
比較總結
| 特徵 | 迴圈 0 到 n |
迴圈 0 到 n+1 |
|---|---|---|
| 陣列大小 | new int[n] |
new int[n + 1] |
dp[i] 的意義 |
在元素 i 的結果 |
考慮前 i 個項目的結果 |
| 典型初始條件 | dp[0] 和 dp[1] |
dp[0] 是「空」狀態 |
| 存取方式 | dp[i] ↔ nums[i] |
dp[i] ↔ nums[i-1] |
| 最終答案 | dp[n - 1] |
dp[n] |
| 適用情境 | 直接對應到元素 | 計數/數量類題目、超出陣列的「目標」 |
並排比較:LC 70(Climbing Stairs)
# Style 1: Array size = n+1 (RECOMMENDED for this problem)
def climbStairs_v1(n):
    if n <= 2:
        return n

    dp = [0] * (n + 1)
    dp[1] = 1
    dp[2] = 2

    for i in range(3, n + 1):
        dp[i] = dp[i-1] + dp[i-2]

    return dp[n]

# Style 2: Array size = n (requires careful handling)
def climbStairs_v2(n):
    if n <= 2:
        return n

    dp = [0] * n
    dp[0] = 1  # 1 way to reach step 1
    dp[1] = 2  # 2 ways to reach step 2

    for i in range(2, n):
        dp[i] = dp[i-1] + dp[i-2]

    return dp[n-1]
注意:Climbing Stairs 用 n+1 的寫法比較直覺,因為:
dp[i]自然就代表「走到第 i 階的方法數」- 第
n階就是目標,所以dp[n]就是答案 - 不用在腦中一直把「第 i 階」換算成「索引 i-1」
Template 1b:前綴切分 DP — LC 139Priority 4 of 5 — High value — a gap here costs you rounds
Template 1a 的 n+1 尺寸就是為了這個形狀而存在的。dp[i] 講的是一段前綴長度的性質,
而不是「索引 i 上那個字元」——而且這是一維家族裡唯一一個轉移要檢查一整段 s[j:i]、
而不是像 dp[i-1]、dp[i-2] 那樣固定位移的模式。這家族其他題目只換掉一件事:套在那一段上的判斷。
🎯 模式(LC 139 — Word Break)
| 面向 | 內容 |
|---|---|
| 模式 | 前綴切分 — 外層迴圈跑前綴長度,內層迴圈跑切點 |
| 狀態 | dp[i] = 前 i 個字元 s[:i] 能不能被切成字典裡的單字? |
| base case | dp[0] = True — 空前綴天然成立 |
| 轉移 | dp[i] = OR over j < i of (dp[j] AND s[j:i] in dict) |
| 答案 | dp[n],不是 dp[n-1] — 表格有 n+1 格 |
| 複雜度 | O(n²) 個切點 × 每次 O(L) 的切片+雜湊 → 最差 O(n³),空間 O(n)(見下) |
💡 核心思路
猜最後一個單字。 如果 s[:i] 切得開,那不管怎麼切,它一定以某一個單字結尾。
那個單字佔住 s[j:i](j 是某個切點),而它前面的部分就是更小的子問題 s[:j] —— 而 dp[j] 早就算過了。
所以只要列舉最後一個單字所有可能的起點,然後問兩個問題:
        j                 i
s:  [ ---- dp[j] ---- ][ s[j:i] ]
      already solved     one word?
只要有某一個 j 讓兩個問題都成立,dp[i] 就是 true —— 這也是為什麼內層迴圈一命中就可以 break。
它是切點上的 OR,不是在數數量。
s = "leetcode", dict = {"leet", "code"}

i=0                     dp[0] = True   (base: empty prefix)
i=1..3   no j works     dp[1..3] = False
i=4      j=0: dp[0] AND "leet" in dict  -> dp[4] = True
i=5..7   no j works     dp[5..7] = False
i=8      j=4: dp[4] AND "code" in dict  -> dp[8] = True
                                           ^ answer = dp[n] = dp[8]
把 i 讀成邊界,不是字元。 i 是「已經切好」和「還沒看」之間的分界線,
所以它可以合法地走到 n —— 最後一個字元的再下一格。這正是 BFS 寫法丟進佇列的那個邊界,
也正是 dp 要開 n+1 格的原因。
程式碼
# python
# IDEA: PREFIX PARTITION DP — dp[i] = can s[:i] be cut into dictionary words
# LC 139 - Word Break
# time = O(n^2) cuts * O(L) slice+hash, space = O(n + dictionary)
class Solution(object):
    def wordBreak(self, s, wordDict):
        n = len(s)
        words = set(wordDict)          # set, not list — see the trap below

        dp = [False] * (n + 1)         # NOTE: n+1 slots, indexed by prefix LENGTH
        dp[0] = True                   # the empty prefix is always segmentable

        for i in range(1, n + 1):      # i = end boundary of the prefix
            for j in range(i):         # j = start of the candidate last word
                if dp[j] and s[j:i] in words:
                    dp[i] = True
                    break              # one valid cut is enough — it is an OR
        return dp[n]
// java
// IDEA: PREFIX PARTITION DP — dp[i] = can s[:i] be cut into dictionary words
// LC 139 - Word Break
// time = O(n^2) cuts * O(L) substring+hash, space = O(n + dictionary)
public boolean wordBreak(String s, List<String> wordDict) {
    int n = s.length();
    Set<String> words = new HashSet<>(wordDict);

    boolean[] dp = new boolean[n + 1];   // NOTE: n+1 slots, indexed by prefix LENGTH
    dp[0] = true;                        // the empty prefix is always segmentable

    for (int i = 1; i <= n; i++) {       // i = end boundary of the prefix
        for (int j = 0; j < i; j++) {    // j = start of the candidate last word
            if (dp[j] && words.contains(s.substring(j, i))) {
                dp[i] = true;
                break;                   // one valid cut is enough — it is an OR
            }
        }
    }
    return dp[n];
}
⚠️ 三個陷阱
- 直接對原本的 list 做
in wordDict。s[j:i] in wordDict如果wordDict是 list, 那是一次線性掃描、每一步還要做字串比較 —— 單次查詢 O(k·L),整體退化成 O(n²·k·L) 而 TLE。set(wordDict)讓它變成一次雜湊。這是「看起來正確的 Word Break」超時最常見的原因。 - 把字典迴圈放到外層。 內層迴圈是
range(i)—— 跑位置 —— 而不是for w in wordDict。 以單字驅動的內層迴圈是可以的(它讀到的仍然都是已經算完的格子);但以單字驅動的外層 迴圈不行,而且它會安靜地在題目自己的 Example 2 上出錯 ——"applepenapple"在"pen"的前後 都要用到"apple",而一輪迴圈只能把一個單字放一次。原因與五種寫法的對照: dp_loop_order.md。 - 尺寸開錯之後回傳
dp[-1]。 只開n格的話,dp[0] = True這個 base case 根本沒地方放, 於是每個答案都塌成False。
老實講複雜度
雙層迴圈是 O(n²) 次迭代,但每一次都要產生並雜湊一段子字串,長度最多到 n。把這件事算進去:
| 計費方式 | 上界 | 什麼時候該講這個 |
|---|---|---|
| 把切片+雜湊當成 O(1) | O(n²) | 面試時的慣用簡稱 |
| 老實算切片的成本 | O(n³) | Python s[j:i]/Java substring — 嚴格上界 |
內層迴圈只回看最長單字 L |
O(n·L²) | 下面那個優化;LC 139 保證 L ≤ 20 |
比字典裡最長的單字還長的「最後一個單字」永遠不可能命中,所以內層迴圈只需要往回看 L 個字元:
# python
# IDEA: same DP, inner loop capped by the longest word — O(n * L^2), effectively linear in n
L = max(map(len, words))
for i in range(1, n + 1):
    for j in range(max(0, i - L), i):
        if dp[j] and s[j:i] in words:
            dp[i] = True
            break
類似 LeetCode 題目
下面每一題都是同一個 dp[i] = f(dp[j], segment(j, i)) 骨架。只有段落判斷和合併運算子在變:
| 題目 | 對 s[j:i] 的段落判斷 |
合併 | 備註 |
|---|---|---|---|
| LC 139 Word Break | 是不是字典裡的單字? | OR | 上面的模板 |
| LC 140 Word Break II | 是不是字典裡的單字? | 收集 | 記憶化的是句子清單而不是布林值;從同一張表回溯 |
| LC 472 Concatenated Words | 是不是其他單字之一? | OR | 先依長度排序,字典裡就只會有嚴格更短的字 |
| LC 132 Palindrome Partitioning II | 是不是回文? | min(+1) |
先預處理回文表,然後跑一模一樣的切點迴圈 |
| LC 91 Decode Ways | 是不是合法的 1~2 位數編碼? | 加總 | 段落長度上限是 2,所以內層迴圈退化成 dp[i-1] + dp[i-2] |
| LC 279 Perfect Squares | i - j 是不是完全平方數? |
min(+1) |
同樣的形狀,只是跑在整數而不是字元上 |
| LC 1043 Partition Array for Max Sum | 這一段長度是不是 ≤ k? |
max |
要跟著 j 一起帶著這段的執行中最大值 |
| LC 322 Coin Change | i - j 是不是某個硬幣面額? |
min(+1) |
同一條遞迴式的完全背包寫法 |
不屬於這個模板:LC 131 Palindrome Partitioning 要列舉所有切法, 而不是判定其中一種,所以它是回溯 —— DP 能把問題壓成是非題或最佳值, 但沒辦法把指數多的輸出列舉得更快。LC 140 則是混血:先用 DP 證明切得開,再用回溯把它們列出來。
模板 2:二維格子 DP — LC 64Priority 5 of 5 — Must know — expect it in almost every loop
🎯 模式(LC 64 — Minimum Path Sum)
| 面向 | 內容 |
|---|---|
| 模式 | 二維格子 DP — 只能往右/往下走 |
| 狀態 | dp[i][j] = 從 (0, 0) 走到格子 (i, j) 的最小成本 |
| 轉移 | dp[i][j] = grid[i][j] + min(dp[i-1][j], dp[i][j-1]) |
| 初始條件 | 第一列:由左往右做前綴和;第一行:由上往下做前綴和 |
| 答案 | dp[m-1][n-1] |
| 時間 | O(m × n) |
| 空間 | 標準寫法 O(m × n),空間優化後 O(n) |
💡 核心想法
走到每個格子時,最小成本的路徑一定是從上面或左邊過來的(只能往右/往下走,所以只有兩種可能)。取兩者的最小值,再加上當前格子的值。
為什麼不需要 visited 陣列(跟 LC 1631 不同):
- 移動是單向的(只能往右/往下)→ 沒有環,不會重複走訪
- 每個格子按列優先順序恰好被算一次
- DP 自然地從左上填到右下
二維 DP 實作(標準版)
public int minPathSum(int[][] grid) {
    int m = grid.length;
    int n = grid[0].length;
    int[][] dp = new int[m][n];

    // Base: starting cell
    dp[0][0] = grid[0][0];

    // Base: first column — only one way (from above)
    for (int i = 1; i < m; i++)
        dp[i][0] = dp[i - 1][0] + grid[i][0];

    // Base: first row — only one way (from left)
    for (int j = 1; j < n; j++)
        dp[0][j] = dp[0][j - 1] + grid[0][j];

    // Fill rest: min of coming from above vs left
    for (int i = 1; i < m; i++)
        for (int j = 1; j < n; j++)
            dp[i][j] = grid[i][j] + Math.min(dp[i - 1][j], dp[i][j - 1]);

    return dp[m - 1][n - 1];
}
⚠️ LC 64 vs LC 1631:什麼時候用 DP、什麼時候用 Dijkstra
| LC 64 (Min Path Sum) | LC 1631 (Min Effort Path) | |
|---|---|---|
| 移動方向 | 只能往右 + 往下 | 四個方向都可以 |
| 成本 | 累加總和 | 各步高低差的最大值 |
| 會重走格子嗎? | 不會(單向) | 會(可能有更好的路徑) |
| 演算法 | 二維 DP | Dijkstra + min-heap |
需要 visited 嗎? |
不需要 | 需要 |
| DP 為什麼行得通 | 沒有環,是 DAG 結構 | DP 會失效:可以重走 |
規則:移動被限制成單向(往右/往下)→ 用二維 DP。四個方向都能走 → 用 Dijkstra(或帶優先佇列的 BFS)。
遞迴式目錄(二維)
| 題型 | 遞迴式 | 範例 | 時間 | 空間 |
|---|---|---|---|---|
| Unique Paths | dp[i][j] = dp[i-1][j] + dp[i][j-1] | LC 62 Unique Paths | O(m×n) | O(n) |
| Min Path Sum | dp[i][j] = min(dp[i-1][j], dp[i][j-1]) + grid[i][j] | LC 64 Min Path Sum | O(m×n) | O(n) |
| LCS | 相符則 dp[i][j] = dp[i-1][j-1] + 1,否則 max(…) | LC 1143 LCS | O(m×n) | O(n) |
| Edit Distance | dp[i][j] = min(插入, 刪除, 取代) | LC 72 Edit Distance | O(m×n) | O(n) |
Python 版寫法、原地變形、O(m) 滾動列寫法、由上而下的記憶化版本、四種做法的比較表、 類似題對照,以及
[[1,3,1],[1,5,1],[4,2,1]]的推演,都在 dp_advanced.md; 計數版的雙胞胎 LC 62(Unique Paths)在 dp_examples.md 有完整實作。
模板 2a:讀懂二維 DP 表格 — 形狀、相依、填表順序 Priority 5 of 5 — Must know — expect it in almost every loop
模板 2 是最輕鬆的二維情況:表格本身就是輸入的格子,dp[i][j] 早就被題目放好了。另外兩個二維
家族 — 區間 DP(模板 3、模板 10)與雙序列 DP(模板 8、模板 9)— 憑空生出一張題目沒有給你的表格,
而在那裡真正卡住人的很少是遞推式。是表格本身:它是什麼形狀、遞推式會讀到哪些格子,因此哪一種
迴圈順序才合法。 這一節是它們共用的地圖,底下的模板都預設你看過。
決定迴圈順序的那條規則
先把轉移式寫出來。右手邊每一個
dp[...]都是一支指進dp[i][j]的箭頭。一種迴圈順序 合法,當且僅當每支箭頭都落在已經填好的格子上。就只有這樣而已。
| 轉移式讀到 | 是哪個鄰居 | 迴圈就必須 |
|---|---|---|
dp[i-1][j] |
上一列 | i 遞增(1 → m) |
dp[i+1][j] |
下一列 | i 遞減(n-1 → 0) |
dp[i][j-1] |
左一行 | j 遞增(1 → n) |
dp[i][j+1] |
右一行 | j 遞減 |
dp[i+1][j-1] |
內縮後的區間(兩端各往內一格) | i 遞減且 j 遞增 |
dp[i][k]、dp[k][j](i < k < j) |
更短的區間 | 依區間長度遞增 |
這張表就是完整的決策流程,也就是為什麼 LC 516 的 i 要倒著跑、LC 72 的 i 要正著跑 — 不是風格,
不是喜好,只是每個遞推式讀到哪些鄰居而已。
這張表的一維版本 —— 外加迴圈順序的另一個軸,也就是 item 迴圈到底可不可以放在狀態迴圈 外面 —— 在 dp_loop_order.md。
我要蓋的是哪一種形狀?
What do i and j MEAN in dp[i][j]?

├── ONE sequence; i and j are the two ENDS of a sub-range s[i..j]
│      → Shape A — n × n, only the upper triangle is real,
│        base on the diagonal, answer at the TOP-RIGHT dp[0][n-1]
│        LC 516, 5, 647, 1312, 312, 877
│
├── TWO sequences; i and j are PREFIX LENGTHS (first i of s1, first j of s2)
│      → Shape B — (m+1) × (n+1), row 0 / column 0 are the empty prefixes,
│        answer at the BOTTOM-RIGHT dp[m][n]
│        LC 72, 1143, 115, 97, 10
│
└── a real grid handed to you; i and j are COORDINATES
       → Template 2 above — m × n, answer at dp[m-1][n-1]
         LC 62, 64, 221
形狀 A — 單一序列,i/j 是區間的兩端
狀態:dp[i][j] = 子區間 s[i..j] 的答案。
            j = 0      1        2      ...    n-1
  i = 0   [ base ] [   ?  ] [   ?  ]  ...  [ 🎯 dp[0][n-1] ]   ← the answer
      1   [ dead ] [ base ] [   ?  ]  ...  [      ?        ]
      2   [ dead ] [ dead ] [ base ]  ...  [      ?        ]
      :
    n-1   [ dead ] [ dead ] [ dead ]  ...  [    base       ]

  diagonal  i == j : the length-1 base case  (dp[i][i] = 1, or True)
  below it  i >  j : an empty range — never written, never read
  corner   (0, n-1): the whole sequence — this is what you return
相依關係 — 一個「兩端往內縮」的轉移會讀到的三個格子:
   the 2 x 2 window, drawn the same way up as the table above:

                        j-1              j
                  ┌──────────────┬──────────────┐
        row i     │  dp[i][j-1]  │   dp[i][j]   │  ← 🎯 being filled
                  ├──────────────┼──────────────┤
        row i+1   │ dp[i+1][j-1] │  dp[i+1][j]  │
                  └──────────────┴──────────────┘

   dp[i][j]  ⟵  dp[i][j-1]     →  from the LEFT      — drop the right end s[j]
   dp[i][j]  ⟵  dp[i+1][j]     ↑  from BELOW         — drop the left end  s[i]
   dp[i][j]  ⟵  dp[i+1][j-1]   ↗  from BELOW-LEFT    — drop BOTH ends

   Every arrow travels UP and to the RIGHT. Nothing arrives from above or from
   the right, so the table fills from the diagonal OUTWARD, toward the
   top-right corner.
順序 A — i 倒著走、j 正著走(就寫這個)
# python
# LC 516 - Longest Palindromic Subsequence
# IDEA: i descends so row i+1 is already done; j ascends so column j-1 is already done
# time = O(n^2), space = O(n^2)
n = len(s)
dp = [[0] * n for _ in range(n)]

for i in range(n):                 # base: one character is a palindrome of length 1
    dp[i][i] = 1

for i in range(n - 1, -1, -1):     # ↑ bottom row first
    for j in range(i + 1, n):      # → left to right, staying above the diagonal
        if s[i] == s[j]:
            dp[i][j] = dp[i + 1][j - 1] + 2
        else:
            dp[i][j] = max(dp[i + 1][j], dp[i][j - 1])

return dp[0][n - 1]
順序 B — 依區間長度(斜線掃描)
# python
# IDEA: same table, one diagonal at a time. The only order that works when the transition
#       needs a split point k (dp[i][k] and dp[k][j]) instead of the two ends.
# time = O(n^2) for a two-end transition, O(n^3) once a k-loop is nested inside
for length in range(2, n + 1):          # sub-range length: short → long
    for i in range(n - length + 1):     # left end
        j = i + length - 1              # right end is derived, never looped
        ...                             # same transition as Order A
兩種都合法 — 以下是格子實際被填的順序(n = 5)
   Order A  (i: n-1→0, j: i+1→n-1)        Order B  (length: 2→n, i: 0→n-length)
          j0   j1   j2   j3   j4                  j0   j1   j2   j3   j4
    i0     ·    7    8    9   10            i0     ·    1    5    8   10
    i1          ·    4    5    6            i1          ·    2    6    9
    i2               ·    2    3            i2               ·    3    7
    i3                    ·    1            i3                    ·    4
    i4                         ·            i4                         ·

    row by row, bottom → top                diagonal by diagonal, ↗

  Check the corner cell dp[0][4] — step 10 in both orders.
  It reads dp[1][3], dp[1][4], dp[0][3]:
    Order A → steps 5, 6, 9   ✅ all filled before step 10
    Order B → steps 6, 9, 8   ✅ all filled before step 10
怎麼選:轉移移動的是兩端(dp[i+1][j-1]、dp[i+1][j]、dp[i][j-1])就用順序 A — 回文、
拿字串跟自己的反轉取 LCS。轉移需要區間內部的切點 k(dp[i][k] + dp[k][j])就用順序 B —
戳氣球、合併石頭、矩陣連乘 — 因為在那裡「已經填好」指的是嚴格更短,而只有依長度驅動的迴圈保證
得了這件事。
實際填好的表 — LC 516,s = "bbbab"
   s =       b    b    b    a    b
             j0   j1   j2   j3   j4
   b   i0  [ 1 ][ 2 ][ 3 ][ 3 ][ 4 ]  ← 🎯 answer = 4
   b   i1    ·  [ 1 ][ 2 ][ 2 ][ 3 ]
   b   i2    ·    ·  [ 1 ][ 1 ][ 3 ]
   a   i3    ·    ·    ·  [ 1 ][ 1 ]
   b   i4    ·    ·    ·    ·  [ 1 ]

   dp[2][3] = 1 : 'b' != 'a'      → max(dp[3][3]=1, dp[2][2]=1) = 1
   dp[0][2] = 3 : s[0]=='b'==s[2] → dp[1][1] + 2 = 3          ("bbb")
   dp[1][3] = 2 : 'b' != 'a'      → max(dp[2][3]=1, dp[1][2]=2) = 2
   dp[0][4] = 4 : s[0]=='b'==s[4] → dp[1][3] + 2 = 4          ("bbbb")
它到底往哪邊走?— 反向走回表格
正向那一趟存下來的是數值。決策是事後在每個格子重問一次「這個值是哪個鄰居給的」還原出來的 — 不需要父指標,把轉移重算一次就好:
   at (0,4)  s[0]=='b'==s[4]           → matched pair: take both, jump ↘ to (1,3)
   at (1,3)  'b' != 'a', and
             dp[1][2]=2 > dp[2][3]=1   → the max came from the LEFT: drop s[3], move to (1,2)
   at (1,2)  s[1]=='b'==s[2]           → matched pair: take both, jump ↘ to (2,1)
   at (2,1)  i > j                     → empty range: stop

   pairs collected, outer → inner:  (s0, s4) then (s1, s2)
   answer string:   b [ b  b ] b   =  "bbbb"   ✓ length 4 = dp[0][4]
形狀 A 的題目
| 題目 | s[i] == s[j] 時 |
否則 |
|---|---|---|
| LC 516 Longest Palindromic Subsequence | dp[i+1][j-1] + 2 |
max(dp[i+1][j], dp[i][j-1]) |
| LC 5 Longest Palindromic Substring | j - i <= 2 或 dp[i+1][j-1] 時為 True |
False |
| LC 647 Palindromic Substrings | 判斷同 LC 5,數有幾個 True |
False |
| LC 1312 Min Insertions to Make Palindrome | dp[i+1][j-1] |
1 + min(dp[i+1][j], dp[i][j-1]) |
有兩題完全沒有字元比對,而它們正好就是替你決定填表順序的那種:
- LC 312(Burst Balloons)— 有切點,所以只有順序 B 能用:
dp[i][j] = max over k in (i, j) of dp[i][k] + dp[k][j] + b[i]*b[k]*b[j]。模板 3 有完整解法。 - LC 877 / LC 486(Stone Game / Predict the Winner)— 同一個三角形,但
dp[i][j]裝的是 分數差:max(nums[i] - dp[i+1][j], nums[j] - dp[i][j-1])。動的是兩端,所以用順序 A。 minimax 的推理在 dp_advanced.md。
形狀 B — 雙序列,i/j 是前綴長度
狀態:dp[i][j] = s1 的前 i 個字元與 s2 的前 j 個字元的答案。所以這個格子在決定的
字元是 s1[i-1] 與 s2[j-1] — 大家都會踩到的那個差一,只是第 0 列/第 0 行代表空前綴的後果。
                  ""     s2[0]  s2[1]   ...   s2[n-1]
             j =   0       1      2     ...      n
   ""    i =  0  [base] [base] [base]  ...  [ base ]   ← s1 is empty
  s1[0]       1  [base] [  ?  ][  ?  ] ...  [  ?   ]
  s1[1]       2  [base] [  ?  ][  ?  ] ...  [  ?   ]
    :
  s1[m-1]     m  [base] [  ?  ][  ?  ] ...  [ 🎯 dp[m][n] ]  ← the answer

  row 0 / column 0 : one string is empty, so the answer is FORCED, not computed
  every other cell : three neighbours, one decision
相依關係 — 三支箭頭,全都從上方/左方/左上方過來:
   the same 2 x 2 window, one row higher:

                        j-1              j
                  ┌──────────────┬──────────────┐
        row i-1   │ dp[i-1][j-1] │  dp[i-1][j]  │
                  ├──────────────┼──────────────┤
        row i     │  dp[i][j-1]  │   dp[i][j]   │  ← 🎯 being filled
                  └──────────────┴──────────────┘

   dp[i][j]  ⟵  dp[i-1][j-1]   ↘  from ABOVE-LEFT   — consume from BOTH strings
   dp[i][j]  ⟵  dp[i-1][j]     ↓  from ABOVE        — consume from s1 only
   dp[i][j]  ⟵  dp[i][j-1]     →  from the LEFT     — consume from s2 only

   Nothing arrives from below or from the right, so plain row-major
   (i: 1 → m, inner j: 1 → n) is legal — and it is the only order anyone writes.
每一步各代表什麼 — 遞推式會隨題目改變,幾何永遠不變:
| 走法 | 讀到的格子 | 意義 | LC 72(編輯距離) | LC 1143(LCS) |
|---|---|---|---|---|
| ↘ 對角 | dp[i-1][j-1] |
兩邊各吃掉一個字元 | 相同免費,否則取代(+1) |
相同就 +1 |
| ↓ 垂直 | dp[i-1][j] |
只吃 s1 一個字元 |
刪除 s1[i-1](+1) |
跳過 s1[i-1] |
| → 水平 | dp[i][j-1] |
只吃 s2 一個字元 |
插入 s2[j-1](+1) |
跳過 s2[j-1] |
# python
# LC 72 - Edit Distance
# IDEA: Shape B — base row/col are the forced answers, then row-major over three neighbours
# time = O(m * n), space = O(m * n)  → O(min(m, n)) once rolled
m, n = len(s1), len(s2)
dp = [[0] * (n + 1) for _ in range(m + 1)]

for i in range(m + 1):
    dp[i][0] = i          # s2 empty → delete every character of s1
for j in range(n + 1):
    dp[0][j] = j          # s1 empty → insert every character of s2

for i in range(1, m + 1):
    for j in range(1, n + 1):
        if s1[i - 1] == s2[j - 1]:
            dp[i][j] = dp[i - 1][j - 1]          # ↘ free
        else:
            dp[i][j] = 1 + min(
                dp[i - 1][j],                    # ↓ delete
                dp[i][j - 1],                    # → insert
                dp[i - 1][j - 1],                # ↘ replace
            )

return dp[m][n]
基底那一列才是 bug 的住處。 編輯距離是
dp[i][0] = i,LCS 是0,LC 115 是1— 空字串是 任何字串的子序列,而且恰好一次。要用推的,不要用抄的:把i = 0代進你自己的狀態句子,再用白話 把答案唸出來。
實際填好的表 — LC 72,"horse" → "ros",含它選的那條路
              ""    r     o     s
        ""  [ 0*]   1     2     3
        h   [ 1 ] [ 1*]   2     3
        o   [ 2 ]   2   [ 1*]   2
        r   [ 3 ]   2   [ 2*]   2
        s   [ 4 ]   3     3   [ 2*]
        e   [ 5 ]   4     4   [ 3*]   ← 🎯 dp[5][3] = 3

   * = the cells on the chosen path, recovered by walking backwards from dp[5][3]:

   (5,3) 'e' vs 's' ✗   1 + min(↓ dp[4][3]=2, → dp[5][2]=4, ↘ dp[4][2]=3)
                        the min came from ↓   ⇒ DELETE 'e'
   (4,3) 's' == 's' ✓   free ↘                ⇒ KEEP 's'
   (3,2) 'r' vs 'o' ✗   1 + min(↓ dp[2][2]=1, → dp[3][1]=2, ↘ dp[2][1]=2)
                        the min came from ↓   ⇒ DELETE 'r'
   (2,2) 'o' == 'o' ✓   free ↘                ⇒ KEEP 'o'
   (1,1) 'h' vs 'r' ✗   1 + min(↓ dp[0][1]=1, → dp[1][0]=1, ↘ dp[0][0]=0)
                        the min came from ↘   ⇒ REPLACE 'h' → 'r'
   (0,0) both prefixes empty                  ⇒ stop

   replayed forwards:   replace h→r   "horse" → "rorse"
                        keep    o
                        delete  r     "rorse" → "rose"
                        keep    s
                        delete  e     "rose"  → "ros"    ✓ 3 ops = dp[5][3]
用幾何的方式讀這條路:↘ 代表某個字元活了下來,↓ 代表花掉 s1 的一個字元,→ 代表花掉 s2 的
一個字元。 同樣這一趟反向走法套在 LC 1143 的表上,拼出來的就不是操作清單,而是真正的最長公共
子序列 — 同一張表、同一趟走法,只是沿路記下來的東西不同。
空間壓縮 — 以及什麼時候沒得壓
dp[i][j] 只會讀到第 i 列與第 i-1 列,所以形狀 B 可以塌成兩列,再塌成一列加一個純量
(用來接住那個即將被覆蓋掉的對角值):
# python
# IDEA: rolling row — prev is row i-1, cur is row i. s2 is the inner axis, so pass the
#       SHORTER string as s2.
# time = O(m * n), space = O(min(m, n))
prev = list(range(n + 1))
for i in range(1, m + 1):
    cur = [i] + [0] * n
    for j in range(1, n + 1):
        cur[j] = prev[j - 1] if s1[i - 1] == s2[j - 1] else 1 + min(prev[j], cur[j - 1], prev[j - 1])
    prev = cur
return prev[n]
形狀 A 壓不了。 dp[i][j] 讀的是第 i+1 列的兩個不同行(j-1 和 j),而斜線掃描又會一直
往回摸到更早的每一條斜線 — 根本沒有「最近兩列」這個可以留著的視窗。區間 DP 就編列 O(n²),然後往
下走。
還有,只要你需要反向回溯就完全不要壓:滾動列丟掉的,剛好就是反向那一趟要讀的格子。只要答案是那條 路徑而不是那個數字,就把整張表留著(或把每個格子選了哪一步記下來)。
形狀 B 的題目
| 題目 | s1[i-1] == s2[j-1] 時 |
否則 |
|---|---|---|
| LC 72 Edit Distance | dp[i-1][j-1] |
1 + min(dp[i-1][j], dp[i][j-1], dp[i-1][j-1]) |
| LC 1143 Longest Common Subsequence | dp[i-1][j-1] + 1 |
max(dp[i-1][j], dp[i][j-1]) |
| LC 115 Distinct Subsequences | dp[i-1][j-1] + dp[i-1][j] |
dp[i-1][j] |
還有兩題住在同一張網格上,卻沒有 s1 跟 s2 互比字元這件事:
- LC 97(Interleaving String)— 布林值,而且是拿去跟第三個字串比:
dp[i][j] = (dp[i-1][j] and s1[i-1] == s3[i+j-1]) or (dp[i][j-1] and s2[j-1] == s3[i+j-1])。 完全沒有對角線 — 只有 ↓ 和 →,這正是「每個字元恰好來自兩個來源之一」的形狀。 - LC 10(Regular Expression Matching)—
j軸是樣式。一般字元或.就是普通的 ↘;'*'會 裂成「零份」dp[i][j-2]與「再多一份」dp[i-1][j],兩者讀的仍然只有左邊和上面,所以照列掃還是 成立。
二維 DP 速查表
| 形狀 A — 單一序列 | 形狀 B — 雙序列 | 模板 2 — 真的格子 | |
|---|---|---|---|
dp[i][j] 的意思 |
區間 s[i..j] |
s1 前 i 個 vs s2 前 j 個 |
座標 (i, j) 這一格 |
| 表格大小 | n × n,上三角 |
(m+1) × (n+1) |
m × n |
| 基底情況 | 對角線 dp[i][i] |
第 0 列與第 0 行 | 第一列與第一行 |
| 答案在哪 | 右上角 dp[0][n-1] |
右下角 dp[m][n] |
右下角 dp[m-1][n-1] |
| 讀到 | dp[i+1][j-1]、dp[i+1][j]、dp[i][j-1] |
dp[i-1][j-1]、dp[i-1][j]、dp[i][j-1] |
dp[i-1][j]、dp[i][j-1] |
| 迴圈順序 | i: n-1 → 0、j: i+1 → n-1(或依長度) |
i: 1 → m、j: 1 → n |
i: 0 → m-1、j: 0 → n-1 |
| 時間/空間 | O(n²) / O(n²) — 有切點時 O(n³) | O(m·n) / 滾動後 O(min(m,n)) | O(m·n) / 滾動後 O(n) |
| 代表題 | LC 516、5、647、1312、312 | LC 72、1143、115、97 | LC 62、64、221 |
真正會毀掉這張表的四個錯
- 填錯方向。 形狀 A 的
i一定要遞減;寫成for i in range(n)會在dp[i+1][...]還是0的時候就去讀它,答案於是悄悄偏小 — 不會爆、不會有索引錯誤。方向請從上面那張箭頭表推出來,不要 用背的。 - 踩進死掉的三角形。 形狀 A 裡當
j == i + 1時,dp[i+1][j-1]就是dp[i+1][i],在對角線 下方。它天生是0/False— 這對 LC 516 剛好正確(0 + 2 = 2,兩個字元的回文),對 LC 5 卻是錯的,那正是後者需要明確寫出j - i <= 2這個護欄的原因。 - 把別題的基底列抄過來。 同一個形狀裡,
0、i、1對不同題目都各自是正確的基底列 — 見上面 那段提醒。 - 還沒確定只要數字就先壓空間。 滾動列只有在答案是一個值的時候才是免費的;追問一變成「那是哪些 操作?」,你就得把整張表要回來。
模板 3:區間 DP — LC 312
這張表是形狀 A —
n × n、上三角、答案在右上角。它的骨架、兩種合法的填表順序,以及為什麼有 切點就只能用依長度驅動的那一種,都在 模板 2a。
🎯 關鍵洞見:想的是哪個元素最後處理,不是最先處理!
這就是區間 DP 類題目的招牌特徵,像 Burst Balloons、矩陣連乘,以及其他操作順序會影響結果的題目。
核心模式:
- 狀態:
dp[i][j]= 區間(i, j)的最佳值(通常是開區間) - 轉移:對
(i, j)裡的每個元素k,假設k是最後處理的 - 為什麼是「最後」? 當
k最後處理時,左右兩邊的子問題彼此獨立
三層巢狀迴圈結構:
for length in [2, 3, ..., n+1]:        # Build from small to large intervals
    for left in [0, 1, ..., n-length]: # Try all possible left boundaries
        right = left + length           # Calculate right boundary
        for k in [left+1, ..., right-1]: # Try each element as LAST
            # dp[left][right] = combine(dp[left][k], dp[k][right], cost)
Burst Balloons — LC 312(開區間邊界)
題目:戳破所有氣球,讓得到的硬幣最多。戳破氣球 i 可得 nums[i-1] * nums[i] * nums[i+1] 枚硬幣。
關鍵洞見:
- 前後補上邊界
[1, ...nums..., 1],省掉邊界情況判斷 dp[i][j]= 戳破i和j之間(不含兩端)所有氣球的最大硬幣數- 當
k是(i, j)裡最後被戳破的氣球時,它的鄰居就是i和j
為什麼成立:
- 如果想的是「先戳哪顆?」,題目會很難,因為鄰居一直在變
- 如果想的是「最後戳哪顆?」,當我們最後才戳
k:(i, k)裡的氣球都已經沒了 → 子問題dp[i][k](k, j)裡的氣球都已經沒了 → 子問題dp[k][j]- 只剩
i、k、j→ 硬幣 =balloons[i] * balloons[k] * balloons[j]
Python 實作:
def maxCoins(nums):
    """LC 312: Burst Balloons - Classic Interval DP"""
    n = len(nums)

    # Step 1: Add boundary balloons with value 1
    balloons = [1] + nums + [1]

    # Step 2: dp[i][j] = max coins from bursting balloons between i and j (exclusive)
    dp = [[0] * (n + 2) for _ in range(n + 2)]

    # Step 3: Build from small intervals to large
    for length in range(2, n + 2):  # length of interval
        for left in range(n + 2 - length):  # left boundary
            right = left + length  # right boundary

            # Step 4: Try each balloon k as the LAST to burst in (left, right)
            for k in range(left + 1, right):
                # Coins from bursting k last (only left, k, right remain)
                coins = balloons[left] * balloons[k] * balloons[right]
                # Add coins from left and right subproblems
                total = coins + dp[left][k] + dp[k][right]
                dp[left][right] = max(dp[left][right], total)

    # Answer: burst all balloons between boundaries 0 and n+1
    return dp[0][n + 1]
Java 實作:
// LC 312: Burst Balloons
public int maxCoins(int[] nums) {
    int n = nums.length;

    // Add boundaries: [1, ...nums..., 1]
    int[] balloons = new int[n + 2];
    balloons[0] = 1;
    balloons[n + 1] = 1;
    for (int i = 0; i < n; i++) {
        balloons[i + 1] = nums[i];
    }

    // dp[i][j] = max coins from bursting balloons between i and j (exclusive)
    int[][] dp = new int[n + 2][n + 2];

    // Iterate over interval lengths (from 2 up to n+1)
    for (int len = 2; len <= n + 1; len++) {
        // i is the left boundary
        for (int i = 0; i <= n + 1 - len; i++) {
            int j = i + len; // j is the right boundary

            // Pick k as the LAST balloon to burst in interval (i, j)
            for (int k = i + 1; k < j; k++) {
                int currentCoins = balloons[i] * balloons[k] * balloons[j];
                int total = currentCoins + dp[i][k] + dp[k][j];
                dp[i][j] = Math.max(dp[i][j], total);
            }
        }
    }

    return dp[0][n + 1];
}
這個模式的關鍵特徵
| 面向 | 內容 |
|---|---|
| 狀態定義 | dp[i][j] = 區間 (i, j) 或 [i, j] 的最佳值 |
| 迴圈順序 | 長度(最外層)→ 左邊界 → 分割點 k |
| 轉移 | 逐一試每個 k 當作最後處理的元素 |
| 時間複雜度 | O(n³) — 三層巢狀迴圈 |
| 空間複雜度 | O(n²) — 二維 DP 表 |
| 關鍵洞見 | 依相依關係的反序處理元素 |
常見的同模式題目
| 題目 | LC # | 關鍵技巧 | 難度 |
|---|---|---|---|
| Burst Balloons | 312 | 最後戳破的氣球 | Hard |
| Matrix Chain Multiplication | N/A | 最後做的那次乘法 | Classic |
| Minimum Cost to Merge Stones | 1000 | 最後的那次合併 | Hard |
| Remove Boxes | 546 | 最後移除的盒子 | Hard |
| Palindrome Partitioning II | 132 | 最少切幾刀(變形) | Hard |
| Strange Printer | 664 | 最後印出的字元 | Hard |
閉區間邊界的變形、由上而下的記憶化版本、
nums = [3,1,5,8]的完整推演、 辨認清單、常見錯誤、O(n³)/O(n²) 的推導、抽象的分割點/矩陣連乘骨架, 以及「i 倒著跑、j 正著跑」的迴圈順序規則,都在 dp_advanced.md。
模板 4:0/1 背包 — LC 416Priority 5 of 5 — Must know — expect it in almost every loop
🎯 核心想法
0/1 背包 = 每件物品最多拿一次(0 次或 1 次)。
給一組物品(各有重量與價值)和一個容量,求在不超過容量且每件物品最多用一次的前提下,能裝出的最大價值。
| 面向 | 內容 |
|---|---|
| 狀態 | dp[w] = 容量恰好為 w 時能達到的最佳價值 |
| 轉移 | dp[w] = max(dp[w], dp[w - weight[i]] + value[i]) |
| 迴圈順序 | 外層:物品;內層:容量倒著跑(W → weight[i]) |
| 為什麼要倒著跑 | 避免同一趟裡同一件物品被用兩次 |
| 時間 | O(n × W) |
| 空間 | 一維優化後 O(W) |
💡 為什麼內層迴圈非倒著跑不可?
這是 0/1 背包最關鍵的細節。
直覺:在一維 DP 陣列裡,處理物品 i 時,我們需要 dp[w - weight[i]] 仍然反映還沒考慮物品 i 之前的狀態。如果正著跑,較小索引 dp[w - weight[i]] 會在同一趟裡先被更新,於是後面的 dp[w] 就會讀到它 — 等於把物品 i 用了兩次。
具體推演 — LC 416,nums = [3],target = 6:
# Goal: can we pick some numbers that sum to 6?
# Only num = 3 is available, so the answer should be False.

dp = [True, False, False, False, False, False, False]
        0      1      2      3      4      5      6

❌ Forward iteration (WRONG):
   for s in range(3, 7):       # 3, 4, 5, 6
       dp[s] = dp[s] or dp[s - 3]

   s=3: dp[3] = dp[0] = True   ← 3 used once (ok so far)
   s=6: dp[6] = dp[3] = True   ← dp[3] was just SET by the same num!
                                   This counts 3 twice: 3 + 3 = 6 ❌

✅ Backward iteration (CORRECT):
   for s in range(6, 2, -1):   # 6, 5, 4, 3
       dp[s] = dp[s] or dp[s - 3]

   s=6: dp[6] = dp[3] = False  ← dp[3] is still its OLD value ✓
   s=5: dp[5] = dp[2] = False
   s=4: dp[4] = dp[1] = False
   s=3: dp[3] = dp[0] = True   ← 3 used once ✓

   Result: dp[6] = False  ✓ Correct!
關鍵不變量:倒著跑時計算 dp[s],dp[s - num] 在這一輪還沒被動過,所以它仍然是「還沒用物品 i」的值。這就保證每件物品最多用一次。
程式模板
# python — general 0/1 Knapsack (max value)
# time = O(n * W), space = O(W)
def knapsack_01(weights, values, capacity):
    dp = [0] * (capacity + 1)
    for i in range(len(weights)):
        for w in range(capacity, weights[i] - 1, -1):   # backward!
            dp[w] = max(dp[w], dp[w - weights[i]] + values[i])
    return dp[capacity]


# python — LC 416 (boolean variant: can we reach sum target?)
# time = O(n * target), space = O(target)
def canPartition(nums):
    total = sum(nums)
    if total % 2:
        return False
    target = total // 2

    dp = [False] * (target + 1)
    dp[0] = True                             # empty subset sums to 0

    for num in nums:
        for s in range(target, num - 1, -1): # backward!
            dp[s] = dp[s] or dp[s - num]

    return dp[target]
// java — general 0/1 Knapsack (max value)
// time = O(n * W), space = O(W)
public int knapsack01(int[] weights, int[] values, int W) {
    int[] dp = new int[W + 1];
    for (int i = 0; i < weights.length; i++) {
        for (int w = W; w >= weights[i]; w--) {   // backward!
            dp[w] = Math.max(dp[w], dp[w - weights[i]] + values[i]);
        }
    }
    return dp[W];
}

// java — LC 416 (boolean variant)
public boolean canPartition(int[] nums) {
    int total = 0;
    for (int n : nums) total += n;
    if (total % 2 != 0) return false;
    int target = total / 2;

    boolean[] dp = new boolean[target + 1];
    dp[0] = true;

    for (int num : nums) {
        for (int s = target; s >= num; s--) {     // backward!
            dp[s] = dp[s] || dp[s - num];
        }
    }
    return dp[target];
}
什麼時候用 0/1 背包
| 題目裡的訊號 | 為什麼代表 0/1 背包 |
|---|---|
| 「每個元素最多用一次」 | 直接就是 0/1 限制 |
| 「把陣列切成兩個子集」 | 化簡成:子集和能不能等於 total/2? |
| 「讓兩組的差最小/最大」 | 分割 → 背包 |
| 「給每個數加上 + 或 −,湊出目標」 | LC 494 的隱藏背包 |
| 「在預算內挑東西」 | 經典的背包敘事 |
快速判斷:物品不能重複使用 → 0/1 背包,內層迴圈倒著跑。
0/1 背包 vs 完全背包
| 0/1 背包 | 完全背包 | |
|---|---|---|
| 重複使用 | 每件最多一次 | 每件可無限次 |
| 內層迴圈方向 | 倒著跑(W → weight) |
正著跑(weight → W) |
| 範例 | LC 416, 494, 1049 | LC 322, 518 |
| 方向為何不同 | 倒著跑讀到的是舊的 dp[w-weight] | 正著跑讀到的是新的 dp[w-weight](因此允許重複用) |
類似的 LeetCode 題目
| LC # | 題目 | 變形 | 關鍵轉換 |
|---|---|---|---|
| 416 | Partition Equal Subset Sum | 布林 | dp[s] = 湊得出總和 s 嗎? |
| 494 | Target Sum | 計數 | sum1 = (total + target) / 2;數子集個數 |
| 1049 | Last Stone Weight II | 整數 | 求 ≤ total/2 的最大子集和 |
| 474 | Ones and Zeroes | 二維容量 | dp[i][j] = 用 ≤ i 個 0、≤ j 個 1 時最多能取幾個字串 |
| 879 | Profitable Schemes | 二維容量 | dp[profit][members] 計數 |
| 2915 | Length of Longest Subsequence | 布林 | 同樣的倒著跑模式 |
遞迴式目錄(背包)
| 變形 | 狀態定義 | 轉移 | 範例 |
|---|---|---|---|
| 0/1 背包 | dp[i][w] = 用前 i 件物品、重量 w 時的最大價值 | dp[i][w] = max(dp[i-1][w], dp[i-1][w-weight[i]] + value[i]) | LC 416 Partition |
| 完全背包 | dp[w] = 重量 w 時的最大價值 | dp[w] = max(dp[w], dp[w-weight[i]] + value[i]) | LC 322 Coin Change |
| 多重背包 | dp[i][w],每件物品有數量上限 | 用二進位拆分把每件物品拆成 0/1 副本,再做 0/1 背包 | LC 2585 Ways to Earn Points |
迴圈順序速查表 → knapsack.md
背包家族的一切都由兩個選擇決定:哪個迴圈在外層,以及內層迴圈往哪個方向跑。 把這張表背起來;每一列背後的道理都在 knapsack.md。
| 目標 | 外層迴圈 | 內層迴圈 | 遞迴式 | LC |
|---|---|---|---|---|
| 0/1 — 每件最多一次 | 物品 | 容量,倒著跑 | dp[w] = max(dp[w], dp[w-wt] + val) |
416, 494, 1049 |
完全背包,數組合 — {1,2} == {2,1} |
物品 | 金額,正著跑 | dp[a] += dp[a-coin] |
518 |
完全背包,數排列 — {1,2} != {2,1} |
金額 | 物品 | dp[a] += dp[a-coin] |
377 |
| 完全背包,求最小/最大 — 順序無關 | 都可以 | 都可以 | dp[a] = min(dp[a], dp[a-coin] + 1) |
322, 279 |
快速判斷:物品不能重複使用 → 0/1,內層倒著跑。可以重複使用 → 完全背包,內層正著跑; 接著再問順序有沒有差,來決定迴圈的巢狀順序。
想更深入 — 子集和的化簡(LC 416 / 494 / 1049)、完全背包與多重背包的變形, 以及組合 vs 排列的迴圈順序規則,全都在 knapsack.md; 0/1 背包的繁體中文詳解在 knapsack_01_zh.md。 這個模板加上上面那張辨認表就是值得背下來的部分;其餘當參考資料查就好。
模板 5:狀態機 DP — LC 121 / LC 309
整個 LC 121/122/123/188/309/714 家族 — 每個變形、每種狀態數 — 都在 stock_trading.md 有完整實作。下面只留兩個值得背的形狀。
def state_machine_dp(prices, fee=0):
    """DP with multiple states (stock problems)"""
    if not prices:
        return 0

    n = len(prices)
    # States: hold stock, not hold stock
    hold = -prices[0]
    cash = 0

    for i in range(1, n):
        # Transition between states
        prev_hold = hold
        hold = max(hold, cash - prices[i])  # Buy
        cash = max(cash, prev_hold + prices[i] - fee)  # Sell

    return cash
含冷卻期 — LC 309
def state_machine_with_cooldown(prices):
    """
    DP with 3 states for stock with cooldown

    State Definition:
    - hold: Currently holding a stock
    - sold: Just sold a stock today (enters cooldown)
    - rest: In cooldown or doing nothing (not holding stock)

    Key Constraint: After selling, must cooldown for 1 day before buying again
    """
    if not prices:
        return 0

    # Initialize states
    hold = -prices[0]  # Buy on day 0
    sold = 0           # Can't sell on day 0
    rest = 0           # Doing nothing

    for i in range(1, len(prices)):
        prev_sold = sold

        # State transitions
        # 1. SOLD: Sell today (must have held yesterday)
        sold = hold + prices[i]

        # 2. HOLD: Either continue holding OR buy today (after cooldown)
        hold = max(hold, rest - prices[i])

        # 3. REST: rest: either stayed in rest, or just came out of sold cooldown
        rest = max(rest, prev_sold)

    # Max profit when not holding stock
    return max(sold, rest)
模板 6:記憶化 → 表格化 → 滾動變數 — LC 198Priority 5 of 5 — Must know — expect it in almost every loop
空間優化的階梯:先寫遞迴,加上快取,翻成表格,最後把表格塌縮成
k個變數。 recursion_to_dp.md 詳細走過前兩階。
第 1 步 — 由上而下的記憶化
def top_down_dp(nums):
    """Top-down DP with memoization"""
    memo = {}

    def dp(i):
        # Base case
        if i < 0:
            return 0
        if i == 0:
            return nums[0]

        # Check memo
        if i in memo:
            return memo[i]

        # Recurrence relation
        result = max(dp(i-1), dp(i-2) + nums[i])
        memo[i] = result
        return result

    return dp(len(nums) - 1)
第 2 步 — 把表格塌縮成 k 個滾動變數
def fibonacci_variants():
    """Common Fibonacci-like patterns"""

    # 1. Classic Fibonacci
    def fibonacci(n):
        if n <= 1:
            return n
        prev2, prev1 = 0, 1
        for _ in range(2, n + 1):
            current = prev1 + prev2
            prev2, prev1 = prev1, current
        return prev1

    # 2. Climbing Stairs
    def climbStairs(n):
        if n <= 2:
            return n
        prev2, prev1 = 1, 2
        for _ in range(3, n + 1):
            current = prev1 + prev2
            prev2, prev1 = prev1, current
        return prev1
回傳滾動變數,不要回傳迴圈裡的暫存變數 — LC 198 Priority 5 of 5 — Must know — expect it in almost every loop
更新區塊會多出第三個名字 cur(剛算出來的 dp[i])。函式結尾很容易想 return cur —
畢竟它是最後算出來的值。但要回傳的是最新的那個滾動變數。
# python
# LC 198 - House Robber
# IDEA: dp[i] = max(dp[i-1], dp[i-2] + nums[i]) -> only 2 vars needed
# time = O(n), space = O(1)
def rob(nums):
    if not nums:
        return 0
    n = len(nums)
    if n == 1:
        return nums[0]          # p2's seed reads nums[1], so n == 1 must leave early

    # invariant at the top of iteration i:  p1 = dp[i-2],  p2 = dp[i-1]
    p1 = nums[0]                        # dp[0]
    p2 = max(nums[0], nums[1])          # dp[1]

    for i in range(2, n):
        cur = max(p1 + nums[i], p2)     # dp[i]
        p1 = p2                         # oldest -> newest
        p2 = cur

    return p2                           # NOT `cur`
為什麼是 p2 而不是 cur:
cur有可能根本沒被綁定。 當n == 2,迴圈是range(2, 2)— 空的 — 迴圈體從未執行,cur從未被建立。這時return cur會在一個完全合法的輸入([2, 7] -> 7)上丟出UnboundLocalError。p2在迴圈之前就初始化了,所以永遠存在。p2攜帶不變量,cur沒有。p2 = dp[最後算過的索引]在初始化那幾行之後成立, 每輪迴圈之後也成立。cur只代表「最近一輪算出來的值」— 那是對迴圈的描述,不是對答案的描述。- 兩者都有定義時,它們是相等的。 迴圈體的最後一行是
p2 = cur,所以只要cur存在,p2 == cur。p2在嚴格更多的情況下是對的,而且不用付任何代價。
所以這條規則可以推廣到這題之外:答案要放在一個迴圈開始前就已經合法的變數裡,
而那正好就是最新的滾動變數。LC 70 也是同樣的道理(return p2,不是迴圈裡的 cur),
本節其他所有固定視窗遞迴式也一樣。
n = 2, nums = [2, 7]

  p1 = 2                  <- dp[0]
  p2 = max(2, 7) = 7      <- dp[1]
  for i in range(2, 2):   <- zero iterations, `cur` never assigned

  return p2  -> 7         ✅
  return cur -> UnboundLocalError  ❌
Java 用另一套裝扮呈現同一個 bug — 宣告在迴圈外的 cur 需要一個假的初值,
而當迴圈一次都沒跑時,你隨手挑的那個假值就會被默默回傳出去:
// java
// LC 198 - House Robber
// IDEA: same 2-variable rolling window; return the rolling var, not the temp
// time = O(n), space = O(1)
public int rob(int[] nums) {
    if (nums == null || nums.length == 0) return 0;
    int n = nums.length;
    if (n == 1) return nums[0];

    int p1 = nums[0];                       // dp[0]
    int p2 = Math.max(nums[0], nums[1]);    // dp[1]

    for (int i = 2; i < n; i++) {
        int cur = Math.max(p1 + nums[i], p2);
        p1 = p2;
        p2 = cur;
    }
    return p2;   // hoisting `cur` out of the loop just to return it would need `int cur = 0;`
                 // -> returns 0 for n == 2 instead of the real answer
}
滾動變數檢查清單
| 步驟 | 要問自己的問題 |
|---|---|
| 1. 深度 | 遞迴式往回讀幾步?那就是幾個變數。 |
| 2. 不變量 | 在迴圈上方寫註解:p1 = dp[i-k] … pk = dp[i-1]。 |
| 3. 初值 | 這些初值滿足的是遞迴式,還只是題目敘述? |
| 4. 起始索引 | 從第一個「整個視窗都已初始化」的 i 開始跑(這裡是 i = 4)。 |
| 5. 更新順序 | 最舊 → 最新,或用一次 tuple 賦值。絕對不要最新 → 最舊。 |
| 6. 回傳 | 回傳最新的滾動變數(p3 / p2),絕不回傳迴圈體的暫存變數 — 迴圈跑 0 次時它是未綁定的。並確認 n < start 的情況已經提早回傳。 |
糖果棒/Tribonacci 的完整走法、視窗的圖解推演、更新順序的 bug、初值設定規則、 其他具有相同更新形狀的題目列表,以及往回
k步(雙端佇列/環形緩衝區)的通用化, 都在 dp_advanced.md。
模板 7:最長遞增子序列 — LC 300Priority 4 of 5 — High value — a gap here costs you rounds
dp[i]= 以索引i結尾的 LIS 長度,答案 =max(dp)。O(n log n) 的進階解改成維護一個tails陣列,用二分搜尋找插入位置。
// java
// LC 300. Longest Increasing Subsequence

/**  NOTE !!!
 *
 *  1. use 1-D DP
 *  2. Key Insight (Important):
 *
 *     - dp[i] = best LIS ending exactly at index i
 *
 *     - Inner loop checks:
 *          - "Can I extend a smaller LIS ending at j by appending nums[i]?"
 *
 *      - maxLen tracks the global maximum across all endpoints
 *
 */

// V0
// IDEA: 1D DP - O(n²) solution
public int lengthOfLIS(int[] nums) {
    if(nums == null || nums.length < 1) {
        return 0;
    }

    int n = nums.length;
    int[] dp = new int[n];

    // Each element itself is an increasing subsequence of length 1
    for(int i = 0; i < n; i++) {
        dp[i] = 1;
    }

    int res = 1;

    for(int i = 1; i < n; i++) {
        for(int j = 0; j < i; j++) {
            /**
             * NOTE !!!
             *
             *  `nums[i] > nums[j]` condition  !!!
             *
             *  -> ONLY if `right element is bigger than left element`,
             *     new length is calculated and DP array is updated
             *
             *  -> This ensures we're building an INCREASING subsequence
             *
             *  -> We check all previous elements (j < i) to see if we can
             *     extend their subsequences by adding nums[i]
             *
             */
            if(nums[i] > nums[j]) {
                dp[i] = Math.max(dp[i], dp[j] + 1);
                res = Math.max(res, dp[i]);
            }
        }
    }

    return res;
}
LIS 模式說明:
| 面向 | 說明 |
|---|---|
| 狀態定義 | dp[i] = 以索引 i 結尾的最長遞增子序列長度 |
| 初始化 | 所有 i 都設 dp[i] = 1(每個元素本身就是長度 1 的子序列) |
| 轉移 | 對所有 j < i,若 nums[i] > nums[j] 則 dp[i] = max(dp[i], dp[j] + 1) |
| 關鍵條件 | nums[i] > nums[j] 確保我們只延長遞增的子序列 |
| 時間複雜度 | O(n²) — 陣列上的巢狀迴圈 |
| 空間複雜度 | O(n) — 一維 DP 陣列 |
| 結果 | 所有 i 的 max(dp[i]) — DP 陣列裡的最大值 |
為什麼 nums[i] > nums[j] 這個條件至關重要:
- 我們走訪所有先前的元素
j(j < i) - 檢查當前元素
nums[i]能不能接在以j結尾的子序列後面 - 只有在
nums[i] > nums[j]時,才能把nums[i]接上去而維持遞增 dp[j] + 1代表把以j結尾的 LIS 加上nums[i]之後的長度
範例推演:
Input: nums = [10, 9, 2, 5, 3, 7, 101, 18]

Initial: dp = [1, 1, 1, 1, 1, 1, 1, 1]

i=1, nums[1]=9:  No j where nums[j] < 9, dp[1] = 1
i=2, nums[2]=2:  No j where nums[j] < 2, dp[2] = 1
i=3, nums[3]=5:  nums[2]=2 < 5, dp[3] = dp[2]+1 = 2
i=4, nums[4]=3:  nums[2]=2 < 3, dp[4] = dp[2]+1 = 2
i=5, nums[5]=7:  nums[2]=2,nums[3]=5,nums[4]=3 < 7
                 dp[5] = max(dp[2]+1, dp[3]+1, dp[4]+1) = 3
i=6, nums[6]=101: Can extend from multiple, dp[6] = 4
i=7, nums[7]=18: Can extend from multiple, dp[7] = 4

Result: max(dp) = 4
LIS: [2, 3, 7, 101] or [2, 5, 7, 101] or others
模板 8:編輯距離 — LC 72Priority 4 of 5 — High value — a gap here costs you rounds
模式:把 word1 變成 word2 所需的最少插入/刪除/取代次數(Levenshtein 距離)。
辨認清單、三種操作的直覺、由上而下與空間優化的變形,以及圖解表格,都在
dp_advanced.md;整個雙序列家族在 dp_string.md。
這張表是形狀 B — 它的形狀、為什麼照列掃是唯一合法的順序,以及把操作清單還原出來的反向走法,
都在 模板 2a。
狀態定義:
dp[i][j]= 把word1[0...i-1]變成word2[0...j-1]的最少操作次數
初始條件:
dp[i][0] = i(把 word1 的 i 個字元全刪掉,變成空字串)dp[0][j] = j(在空字串裡插入 j 個字元,變成 word2)
轉移:
If word1[i-1] == word2[j-1]:
    dp[i][j] = dp[i-1][j-1]  (no operation needed)
Else:
    dp[i][j] = 1 + min(
        dp[i-1][j],     # Delete from word1
        dp[i][j-1],     # Insert into word1
        dp[i-1][j-1]    # Replace in word1
    )
Python 實作(由下而上):
def minDistance(word1, word2):
    """LC 72: Edit Distance - Bottom-Up DP"""
    m, n = len(word1), len(word2)
    # dp[i][j] = min operations to convert word1[:i] to word2[:j]
    dp = [[0] * (n + 1) for _ in range(m + 1)]

    # Base cases
    for i in range(m + 1):
        dp[i][0] = i
    for j in range(n + 1):
        dp[0][j] = j

    # Fill DP table
    for i in range(1, m + 1):
        for j in range(1, n + 1):
            if word1[i-1] == word2[j-1]:
                dp[i][j] = dp[i-1][j-1]
            else:
                dp[i][j] = 1 + min(
                    dp[i-1][j],    # Delete
                    dp[i][j-1],    # Insert
                    dp[i-1][j-1]   # Replace
                )

    return dp[m][n]
Java 實作(由下而上):
// LC 72: Edit Distance - Standard approach
public int minDistance(String word1, String word2) {
    int m = word1.length();
    int n = word2.length();

    int[][] dp = new int[m + 1][n + 1];

    // Base cases
    for (int i = 0; i <= m; i++) {
        dp[i][0] = i;  // Delete all characters
    }
    for (int j = 0; j <= n; j++) {
        dp[0][j] = j;  // Insert all characters
    }

    // Fill DP table
    for (int i = 1; i <= m; i++) {
        for (int j = 1; j <= n; j++) {
            if (word1.charAt(i - 1) == word2.charAt(j - 1)) {
                dp[i][j] = dp[i - 1][j - 1];
            } else {
                dp[i][j] = 1 + Math.min(
                    dp[i - 1][j],    // Delete
                    Math.min(
                        dp[i][j - 1],    // Insert
                        dp[i - 1][j - 1] // Replace
                    )
                );
            }
        }
    }

    return dp[m][n];
}
比較:LC 72 vs LC 1143(LCS)
| 面向 | LC 72 (Edit Distance) | LC 1143 (LCS) |
|---|---|---|
| 目標 | 最小化所需操作數 | 最大化相符的字元數 |
| 操作 | 插入、刪除、取代 | 只有相符或跳過 |
| 相符時 | 不用付出代價(不需操作) | 長度 +1 |
| 不符時 | 1 + min(三個選項) | max(跳過左邊, 跳過右邊) |
| DP 轉移 | dp[i][j] = 1 + min(dp[i-1][j], dp[i][j-1], dp[i-1][j-1]) |
dp[i][j] = dp[i-1][j-1] + 1 或 max(dp[i-1][j], dp[i][j-1]) |
模板 9:最長公共子序列 — LC 1143
def lcs_dp(text1, text2):
    """LCS pattern for string matching"""
    m, n = len(text1), len(text2)
    # dp[i][j] = LCS length of text1[:i] and text2[:j]
    dp = [[0] * (n + 1) for _ in range(m + 1)]

    for i in range(1, m + 1):
        for j in range(1, n + 1):
            if text1[i-1] == text2[j-1]:
                dp[i][j] = dp[i-1][j-1] + 1
            else:
                dp[i][j] = max(dp[i-1][j], dp[i][j-1])

    return dp[m][n]
雙序列格子 → dp_string.md
幾乎所有雙字串題目都是同一張格子:dp[i][j] = s1 的前 i 個字元與 s2 的前 j 個字元的答案。
只有轉移式不一樣。
| 移動方向 | 意義 |
|---|---|
對角線 dp[i-1][j-1] |
兩個字串各消掉一個字元(它們相符) |
垂直 dp[i-1][j] |
跳過/刪掉 s1 的一個字元 |
水平 dp[i][j-1] |
跳過/插入 s2 的一個字元 |
| 題目 | LC | 相符時 | 不符時 |
|---|---|---|---|
| Longest Common Subsequence | 1143 | 1 + dp[i-1][j-1] |
max(dp[i-1][j], dp[i][j-1]) |
| Edit Distance | 72 | dp[i-1][j-1] |
1 + min(取代, 刪除, 插入) |
| Distinct Subsequences | 115 | dp[i-1][j-1] + dp[i-1][j] |
dp[i-1][j] |
| Interleaving String | 97 | dp[i-1][j] && s1[i-1]==s3[i+j-1](或換成 s2 那一側) |
False |
LC 72 和 LC 1143 的模板留在上面(模板 8 — 編輯距離、模板 9 — LCS)。
模板 10:回文子字串 DP — LC 5Priority 5 of 5 — Must know — expect it in almost every loop
題目原型:LC 647(Count Palindromic Substrings)、LC 5(Longest Palindromic Substring)
這張表是形狀 A — 下面那個
i倒著走、j正著走的順序就是 模板 2a 裡的順序 A;而j - i <= 2這個護欄之所以存在,是因為dp[i+1][j-1]會掉進死掉的三角形裡。
🎯 做法比較
| 做法 | 時間 | 空間 | 什麼時候用 |
|---|---|---|---|
| 暴力 | O(n³) | O(1) | 面試絕對不要 |
| 二維 DP(依長度)— dp_advanced.md | O(n²) | O(n²) | 需要完整的 dp 表來回答其他查詢 |
| 二維 DP(i 倒著跑) | O(n²) | O(n²) | 同上,寫起來稍微乾淨一點 |
| 雙指標(中心擴展) ⭐ | O(n²) | O(1) | 預設選擇 — 更單純、空間最省 |
| Manacher 演算法 — dp_advanced.md | O(n) | O(n) | 競賽程式/最佳解 |
💡 DP 的核心想法
狀態:dp[i][j] = True 表示 s[i..j] 是回文。
轉移 — 一個子字串是回文,當且僅當:
dp[i][j] = True
  when:  s[i] == s[j]
  AND    (j - i <= 2   ← length ≤ 3, no inner to check)
         OR dp[i+1][j-1]  ← inner substring is also palindrome
為什麼 j - i <= 2 是初始條件?
- 長度 1(
i == j):一定是回文 — 單一字元 - 長度 2(
j - i == 1):s[i] == s[j]才是回文 — 例如 “aa” - 長度 3(
j - i == 2):外面兩個字元相符就是回文 — 例如 “aba”;中間只有一個字元,必然合法
做法 1:二維 DP — i 倒著跑 + j 正著跑 Priority 1 of 5 — Nice to have
# IDEA: loop i backward so dp[i+1][...] is always ready when computing dp[i][...]
def countSubstrings_dp_backward(s):
    # time = O(n^2), space = O(n^2)
    n = len(s)
    dp = [[False] * n for _ in range(n)]
    count = 0

    for i in range(n - 1, -1, -1):   # i backward: ensures dp[i+1][j-1] is computed
        for j in range(i, n):         # j forward:  ensures dp[i][j-1] is computed
            if s[i] == s[j] and (j - i <= 2 or dp[i+1][j-1]):
                dp[i][j] = True
                count += 1

    return count
為什麼 i 要倒著跑?
dp[i][j] 依賴 dp[i+1][j-1](內層子字串)。填第 i 列時要讀到第 i+1 列,所以 i 要從 n-1 往 0 跑。
做法 2:雙指標 — 從中心往外擴 (推薦)Priority 2 of 5 — Niche — read once, revisit only if a company is known to ask
關鍵洞見:每個回文都有一個中心。從每個可能的中心往外擴,一邊擴一邊數。
- 奇數長度回文:中心是一個字元 — 從
(i, i)開始擴 - 偶數長度回文:中心在兩個字元之間 — 從
(i, i+1)開始擴
# IDEA: expand around center — O(1) space, no dp table needed
def countSubstrings_two_pointers(s):
    # time = O(n^2), space = O(1)
    count = 0
    n = len(s)

    def expand(l, r):
        cnt = 0
        while l >= 0 and r < n and s[l] == s[r]:
            cnt += 1
            l -= 1
            r += 1
        return cnt

    for i in range(n):
        count += expand(i, i)      # odd-length  (center at i)
        count += expand(i, i + 1)  # even-length (center between i and i+1)

    return count
s = "aaa" 的圖解推演:
Center i=0:
  odd  (0,0): "a"          → count +1
  even (0,1): "aa"         → count +1

Center i=1:
  odd  (1,1): "a"→(0,2)"aaa" → count +2  (expands to full string)
  even (1,2): "aa"         → count +1

Center i=2:
  odd  (2,2): "a"          → count +1
  even (2,3): out of bounds → count +0

Total = 6  ✓
關鍵抉擇:DP 還是雙指標
Need the full dp[i][j] table? (e.g., for partitioning / further DP)
  YES → Use 2D DP (Approach 1)
  NO  → Use Two Pointers (Approach 2) — simpler + O(1) space
常見錯誤
- 檢查
dp[i+1][j-1]卻沒有j-i <= 2的保護:當j-i == 1時,dp[i+1][j-1]=dp[i+1][i](無效索引)。一定要把j - i <= 2當初始條件搭配使用。 - i 倒著跑的 DP 迴圈方向搞錯:忘了
i必須從n-1跑到0,dp[i+1][...]才會是已填好的。 - 中心擴展時漏掉偶數長度的中心:一定要同時呼叫
expand(i, i)和expand(i, i+1),才能涵蓋奇數與偶數回文。
依長度填表的順序、Manacher 的 O(n) 演算法,以及類似題對照,都在 dp_advanced.md;palindrome.md 收錄的是非 DP 的回文工具箱。
模板 11:狀態壓縮(Bitmask DP)→ dp_bitmask.md
什麼時候適用:狀態是「我已經用掉哪些物品的子集」,而且 n <= 20(所以 2^n 個遮罩還算得動)。
dp[mask] = 恰好處理完 mask 裡那些物品時的最佳答案。
# python — the shape of every bitmask DP
# time = O(2^n * n), space = O(2^n)
for mask in range(1 << n):
    for i in range(n):
        if mask & (1 << i):                      # item i already used
            prev = mask ^ (1 << i)
            dp[mask] = best(dp[mask], dp[prev] + cost(prev, i))
| 位元運算 | 意義 |
|---|---|
mask & (1 << i) |
物品 i 在集合裡嗎? |
mask | (1 << i) |
加入物品 i |
mask ^ (1 << i) |
移除物品 i(只有在它存在時才對) |
sub = (sub - 1) & mask |
枚舉 mask 的子遮罩 |
bin(mask).count('1') |
popcount = 用掉幾件物品 |
dp_bitmask.md 完整涵蓋:位元運算完整參考、TSP 與指派問題的模板、
子遮罩枚舉 DP、複雜度估算,以及經典陷阱(n >= 31 要用 1L << n、子遮罩迴圈寫錯、
把 popcount 當索引用)。
模板 12:數位 DP → dp_digit.md
什麼時候適用:「[L, R] 之間有幾個數字滿足某種位數層級的性質?」— 範圍大到根本不可能逐一走訪,
但一個數字只有約 18 位。
三個狀態變數(把這些背起來;其餘都是題目專屬的):
| 狀態 | 意義 | 為什麼需要它 |
|---|---|---|
pos |
正在填第幾位 | 遞迴的索引 |
tight |
前綴是否仍與上界的前綴相同? | 是的話這一位的上限是 bound[pos];不是的話 0..9 隨便填 |
started |
是否已經放過非零數字? | 用來區分真正的首位數字和補位的零 |
區間技巧:answer(L, R) = count(R) - count(L - 1)。
dp_digit.md 完整涵蓋:附註解的通用模板、LC 233(數 1 的個數)、
LC 902(用指定數字集組出的數)、數位和與不可有連續數字的變形、剪枝,以及記憶化鍵值的陷阱。
關鍵字:DP, dynamic programming, memoization, tabulation, optimal substructure, overlapping subproblems, state transition, knapsack, LCS, LIS, interval DP, tree DP, state machine, bitmask, monotonic stack, mono stack, stack DP
總結與快速查表
這題是 DP 嗎?
DP Problem Identification Flowchart:

1. Can the problem be broken into subproblems?
   ├── NO → Not a DP problem
   └── YES → Continue to 2

2. Do subproblems overlap?
   ├── NO → Use Divide & Conquer
   └── YES → Continue to 3

3. Does it have optimal substructure?
   ├── NO → Not a DP problem
   └── YES → Use DP, continue to 4

4. What type of DP pattern?
   ├── Single sequence → Linear DP (Template 1)
   ├── 2D grid/matrix → Grid DP (Template 2)
   ├── Interval/substring → Interval DP (Template 3)
   ├── Selection with limit → Knapsack (Template 4)
   └── Multiple states → State Machine (Template 5)

5. Implementation approach?
   ├── Recursive structure clear → Top-down memoization
   └── Iterative structure clear → Bottom-up tabulation
DP vs 其他做法
| 題型 | 用 DP | 有其他選擇嗎 | 替代做法 |
|---|---|---|---|
| 最佳化(求最小/最大) | ✅ | 有時候 | 若貪婪也最佳就用貪婪 |
| 數方法數/路徑數 | ✅ | - | - |
| 判定(是/否) | ✅ | 有時候 | 貪婪/DFS |
| 需要列出所有解 | ❌ | ✅ | 回溯 |
| 沒有重疊子問題 | ❌ | ✅ | 分治法 |
| 具備貪婪選擇性質 | ❌ | ✅ | 貪婪 |
該用哪個 DP 模式?
模式快速選擇表
| 題型 | 辨認關鍵字 | DP 分類 | 範例題目 |
|---|---|---|---|
| 費氏數列類 | “nth number”、“climbing stairs”、“decode ways” | 線性 DP | LC 70, 91, 746 |
| 打家劫舍 | “non-adjacent”、“cannot pick consecutive” | 線性 DP | LC 198, 213, 337 |
| 前綴切分 | “break/segment a string”、“cut into valid pieces” | 前綴切分 DP | LC 139, 140, 132, 279 |
| 最長遞增 | “longest increasing”、“LIS”、“envelope” | 線性 DP | LC 300, 354, 673 |
| 路徑計數 | “unique paths”、“number of ways to reach” | 格子 DP | LC 62, 63, 980 |
| 路徑和(最小/最大) | “minimum path sum”、“maximum sum” | 格子 DP | LC 64, 120, 174 |
| 正方形/矩形 | “maximal square”、“largest rectangle” | 格子 DP | LC 221, 85 |
| 區間問題 | “burst balloons”、“merge stones”、“palindrome partition” | 區間 DP | LC 312, 1000, 516 |
| 樹上問題 | “house robber on tree”、“tree cameras” | 樹上 DP | LC 337, 968 |
| 樹的換根 | “for every node compute”、“sum of distances” | 換根 DP | LC 834, 2581 |
| 股票交易 | “buy and sell stock”、“transaction”、“cooldown” | 狀態機 | LC 122, 309, 714 |
| 背包(0/1) | “subset sum”、“partition”、“target sum” | 背包 DP | LC 416, 494 |
| 背包(完全) | “coin change”、“unlimited supply” | 背包 DP | LC 322, 518 |
| 編輯距離 | “edit distance”、“minimum operations” | 字串 DP | LC 72, 583, 712 |
| LCS/LPS | “longest common subsequence”、“palindrome” | 字串 DP | LC 1143, 516, 647 |
| Bitmask/子集 | “visit all nodes”、“assign tasks”、“TSP” | 狀態壓縮 | LC 847, 1723, 691 |
訊號 → 模式
| 訊號 | 模式 |
|---|---|
| 「帶滑動限制的最大/最小子陣列」 | 單調佇列 DP |
| 「以每個節點為根各求一次答案」 | 換根(2 趟 DFS) |
| 「最大矩形/最大正方形」 | 堆疊 DP,或在前綴高度上做 DP |
| 「賽局:兩人都最佳決策」 | Minimax DP:dp[i][j] = 分差 |
| 「數出符合位數限制的數字」 | 數位 DP:(pos, tight, accumulator) |
| 「把字串切成合法單字」 | 前綴切分 DP:dp[i] 跑前綴長度 + 單字集合 |
| 「買賣股票的各種變形」 | 狀態機(持有/賣出/休息) |
| 「編輯距離、LCS、交錯字串」 | 二維 DP → 一維空間優化 |
複雜度速查
| 模式 | 時間複雜度 | 空間複雜度 | 空間優化 |
|---|---|---|---|
| 一維線性 | O(n) | O(n) | 用變數可壓到 O(1) |
| 二維格子 | O(m×n) | O(m×n) | 用滾動陣列可壓到 O(n) |
| 區間 | 通常 O(n³) | O(n²) | 通常壓不下去 |
| 0/1 背包 | O(n×W) | O(n×W) | 用一維陣列可壓到 O(W) |
| 狀態機 | O(n×k) | O(k) | 已經是最省的了 |
狀態定義的原則
# 1D: Position/index based
dp[i] = "optimal value considering first i elements"

# 2D: Two dimensions
dp[i][j] = "optimal value for subproblem (i, j)"

# Interval: Range based
dp[i][j] = "optimal value for interval [i, j]"

# Boolean: Decision problems
dp[i] = "whether target i is achievable"
解題步驟
- 判斷能不能用 DP:檢查有沒有重疊子問題
- 定義狀態:dp[i] 代表什麼?
- 找出遞迴式:狀態之間怎麼互相關聯?
- 確認初始條件:初值是什麼
- 決定走訪順序:由下而上該往哪個方向填
- 優化空間:能不能改用滾動陣列?
常見錯誤與提醒
🚫 常見錯誤:
- 狀態定義錯誤
- 漏掉初始條件
- 走訪順序不對
- 沒處理邊界情況
- 資料量大時整數溢位
✅ 最佳實務:
- 先寫遞迴解,再做優化
- 畫小例子找出規律
- 仔細檢查陣列邊界
- 先確定正確性,再考慮空間優化
- 狀態變數用有意義的名字
面試提點
- 從簡單開始:先寫遞迴解
- 找出子問題:畫遞迴樹
- 加上記憶化:轉成由上而下的 DP
- 考慮由下而上:通常效率更好
- 優化空間:用滾動陣列加分
- 拿例子測:用小輸入手動推一遍
相關主題
- 貪婪:局部最佳能導出全域最佳時
- 回溯:需要列出所有解時
- 分治法:沒有重疊子問題時
- 圖論演算法:圖上的 DP(最短路徑)
- 二分搜尋:具單調性的最佳化問題