Kafka FAQ
1) 說明 Kafka 架構?
-
特性
- kafka 是一套可持續運作的
分散式pub-sub(發布-訂閱)訊息系統 - 由 Linkedin 用 scala 開發
- 線上與離線訊息都能處理。資料寫到磁碟並有副本 -> 避免資料遺失
- kafka 是一套可持續運作的
-
組成元件
Broker- kafka 叢集有很多節點
- 一個 broker 就是一個節點/伺服器
Topic- kafka 上每個事件都屬於某一類,那就是 topic
- 每個 topic 對應不同的資料來源(訊息流)
- topic 數量沒有上限
- 生產者與訂閱者以 topic 為基本單位。還可以再用 topic partition 細分
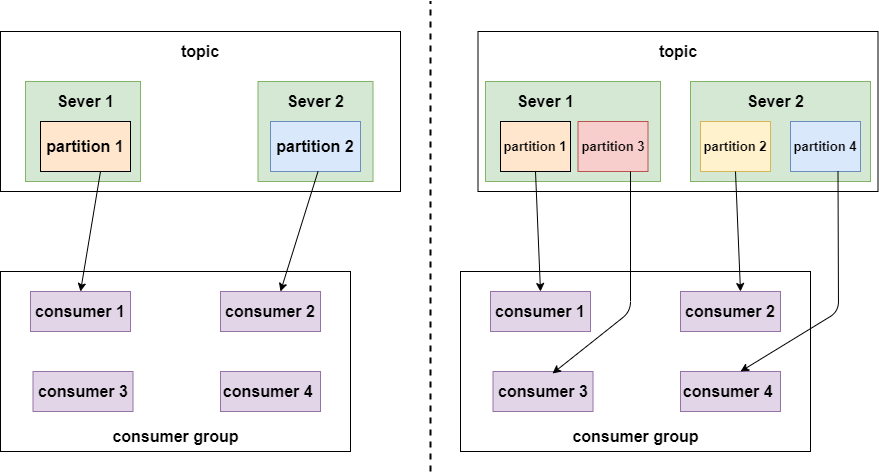
Partition- 每個 topic 有多個 partition
- 注意:同一個 broker 上可以有多個 partition -> broker 的數量和 partition 的數量沒有關係
- 每個 topic 的 partition 都有 id,從 0 開始
- 特別注意!!:
- 每個 partition 內的資料可以是有序的。但
不能保證全域(整個 topic)的資料有序 - 所謂有序:生產者寫入的順序和消費者讀到的順序一致
- 每個 partition 內的資料可以是有序的。但
- partition 決定了同一個 consumer group 裡
同時併行消費者的上限 - 所以 partition 越多,消費速度就能拉得越高
- Partition replicas(分區副本)
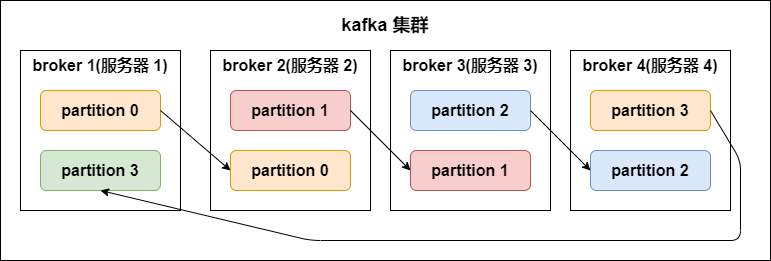
- replication-factor
- 定義有幾份副本(分散在不同 broker 上)。
- 一般來說
副本數 == broker 數 - 每個
partition都有自己的leader replica與follower replica- 例如 1 個 leader、N 個 follower -> N 份副本
- 跟得上進度的 follower replica 叫做「in-sync-replicas(ISR)」
- 特別注意!!:
生產者與消費者都是對leader replica讀寫,不會和 follower replica 互動 - 這是為了資料 I/O 時的可靠性
- leader 掛掉時,會把其中一個 follower 升為新的 leader
- replication-factor
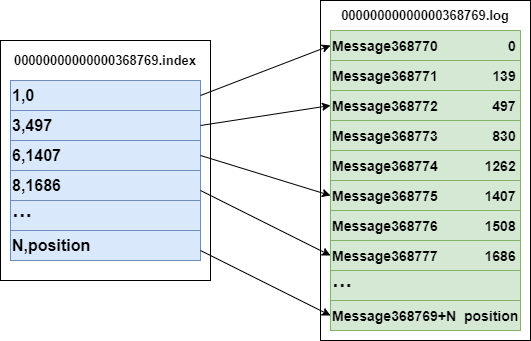
Segment- 每個 partition 有
多個segment。- 每個 segment 有兩個部分:
.index:索引檔(給 .log 用)。用來在 .log 檔裡找 offset.log:記錄實際的事件資料
- 命名規則
- 以「全域 partition」來看,從 0 開始
- 下一個 segment 的名字是上一個 partition 的最大 offset(offset 訊息數)
- offset 是 64 位元 Long,20 位數字,位數不足就補 0
- 每個 segment 有兩個部分:
- 例子:
index裡的3,497:表示 .log 檔裡的第 3 則訊息,它的 offset = 497log裡的Message 368772:表示它是全域 partition 裡的第 368772 則訊息- .log 與 .index
bash# file structure /<topic_name>-<partition_name> /.../xxx.index /.../xxx.log # index file 00000000000000000000.index // <offset>.index # log content 00000000000000000000.log // <offset>.logbash# example -rw-r--r--. 1 root root 389k 1月 17 18:03 00000000000000000000.index -rw-r--r--. 1 root root 1.0G 1月 17 18:03 00000000000000000000.log -rw-r--r--. 1 root root 10M 1月 17 18:03 00000000000000077894.index -rw-r--r--. 1 root root 127M 1月 17 18:03 00000000000000077894.log
- 每個 partition 有
Producer- 訊息生產者,把訊息送到 kafka broker
- 寫資料到
leader replica
Consumer- 訊息消費者(客戶端),從 kafka 讀訊息
- consumer 一定要屬於某個 consumer group
- 從
leader replica讀資料 - 特別注意!!:
consumer 的數量應該<=topic 裡 partition 的數量- 因為同一份資料在同一個 consumer group 底下,同一時間只該被一個 consumer 消費
Consumer group- 每個 consumer 都屬於某個特定的
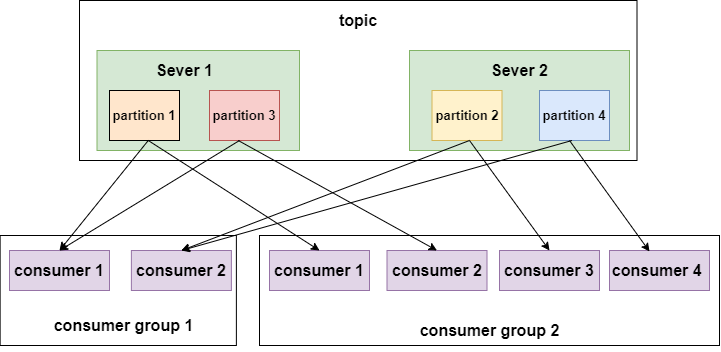
consumer group(group 名稱可以自己定) - 同一個 consumer group 裡,同一則訊息只會被消費
一次 - 每個 consumer 有一個 ID(group ID)。所有 consumer 都可以訂閱一個 topic 下的所有 partition
- 一個 partition 在一個 consumer group 裡
只能被一個consumer 消費
- 每個 consumer 都屬於某個特定的
-
圖
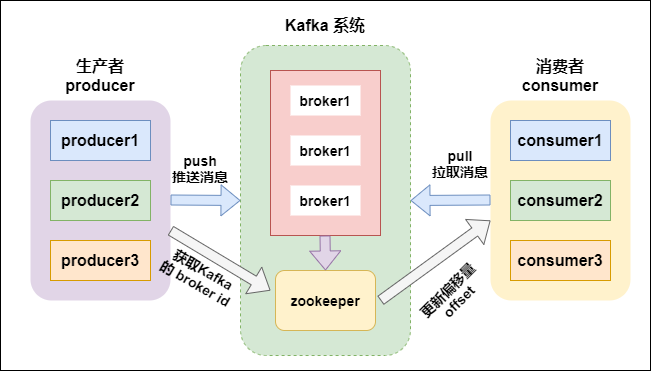
-
參考
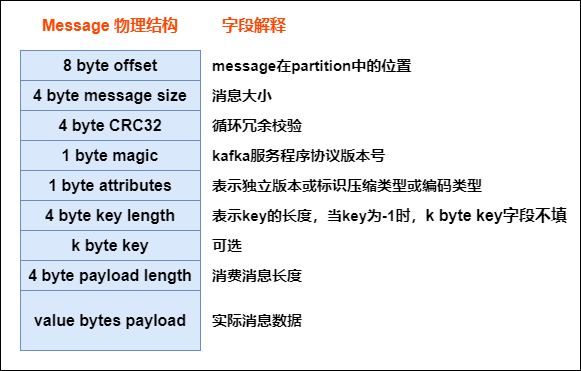
1’) Kafka 的訊息結構?
- 如下圖,生產者送出的每則訊息都會先被 kafka 預處理,然後以下面的結構存起來(在 kafka broker 上)。只有最後一個欄位才是來自 broker 的實際資料
- 圖
1’') Kafka 怎麼靠 index 找到 .log 檔?
- 磁碟上的一個 partition 是一連串
segment。每個 segment 是一組檔案,以它第一筆紀錄的base offset命名:00000000000000368769.log:實際的紀錄00000000000000368769.index:一份稀疏的相對 offset -> .log 裡的位元組位置對照表00000000000000368769.timeindex:時間戳 -> 相對 offset(offsetsForTimes會用到)
- 查找 offset
N分三步,前兩步都是O(log n),最後短距離掃描:- 步驟 1)
對檔名做二分搜尋-> 找到 base offset 是「小於等於 N 之中最大的」那個 segment - 步驟 2)
在 .index 裡二分搜尋-> 找到最接近且 <= N 的那筆索引,得到一個位元組位置 - 步驟 3) 從那個位置在 .log 裡
循序掃描,直到找到 offset 為 N 的那筆紀錄
- 步驟 1)
- 為什麼要稀疏(每
log.index.interval.bytes一筆,預設 4KB):密集索引會大得跟資料一樣。稀疏索引夠小、能留在 page cache 裡,而掃描成本被那個間隔限制住 - 讀取接著就是從 page cache 直接
sendfile()到 socket(zero copy),這是 kafka 快的另外一半原因
1’‘’) 說明 zookeeper(ZK)在 kafka 裡怎麼運作?kafka 怎麼透過 ZK 處理 offset?
- ZK 掌管什麼(kafka <= 2.x)
- broker 註冊與存活偵測(臨時節點)
controller 選舉(負責指派 partition leader 的那個 broker)- topic / partition / replica 的中繼資料、設定、ACL、配額
- Offset
kafka 0.8 以前:消費者的 offset 提交到 ZK -> ZK 的寫入變成瓶頸(ZK 是為低寫入量的協調而生的,不是拿來每則訊息提交一次的)kafka 0.9+:offset 改為提交到內部的壓實 topic__consumer_offsets,以<group, topic, partition>為 key。ZK 不再出現在消費路徑上
KRaft(KIP-500,3.3 起可用於正式環境,4.0 移除 ZK):中繼資料搬進由 controller broker 管理、以 Raft 複製的內部日誌- 不用再維運外部 ZK、故障轉移更快,中繼資料也能擴展到數百萬個 partition
- 面試一句話版:「ZK 協調的是叢集,從來不在資料路徑上;offset 在 0.9 離開 ZK,而 ZK 自己在 KRaft 之後也走了」
2) Kafka 怎麼做到 exactly once?
- 請看下面的
冪等性 (Idempotence)與事務性 (transactional) - 太長不看版
- PID(producer ID)、sequence number
- transaction(交易)
3) Kafka 怎麼避免資料遺失?
- Producer
- 靠
ACK - 可以用
sync、async模式送資料到 kafka - 模式
- Sync
- 送一批資料到 kafka,然後等 kafka 回應
- producer 等 10 秒(?),沒收到 ACK 就標記為失敗
- producer 重試 3 次(?),還是沒 ACK 就標記為失敗
- 送一批資料到 kafka,然後等 kafka 回應
- Async
- 送一批資料到 kafka,只提供一個
callback()方法 - 資料先存在 producer 的 buffer 裡,buffer 大小約 20k
- 達到門檻就可以把資料送出(到 kafka)
- 一批資料的大小約 500
- 注意:如果 kafka broker 一直沒有 ACK,而 producer 的 buffer 已經滿了,開發者可以自己決定要不要清掉 buffer(用程式控制)
- 送一批資料到 kafka,只提供一個
- Sync
- 靠
- Broker
- 靠
Partition replicas避免資料遺失
- 靠
- Consumer
- 每個 consumer 自己記錄/維護 offset,可以避免資料遺失
- offset 可以存在客戶端的檔案系統、資料庫、Redis……
3’) 說明 kafka 的 ACK?
request.required.acks:kafka 把生產者的訊息寫進自己的副本時,要怎麼確認- 這是效率(回應速度)與可靠性(容錯)之間的取捨
- 幾種情況
ack = 1(預設)- producer -> kafka broker 時,只要 kafka leader 確認收到就算成功 -> 如果 leader 在 follower 同步完成前掛掉就會掉資料
ack = 0- producer -> kafka broker,送出去就算成功。速度最快,broker 掛掉就掉資料
ack = -1(或 all)- leader 會等
目前 ISR 裡的每一個副本—— 不是每一個 follower。速度最慢,而且它只有搭配min.insync.replicas才構成耐久性保證(例如replication.factor=3+min.insync.replicas=2)—— 這樣當副本掉出同步時,寫入才會失敗,而不是被單一份副本確認掉。見第 6) 與第 10) 題。
- leader 會等
- 參考
4) 說明 kafka 的基本資料模型?
Record:key、value、headers、timestamp,以及由 broker 指派的offsetTopic:一條具名、只能附加的日誌。邏輯上的一條資料流,切成多個 partitionPartition:順序、儲存與平行度的單位- 順序
只在單一 partition 內保證,跨 topic 永遠不保證 - 用預設的 partitioner 時,partition 是
murmur2(序列化後的 key) % partition 數,所以同一個 key 一定落在同一個 partition —— 這就是「同一實體有序」的實現方式。但它只在 partition 數量與 partitioner 不變時成立:加 partition 會讓 key 重新對應,而自訂的 partitioner 想怎麼做都行 - key 是 null 時 -> 走
黏性(sticky)批次(先把一個 partition 的批次填滿再換),而不是嚴格的輪詢
- 順序
Segment:partition 實際存放成的那些檔案(見 1’')Replica:每個 partition 有replication.factor份副本 —— 一個leader(所有讀寫都走它)與從它拉資料的 followerConsumer group:一組共用同一份訂閱的 consumer。一個 partition -> group 裡最多一個 consumer,所以partition 數就是平行度的上限Offset:consumer 在某個 partition 裡的位置。資料不會因為被讀過就刪掉 —— 它由retention.ms/retention.bytes保留,或依 key 做壓實(cleanup.policy=compact),這也是能重播的原因
text
topic "orders"
 ├─ partition 0 : [0][1][2][3][4]        ← ordered, immutable, append-only
 ├─ partition 1 : [0][1][2]                 leader on broker A, followers on B,C
 └─ partition 2 : [0][1][2][3]
consumer group "billing" : c1 → p0, c2 → p1+p2   (a 4th consumer would idle)
5) 說明 kafka 怎麼存資料(底層、檔案系統層級)?
- 檔案
- .log:存資料的檔案
- .index:存 .log 檔索引的檔案
6) 說明 kafka 的 master、slave 關係?以資料分區來看……?
- 對資料而言,Kafka 沒有叢集層級的 master。leader 是
以 partition 為單位的,所以負載會分散到每一個 brokerleader replica:承接該 partition 的所有生產與消費流量follower replica:除了從 leader 拉資料保持同步之外什麼都不做(它是熱備,不是讀取副本 —— 不過 2.4 起有為了局部性而設的follower fetching)
controller(其中一個 broker,透過 ZK 或 KRaft 選出)是叢集層級的協調者:它偵測 broker 故障並重新指派 partition leader- 故障轉移:leader 掛了,controller 會
從 ISR 裡拔擢一個副本unclean.leader.election.enable=false(預設):拒絕拔擢落後的副本 -> 犧牲可用性,但資料不犧牲= true:照樣拔擢 -> 服務仍然可用,但會靜悄悄地掉資料
Preferred leader:指派清單裡的第一個副本;kafka 會重新平衡回它,讓 leader 分布保持平均- 耐久性的幾個旋鈕要一起看:
replication.factor=3+min.insync.replicas=2+acks=allacks=all等的是目前 ISR 裡的每一個副本—— 叢集健康時是 3 個,有一個掉出去之後就是 2 個min.insync.replicas=2是下限:ISR 縮到 2 以下時,寫入會被拒絕(NotEnoughReplicas),而不是被單一份副本確認掉- 兩者合起來的意思是:死一台 broker 不掉資料,也不會靜悄悄地降級
7) 一個 consumer 消費 kafka topic 的步驟?
- 步驟 1)
bootstrap:連上bootstrap.servers,取得叢集中繼資料(哪個 broker 是哪個 partition 的 leader) - 步驟 2)
找到 group coordinator:也就是持有這個 group 在__consumer_offsets裡那個 partition 的 broker - 步驟 3)
join + sync group:coordinator 挑一個 leader consumer,由它跑分配演算法(range、roundrobin、sticky,或cooperative-sticky—— 最後這個可以避免 stop-the-world 的 rebalance),再把分配結果交回來 - 步驟 4)
定位:每個被分到的 partition,從已提交的 offset 開始;沒有的話就依auto.offset.reset(earliest/latest) - 步驟 5)
poll 迴圈:poll()從各個 partition leader 拉批次資料,同時也送 heartbeat 並觸發 rebalance。處理完紀錄之後再提交enable.auto.commit=true:在背景提交 -> 有at most once的風險(提交完但處理前就掛了)- 處理完之後手動
commitSync->at least once,所以要把 consumer 寫成冪等的
- 步驟 6) 有成員加入/離開,或超過
max.poll.interval.ms(通常是「處理太慢了」)時會rebalance—— partition 重新分配,回到步驟 3 - 步驟 7)
close():乾淨地離開 group,免得 group 要等session.timeout.ms才發現
8) 說明 kafka 的冪等性(Idempotence)
- 冪等性 -> 同一個流程跑很多次,結果都該一樣
- 核心概念:PID(Producer ID)、sequence number
- kafka 給每個 producer 一個 PID,並為每個 producer 的每個 Partition 維護一份
<PID, Partition> -> sequence number對照 - 只能保證單一 producer 內部的冪等,producer 掛掉重啟就不保證了
- 只能保證單一 partition 內的冪等,跨 topic-partition 不行
- 實作
- Broker
- 收到事件時
- 若
sequence number = 該 "<PID, Partition>" 的 sequence number + 1:broker 接受這個事件 - 若
sequence number < 該 "<PID, Partition>" 的 sequence number:重複事件,broker 忽略它 - 若
sequence number > 該 "<PID, Partition>" 的 sequence number:中間有資料缺漏,broker 丟出OutOfOrderSequenceException
- 若
- 收到事件時
- Producer
PID(Producer ID):- 用
Properties.put(“enable.idempotence”,true);啟用冪等 - 用來識別每個 producer 客戶端
- 每個 producer 初始化時拿到一個全域唯一的 PID
- producer 重啟就會拿到新的 PID
- 每個 PID 的 sequence number 都從 0 開始
- 每個 topic-partition 有各自獨立的 sequence number
- PID 是怎麼配發的。注意:這一段 ZK 的流程講的是
KRaft 之前的舊版 Kafka;KIP-500 之後 PID 由 controller 經由中繼資料日誌配發,而交易協調器負責__transaction_state。保留它是因為它仍然解釋得清楚「id 區塊」的想法:- 步驟 1) 從 zk 取
/latest_producer_id_block,看最近配發的 PID - 步驟 2) 若該節點是新的,PID 從 0 開始(0-1000),一次拿 1000 個(預設)
- 步驟 3) 若該節點已存在,讀它的資料,依 block_end 取 PID
- 步驟 4) 取到 PID 之後把資訊寫回 ZK;寫成功整個流程就結束,失敗表示節點可能已被更新,就從步驟 1) 重來
- 步驟 1) 從 zk 取
- 用
Sequence number:- 每則(來自 producer 客戶端的)訊息都有這個值,用來檢查紀錄是不是重複
- Broker
- 參考
9) 說明 kafka 的事務性(transactional)
- 提供「分區寫入」的
原子性-> 只有所有操作都成功才提交、才算成功,否則就回滾(全部成功或全部失敗) - 核心概念:
- TransactionalId
_transaction_state(Topic)- Producer epoch
- ControlBatch(又叫 Control Message、Transaction Marker)
- 由 producer 送到 kafka topic 的特殊事件。
- 兩種:COMMIT、ABORT(提交成功與否)
- TransactionCoordinator
- 為什麼不直接用 producer id(PID),而要引入 TransactionalId?
- PID 在 producer 重啟時會被重新指派,所以它無法跨重啟辨識同一個邏輯上的 producer。
transactional.id就是那個穩定的身分:它讓協調器找出上一個 session 沒結束的交易並中止它們,而把它的producer epoch加一就能隔離掉舊實例(見 9’)。讓「單一個事件」唯一的不是它 —— 那是<PID, partition, sequence number>這個三元組的工作(見第 8 題)
- PID 在 producer 重啟時會被重新指派,所以它無法跨重啟辨識同一個邏輯上的 producer。
- 藉此確保 exactly once
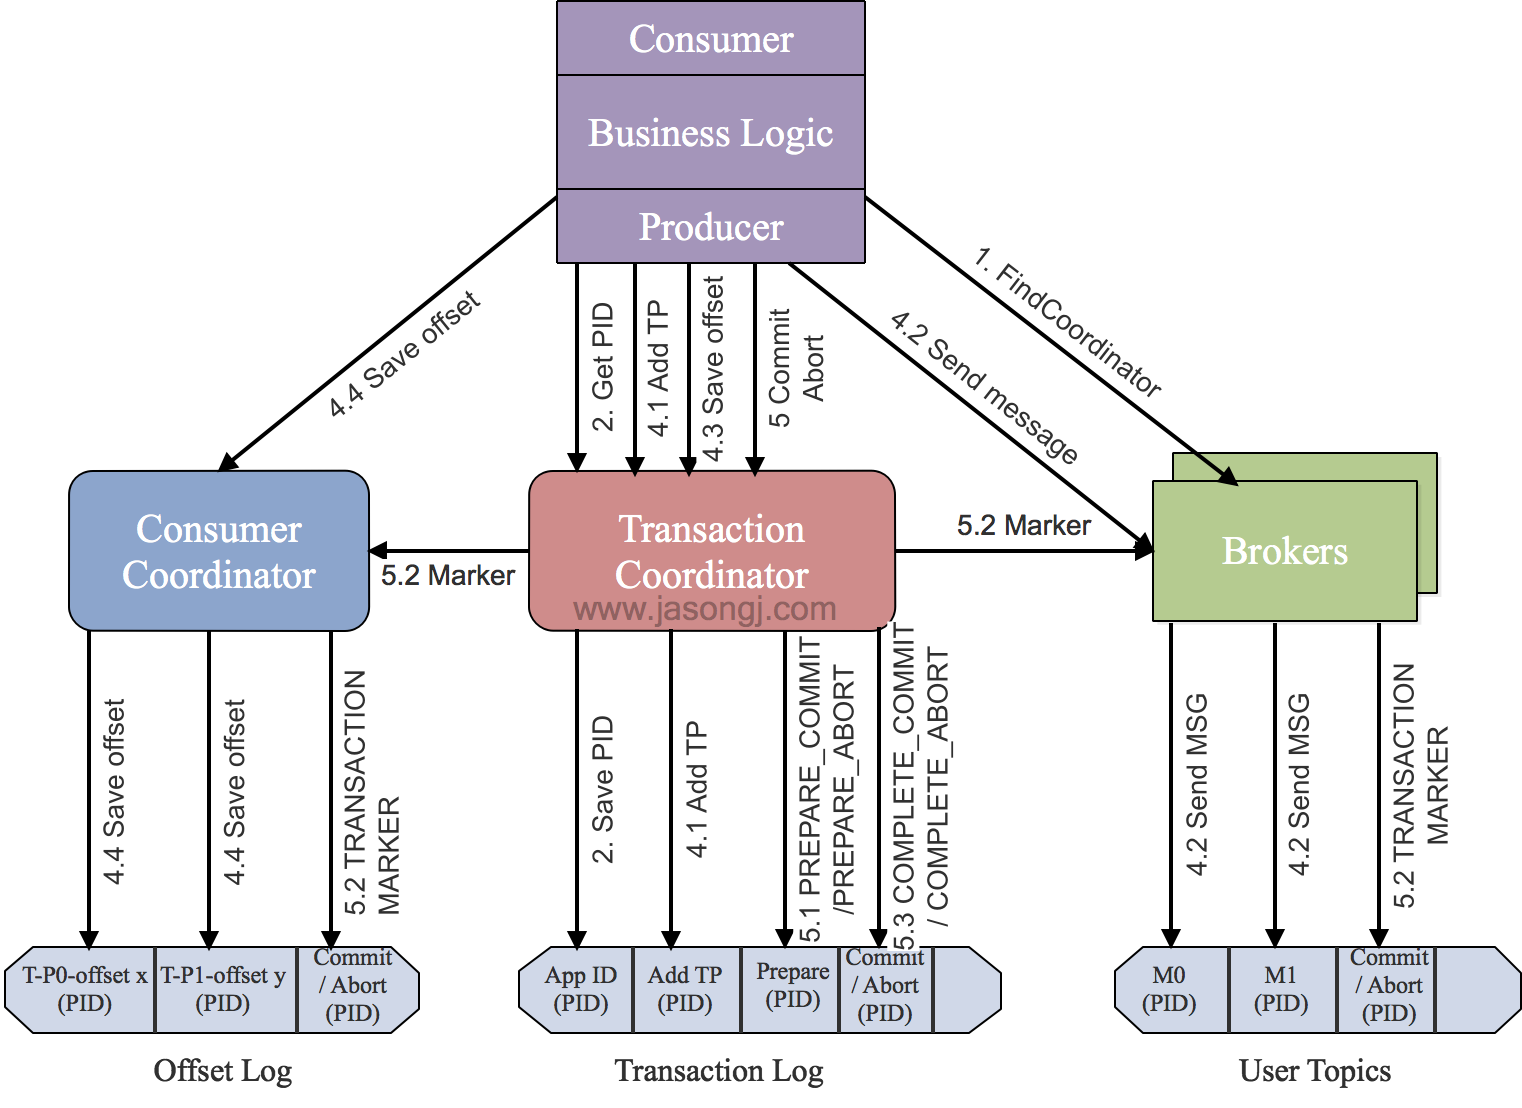
- 實作
- 步驟 1) 找到
Transaction Coordinator(TC)- producer 送
FindCoordinatorRequest給某個 broker,找到 TC 並取得它的 node_id、host、port
- producer 送
- 步驟 2) 初始化 initTransaction
initTransactions()送一個InitProducerIdRequest給 TC,TC 回傳 PID 與加一後的 producer epoch,並把<transactional.id, PID, epoch, 狀態>記錄到交易日誌(狀態有:Empty/Ongoing/PrepareCommit/PrepareAbort/CompleteCommit/CompleteAbort/Dead)。這件事只在任何 send 之前做一次—— 它同時隔離掉前一個實例,並處理掉它留下的未完成交易- 提交/中止那些還沒完成的任務
- 把 PID 加上 epoch,讓 producer 進入交易狀態
- 步驟 3) 開始交易
beginTransaction()只在 producer 自己的本地狀態裡把這筆交易標成已開始 —— TC 是延遲才知道的,要等第一筆紀錄真的送到某個 partition 時的AddPartitionsToTxnRequest。
- 步驟 4) read-process-write
- producer 一開始送事件,TC 就會把
<Transaction, Topic, Partition>存進 Transaction Log 並設成「開始」狀態,同時記下時間。 - Broker 會把送來的事件寫進磁碟(尚未 commit/abort)。如果之後是 abort,broker 上的訊息不會被刪掉,而是把狀態改成 abort
- producer 一開始送事件,TC 就會把
- 步驟 5) commitTransaction/abortTransaction
- producer 執行 commit/abort 時,TC 會做兩階段提交
- 階段 1:把 Transaction log 改成
PREPARE_COMMIT或PREPARE_ABORT - 階段 2:把 Transaction Marker 寫進所有相關事件,標成 committed 或 aborted
- 階段 1:把 Transaction log 改成
- Transaction Marker 寫完之後,TC 把最終狀態寫回 Transaction log,標記這筆交易已完成
- producer 執行 commit/abort 時,TC 會做兩階段提交
- 步驟 1) 找到
- 圖
- 參考
9’) 說明 Transaction Coordinator 與它的機制?
Transaction Coordinator(TC)是broker 內部的一個模組 —— 交易版的 group coordinator- 是哪一個 broker:
hash(transactional.id) % __transaction_state 的 partition 數—— 所以同一個交易型 producer 永遠對同一個 TC 說話,而且 TC 的狀態能撐過故障轉移,因為__transaction_state是有複製、會壓實的 topic - 它掌管什麼
- 交易日誌:
<transactional.id, PID, producer epoch, 狀態, 涉及的 partition, 逾時> - 狀態:
Empty -> Ongoing -> PrepareCommit / PrepareAbort -> CompleteCommit / CompleteAbort - 把
Transaction Marker(control batch)寫進這筆交易碰過的每一個 partition
- 交易日誌:
- 機制就是
兩階段提交(細節見上面第 9 題):階段 1 把 PREPARE_* 寫進交易日誌(過了這點就回不去了),階段 2 把 marker 寫進資料 partition,最後把最終狀態寫回日誌 殭屍隔離(Zombie fencing):InitPidRequest會把producer epoch加一,於是從 GC 停頓中醒來的舊 producer 實例會被拒絕 —— 這就是「exactly once」能跨 producer 重啟成立的原因- 讀取端:設定
isolation.level=read_committed的 consumer 會跳過交易已中止或仍在進行中的紀錄(它只讀到LSO,也就是 last stable offset 為止)
10) 說明 AR(Assigned Replicas)、ISR(In-sync replica)與 OSR(Out-of-Sync Replicas)?
AR (Assigned Replicas):指派給該 partition 的所有副本。AR = ISR + OSRISR (In-Sync Replicas):在replica.lag.time.max.ms(預設 30 秒)內跟得上 leader 的那些副本(包含 leader 自己)。只有 ISR 成員才可能被選為 leader(除非開了 unclean election),而acks=all的意思就是「被 ISR 裡全部的副本確認」OSR (Out-of-Sync Replicas):落後的副本 —— 磁碟慢、網路分割,或 broker 正在重啟。它們會持續拉資料,跟上之後就重新加入 ISR- 為什麼重要:
min.insync.replicas數的是 ISR,所以掉出去的副本一多,用acks=all的 producer 就會開始收到NotEnoughReplicas—— 這是刻意的設計:叢集選擇一致性而不是可用性 HW(high watermark)= ISR 裡最小的 log-end offset —— 也就是第一筆還沒完全複製完成的紀錄的 offset,所以它是開區間:consumer 可以讀它以下的全部,但永遠讀不到它本身。這就是為什麼還沒複製完的紀錄是「看不見」,而不是「讀到之後才掉」- 參考
11) 描述 kafka 的限制?
- 自動擴縮:先擴出去之後很難縮回來(要改 topic 裡的 partition 資料)
- 如果還是想要能擴能縮,可以準備兩套 kafka 叢集。(先讓流量走另一套,避免停機)
- 要讓發布出去的事件
保持全域有序很難
12) 說明 kafka 為什麼能有高 I/O?
- 順序讀寫
- zero copy
- 檔案切分
- 批次傳輸
- 資料壓縮
- 參考
13) 說明 kafka 的 topic partition 策略?
- Range 策略
- RoundRobin 策略
- 參考
14) 同一個 consumer group 裡有多個 consumer 會怎樣?
-
多個 Kafka consumer 可以從同一個 partition 讀到同一則訊息嗎?
-
Kafka 的 consumer 通常屬於某個 consumer group。當多個 consumer 訂閱同一個 topic 且屬於
同一個 consumer group時,group 裡的每個 consumer會收到該 topic 中不同子集的 partition 的訊息。 -
如果ㄧ個consumer group 裡有複數個consumer -> 每個consumer只會收到topic
部分的訊息 -
如果consumer 分屬不同 consumer group (訂閱同個topic) -> 每個consumer都會收到topic
全部訊息 -
同一個 group 裡:不行
- 同一個 group(Group 1)裡的兩個 consumer(Consumer 1、2)
不能從同一個 partition(Partition 0)消費到同一則訊息
- 同一個 group(Group 1)裡的兩個 consumer(Consumer 1、2)
-
不同 group:可以
- 分屬兩個 group 的兩個 consumer(Group 1 的 Consumer 1、Group 2 的 Consumer 1)可以從同一個 partition(Partition 0)消費到同一則訊息。
15) 串流模型?
-
訊息佇列(例如 rabbitMQ)
- 每個服務只能從佇列裡讀到部分訊息
-
pub - sub(發布、訂閱)
注意:在 kafka 裡,「consumer group」這個概念把上面兩者混合了起來
- 同一個 group 裡有多個 consumer ≈ 從佇列裡讀