FLINK FAQ
1. 什麼是 Apache Flink?
- Flink 的核心是一個用 Java 與 Scala 寫的分散式串流資料流引擎。它以資料平行、管線化的方式執行每一個資料流程式。
2. 說明 Apache Flink 的架構?
-
Flink 是
Kappa 架構會建立在上面的那種引擎,但 Kappa 是應用層的架構,不是 Flink 的內部構造。Kappa 只保留一條處理路徑 —— 所有東西都以串流進來、由串流引擎處理,批次則視為有界的串流。 -
Flink 本身
有界與無界串流都能處理(見第 4、5 題),所以它能服務 Kappa 風格的設計,但並不被它定義。它自己的架構是下面第 3 題的 JobManager / TaskManager / slot 模型。 -
參考
- 見下面的說明!!!
- https://www.shuzhiduo.com/A/amd0NwnXJg/
2’ 說明 Apache Flink 的執行圖與它的階段?
- StreamGraph -> JobGraph -> ExecutionGraph -> 實體執行圖
3. 說明 Apache Flink 的作業執行架構?
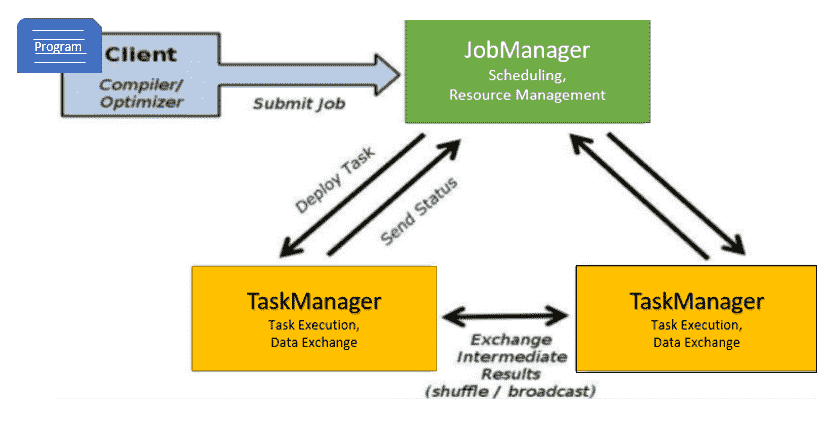
- Program
- 在 Flink 叢集上執行的那段程式碼。
- Client
- 客戶端伺服器,接收要執行的程式碼,產生作業的資料流圖,再交給 JM(job manager)。
- Job manager(JM)
- 從 Client 拿到作業資料流圖之後,負責產生執行圖。它把作業指派給叢集裡的 TaskManager,並監看執行狀況。
- 週期性地觸發
Checkpoint
- Task manager(TM)
- 負責執行 JobManager 指派給它的所有 task。兩個 TaskManager 會依指定的平行度,在各自的 slot 裡執行 task。它也負責把 task 的狀態回報給 JobManager。
4. Apache Flink 裡的無界串流(Unbounded streams)是什麼?
- 任何型態的資料都是以事件串流的形式產生的。資料可以當成無界或有界串流來處理。
- 無界串流有起點但沒有終點。它不會結束,資料產生就持續供應。
- 無界串流應該被持續處理,也就是事件一被消費就要處理掉。因為輸入是無界的、任何時間點都不會「完整」,所以不可能等所有資料到齊。
5. Apache Flink 裡的有界串流(Bounded streams)是什麼?
- 有界串流有起點也有終點。
- 有界串流可以先把所有資料都消費完,再開始計算。
- 處理有界串流不需要有序的攝入,因為有界的資料集永遠可以先排序。處理有界串流也就是所謂的批次處理。
6. Apache Flink 的 Dataset API 是什麼?
- Apache Flink 的 Dataset API 用來對一段時間內的資料做
批次運算。 - 這個 API 有 Java、Scala 與 Python 版本。
- 它可以對資料集做各種轉換,例如過濾、映射、彙總、join 與分組。
7. Apache Flink 的 DataStream API 是什麼?
- Apache Flink 的 DataStream API 用來處理持續不斷的
串流資料。 - 在串流資料上可以做過濾、路由、開窗與彙總等操作。
- 這條資料流有多種來源,例如訊息佇列、檔案與 socket 串流;產出的資料也可以寫到不同的 sink,例如命令列終端機。
8. Apache Flink 的 Table API 是什麼?
- Table API 是一套關聯式 API,語法類似 SQL。
- 它同時支援
批次與串流處理。 - 它和 Java 與 Scala 的 Dataset、Datastream API 相容。
- Table 可以由內部的 Dataset 與 Datastream 產生,也可以來自外部資料源。你可以用這套關聯式 API 做 join、select、彙總與過濾等操作。
9. Apache Flink 的 FlinkML 是什麼?
- FlinkML 是 Flink 的機器學習(ML)函式庫。
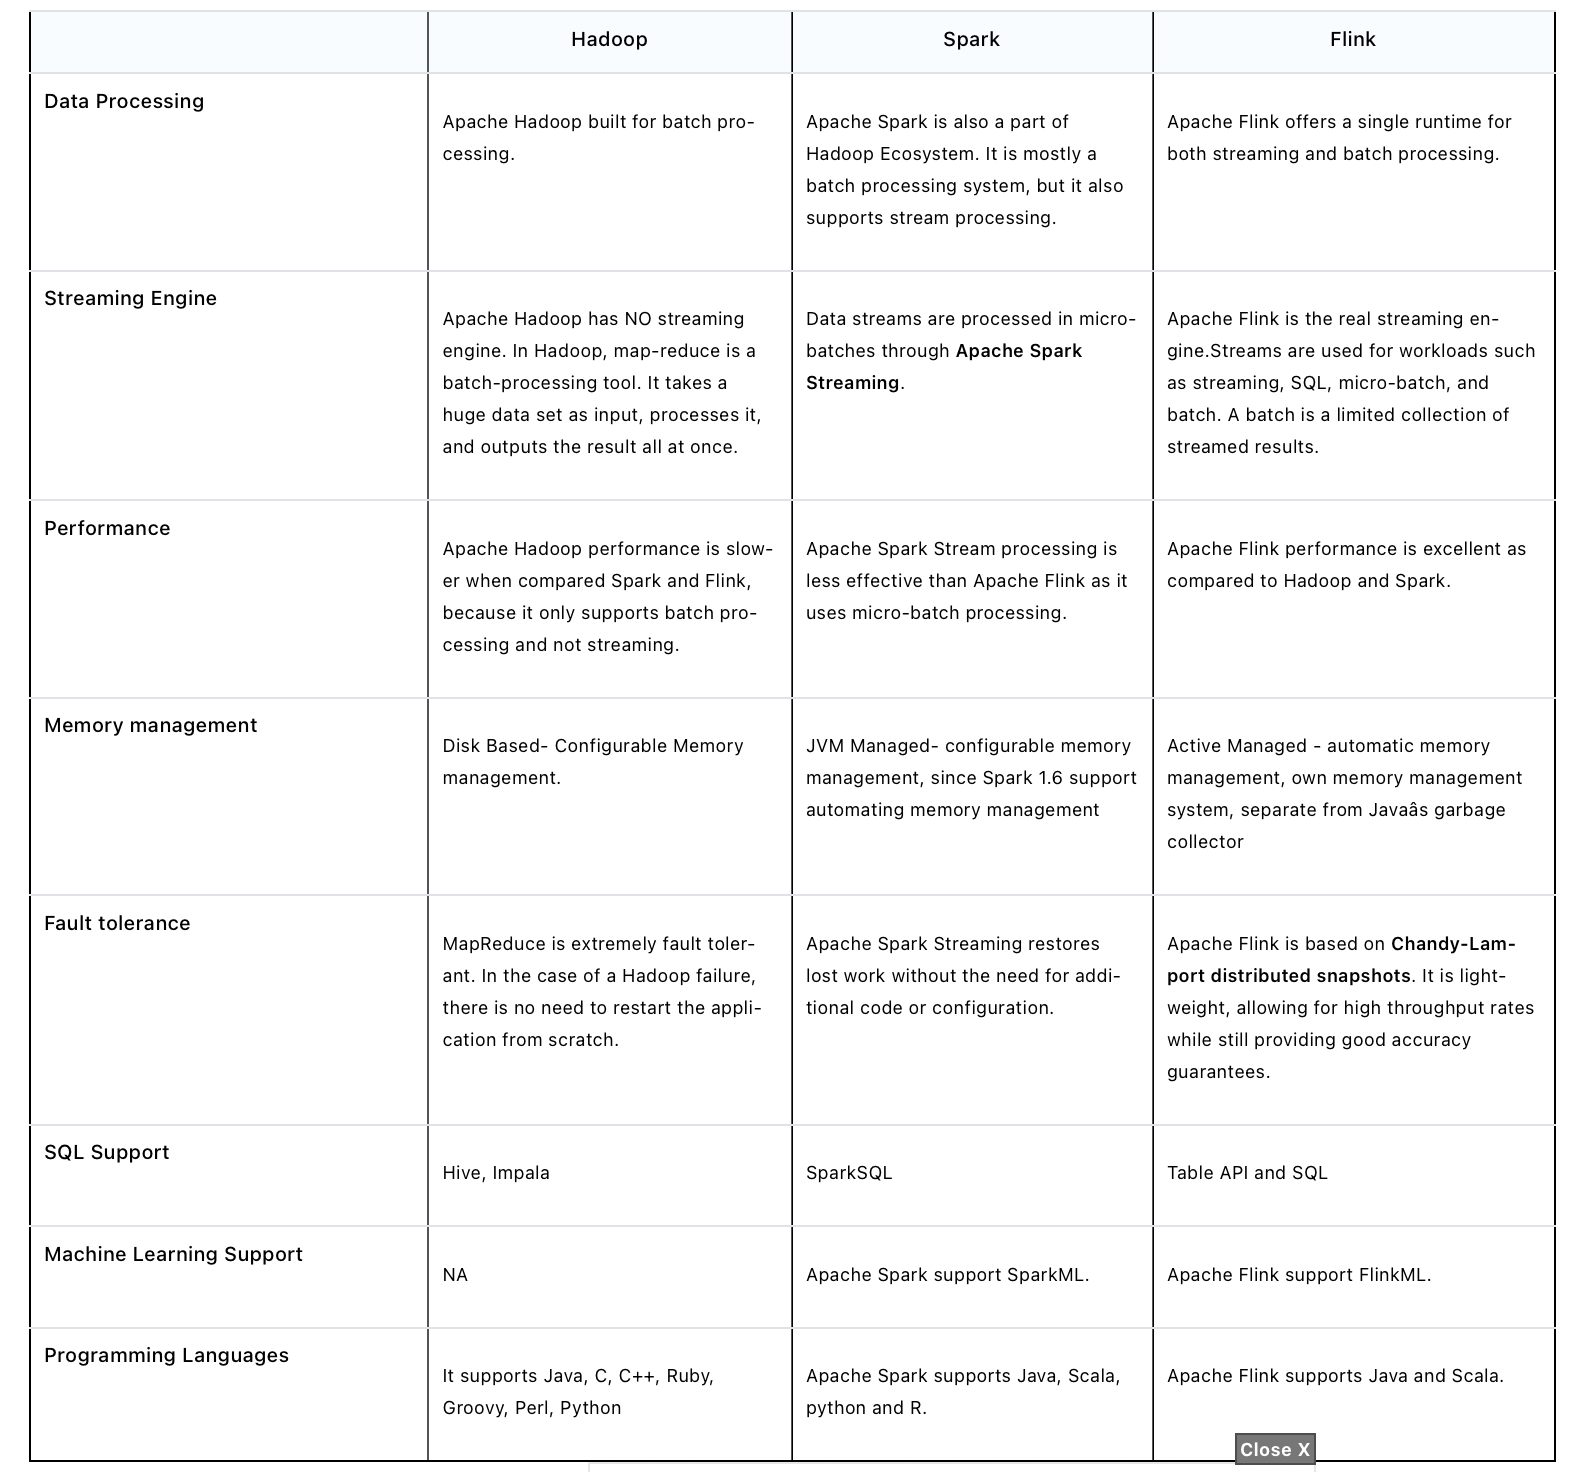
10. Apache Hadoop、Apache Spark 與 Apache Flink 差在哪?
11. 一個 Flink 串流應用的關鍵程式結構有哪些?
- 一個 Flink 串流應用由四個關鍵結構組成。
-
- 串流執行環境 —— 每個 Flink 串流應用都需要一個執行環境。
-
- 資料來源 —— Flink 應用從這些應用程式或資料儲存讀入輸入資料。
-
- 資料流與轉換操作 —— 來自資料來源的輸入,會以資料流的形式被 Flink 應用讀入。
-
- 資料 sink —— 轉換後的資料由 sink 消費,輸出到外部系統。
-
12. 說明複雜事件處理(Complex Event Processing, CEP)?
- FlinkCEP 是 Apache Flink 裡的一套 API,用來在持續的串流資料上分析事件模式。這些事件接近即時,具有高吞吐與低延遲。這套 API 最常用在感測器資料上 —— 它們即時湧入,而且處理起來很複雜。
- CEP:用於複雜事件處理。
- https://www.tutorialspoint.com/apache_flink/apache_flink_libraries.htm
13. Apache Flink 有哪些特定領域的函式庫?
- FlinkML:機器學習。
- Table:做關聯式運算。
- Gelly:做圖運算。
- CEP:複雜事件處理。
- https://www.cloudduggu.com/flink/interview-questions/
14. Apache Flink 有哪些使用方式?
Apache Flink 可以用下列方式部署與設定。
- 可以在本機(單機)安裝。
- 可以部署在虛擬機上。
- 可以用 Flink 的 Docker image。
- 可以設定並部署成 standalone 叢集。
- 可以部署在 Hadoop YARN 或其他資源管理框架上。
- 可以部署在雲端系統上。
15. 說明 flink 怎麼實作 exactly once?邏輯與機制是什麼?
分散式快照(distributed snapshot)兩階段提交(2 phases commit)- TwoPhaseCommitSinkFunction
- 步驟)
- 步驟 1) 每個 checkpoint,flink 都會開一筆「交易」,把所有資訊加進這筆交易
- beginTransaction
- 交易開始前先建一個暫存檔,資料先寫進去
- beginTransaction
- 步驟 2) 資料 sink 到外部系統時不直接 commit,而是
預提交(pre-commit)- pre-commit
- 把記憶體裡的資料「flush」到暫存檔,然後關檔。下一個 checkpoint 重複這一步
- pre-commit
- 步驟 3) flink 收到 checkpoint 的確認之後,才提交這筆交易,資料這時才「真的」寫進外部系統
- commit
- 把暫存檔搬到真正的目的路徑。可能會有一點延遲
- commit
- 注意:外部系統本身也要有「交易」機制,才能做到端對端的 exactly once
- 步驟 1) 每個 checkpoint,flink 都會開一筆「交易」,把所有資訊加進這筆交易
- 參考
16. 說明 flink 的 savepoint?
savepoint是 flink 在某個時間點狀態的「全域備份」- 用於軟體升級、改設定。可以讓 flink 從上一個 savepoint 重新啟動
- 由使用者觸發
- 會一直保留到使用者刪掉為止
- 可以把
savepoint理解成某個特定時間點、checkpoint的一份特殊快照 - 觸發方式
flink savepoint指令- 取消 flink 作業時用
flink cancel -s指令 - 透過 REST API:
**/jobs/:jobid /savepoints**
- 參考
17. 說明 flink 的 checkpoint?
- checkpoint 保存 flink 當下的狀態,是一種「容錯」機制
- flink 的狀態
- Operator 狀態:例如 offset
- KeyedState 狀態:例如 MapState、ListState、ValueState
- flink 的狀態
- 確保 flink 在執行期出錯時能自動復原
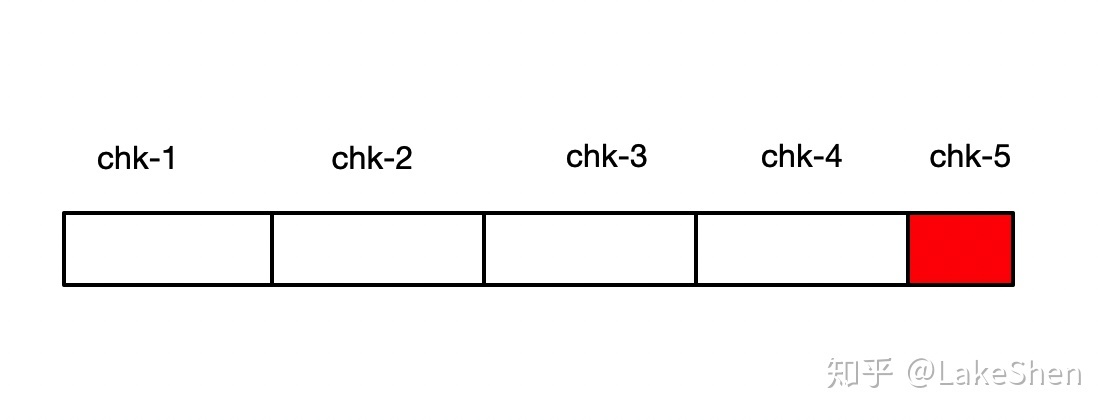
- 例子:如果 flink 在 chk-5 失敗,它會試著從 chk-4 復原
- 由 flink 管理與操作。使用者只需要設定參數
- flink 自動執行
- 預設
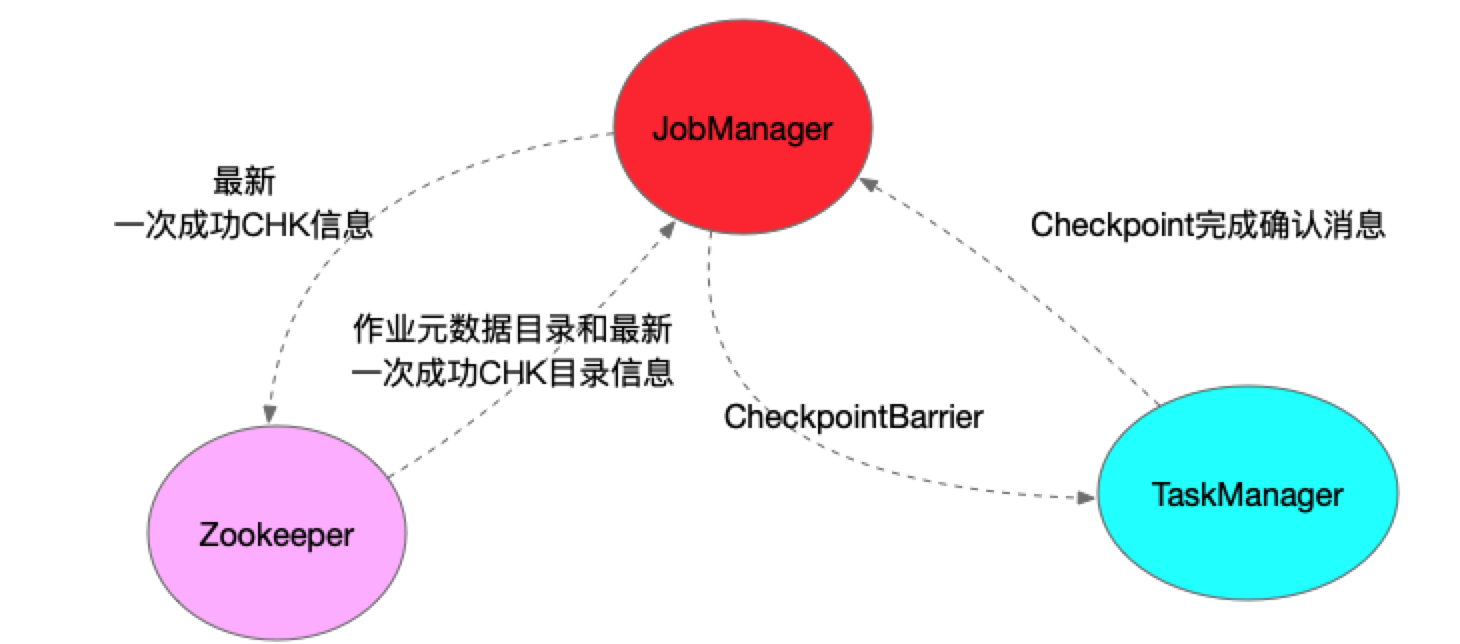
concurrent = 1-> 每個 flink 應用同時只會有一個在跑 - 誰參與其中:
JobManager的 CheckpointCoordinator、執行這些 task 的TaskManager,以及設定好的checkpoint 儲存(HDFS / S3 / 檔案系統)。ZooKeeper 只在 HA 架構下出現,而且是負責 leader 選舉與 checkpoint 的中繼資料指標 —— 從來不是存放狀態本身的地方 - 機制
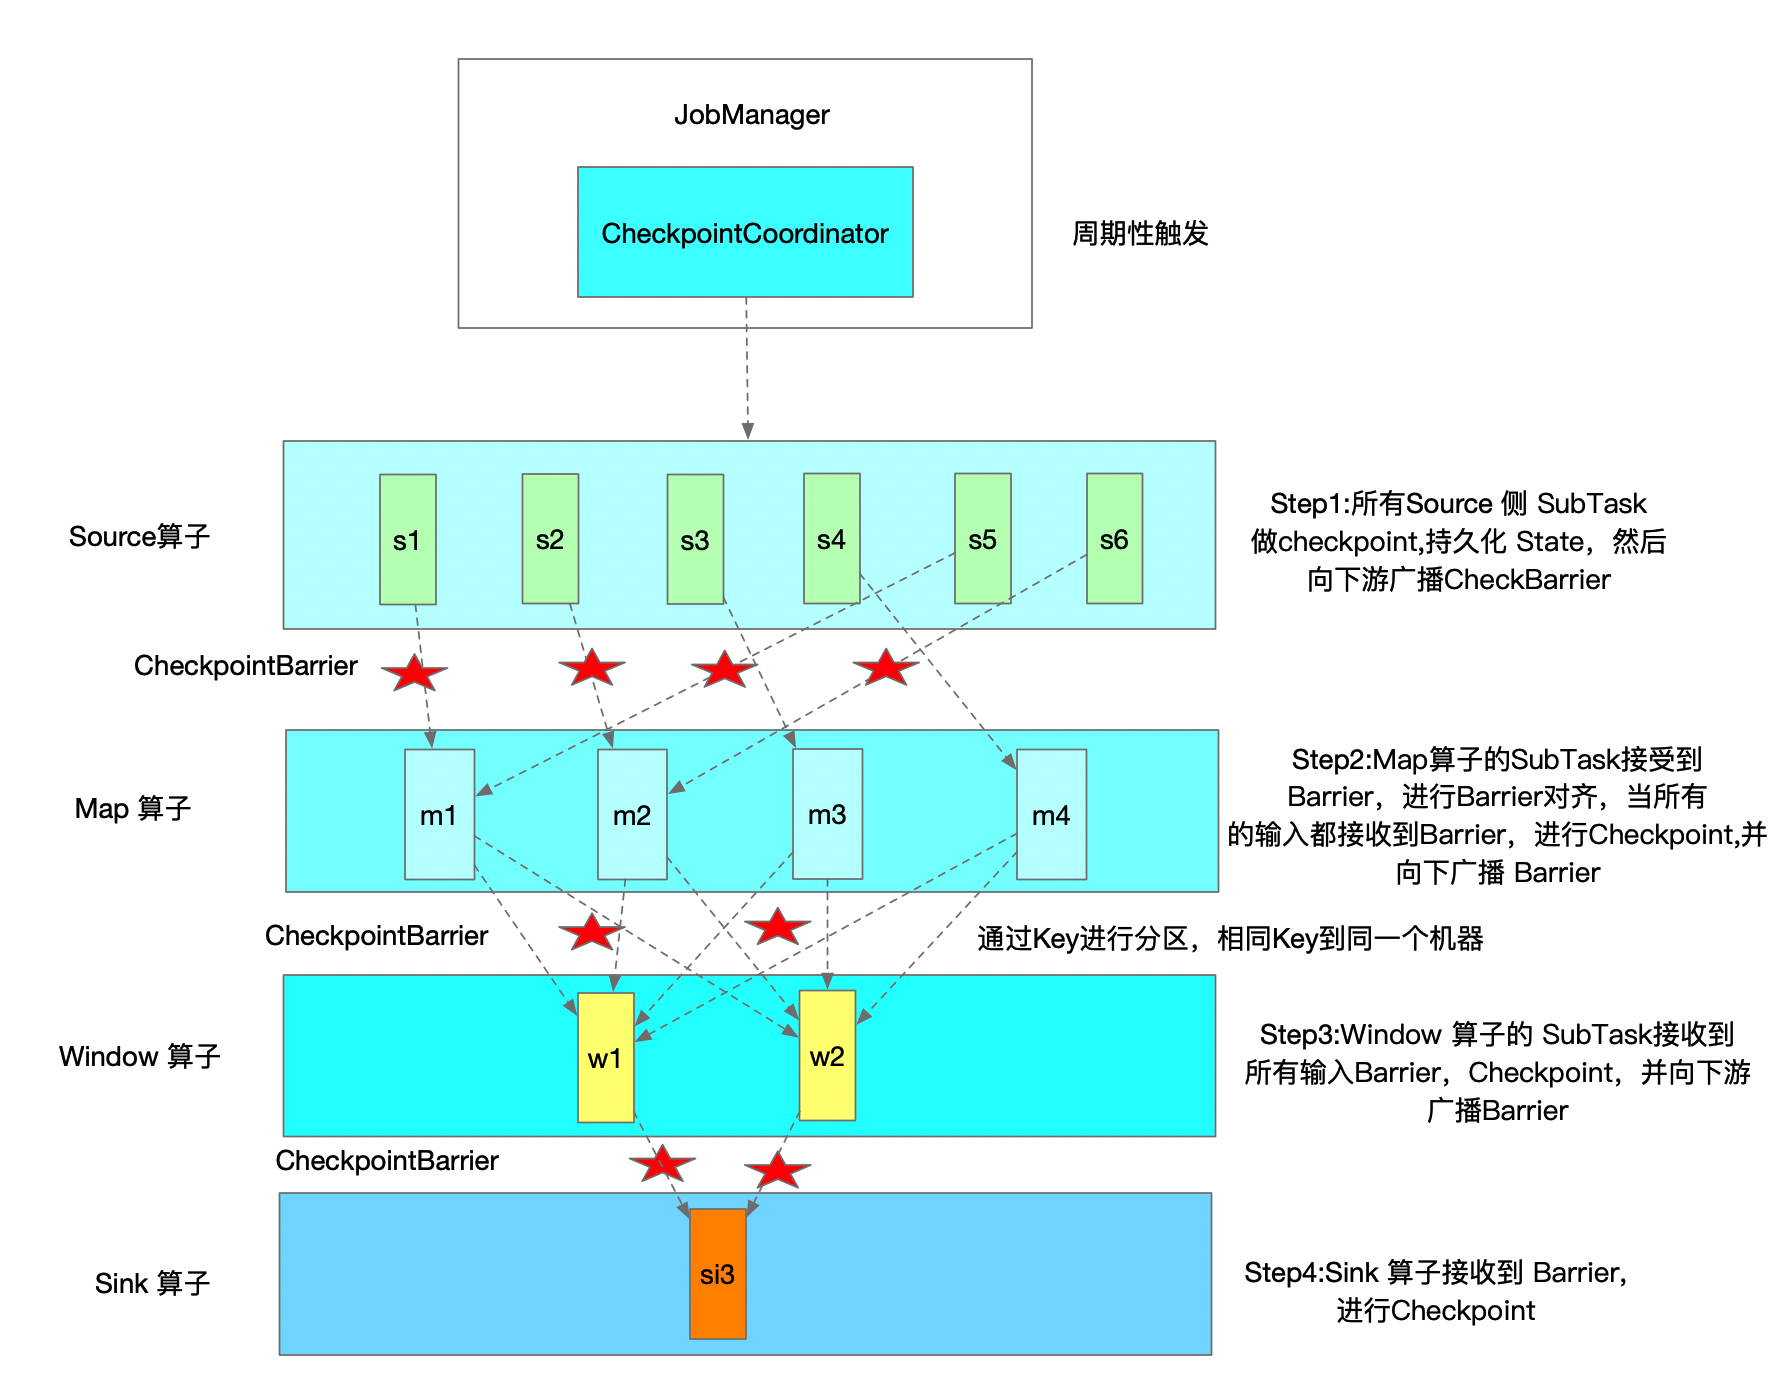
- JM 週期性地觸發 checkpoint
- 在
aligned(對齊,預設)checkpoint 下,一個 task 要等 barrier 從每一個輸入都抵達才做快照 —— 所以雙輸入的 operator 不會在第一個 barrier 就快照,它會把那條 channel 緩衝起來等其他的追上。而unaligned(非對齊,1.11+)則不等待就快照,改成把在途的紀錄一起持久化,這就是它能在背壓下讓 checkpoint 繼續推進的原因。兩種模式都一樣會把狀態寫進 checkpoint 儲存,然後向 coordinator 回報確認。checkpoint 要等到CheckpointCoordinator 收到每一個參與 task 的確認才算完成 —— 不是 sink 看到 barrier 就算- 狀態寫進設定好的 checkpoint 儲存;在 HA 架構下,ZooKeeper 保存的是指向最近一次完成的 checkpoint 的指標,讓新的 JobManager 找得到它
- CheckpointBarrier 是一種特殊事件,會跟著紀錄往下游流動;barrier 抵達 sink 代表那個 operator 可以做快照了,不代表 checkpoint 已完成 —— coordinator 還得把每一份確認都收齊
- 注意:CheckpointBarrier 的對齊時間也要一併考慮
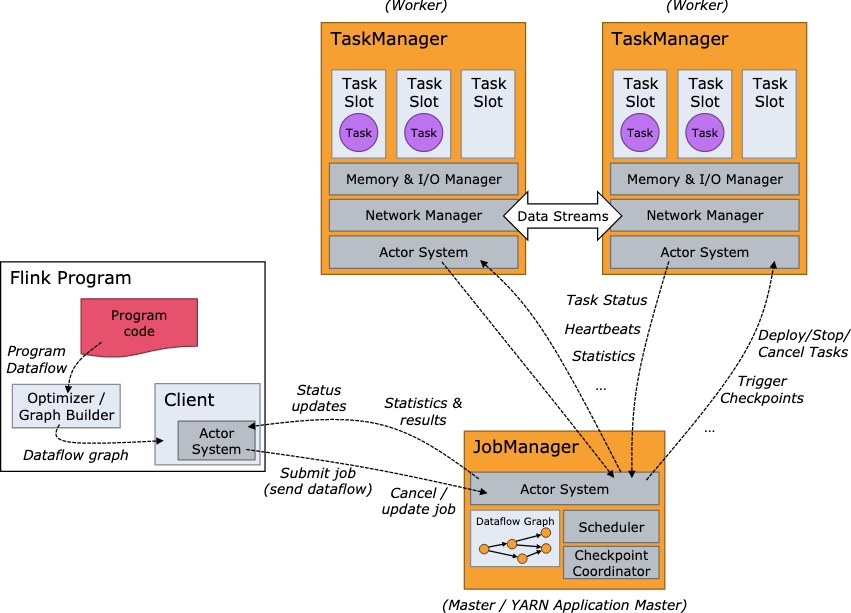
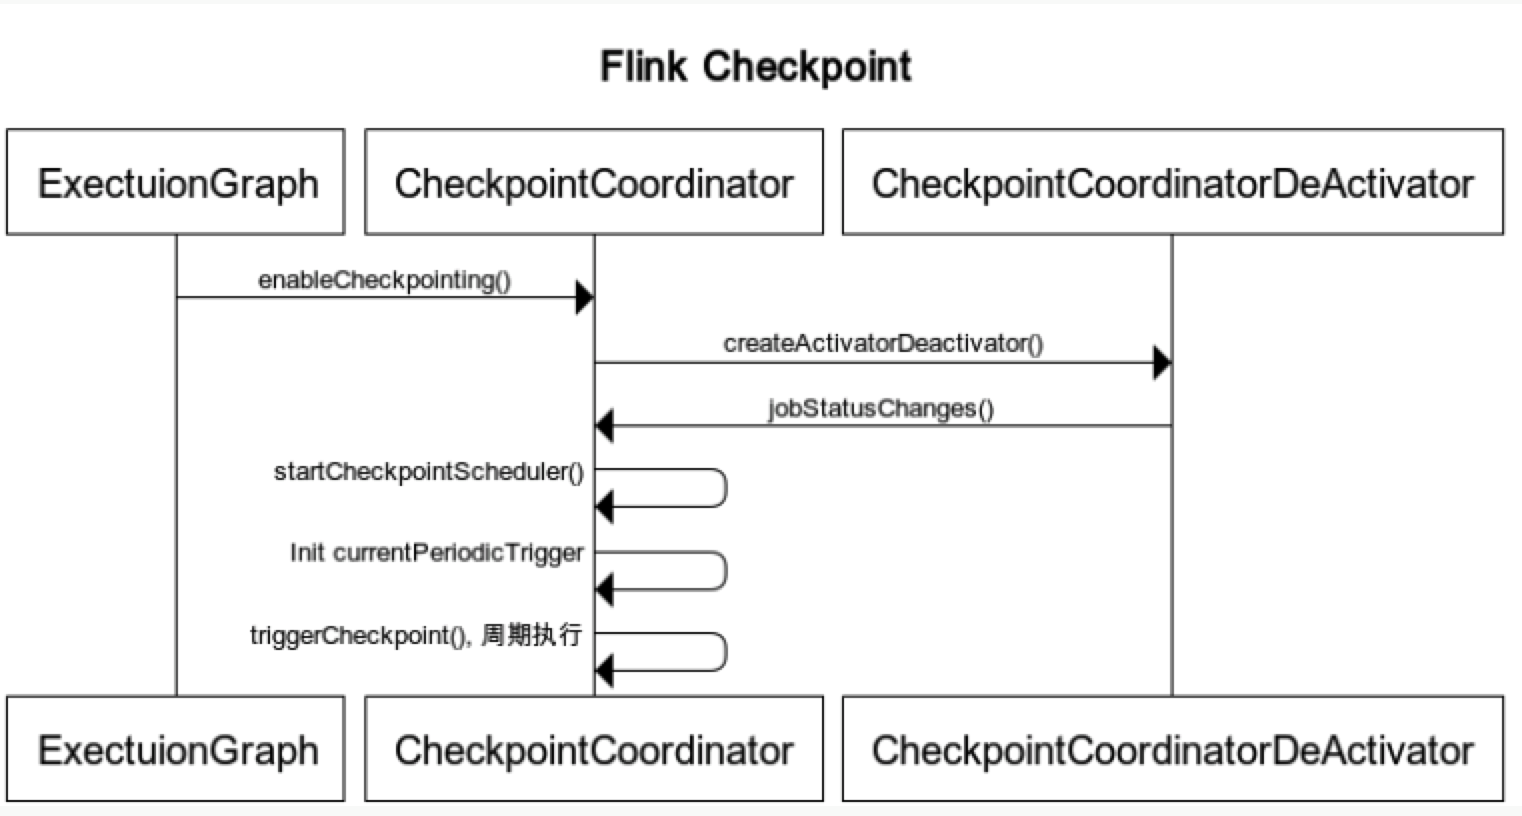
CheckpointCoordinator是 checkpoint 運作裡很重要的一個類別- 它有以下幾個重要方法
- triggerCheckpoint
- triggerSavepoint
- restoreSavepoint
- restoreLatestCheckpointedState
- receiveAcknowledgeMessage
- 它有以下幾個重要方法
- 用
CheckpointConfig設定關閉 checkpoint- DELETE_ON_CANCELLATION:程式被取消時刪掉 checkpoint
- RETAIN_ON_CANCELLATION:程式被取消時保留 checkpoint
- checkpoint 失敗的常見原因:
- 客戶端或外部系統的程式碼沒有處理例外
- 例如 json 解析錯誤、逾時、sink 系統丟例外
- 頻繁 GC、記憶體不足 -> 造成 OOM
- 網路問題、機器問題
- 客戶端或外部系統的程式碼沒有處理例外
- 參考
17’ 說明 flink 的 Barrier?
- 一種特殊事件
- 會跟著事件從上游 operator 流到下游 operator
- 每個 operator 在 Barrier 抵達時做快照 —— 在對齊式 checkpoint 下,意思是它要從
所有輸入都收到才做 —— 並向 CheckpointCoordinator 回報確認;checkpoint 要等到coordinator 收齊每一個參與 task 的確認才算完成,sink 也包含在內
18. 說明 flink 的背壓(backpressure)?
-
這是串流框架裡常見的概念
-
它發生在
「下游」跟不上「上游」的處理速度時- -> 於是有一套機制
往回推給上游,要它們慢一點
- -> 於是有一套機制
-
成因可能是網路、磁碟 I/O、頻繁 GC、資料熱點……或資料傾斜、程式效率、TM 記憶體與它的 GC
-
它也會影響 checkpoint
- 資料延遲 -> checkpoint 也跟著延遲(變更久)
- 如果要 exactly once -> 得等延遲的 barrier -> 更多資料被快取 -> checkpoint 變更大
- 上述都可能讓 checkpoint 失敗,或造成 OOM
-
可以透過 Flink UI 監看(1.13 以上版本)
-
背壓不見得都是問題,有時候它代表系統把資源用滿了。但嚴重的背壓會造成系統延遲
-
參考
18’. 說明 flink 的資料交換機制?
- 同一個 Task 內的交換
- 不同 Task、同一個 TM 的交換
- 不同 Task、不同 TM 的交換
- 參考
19. 說明 flink 怎麼把作業提交到 yarn?
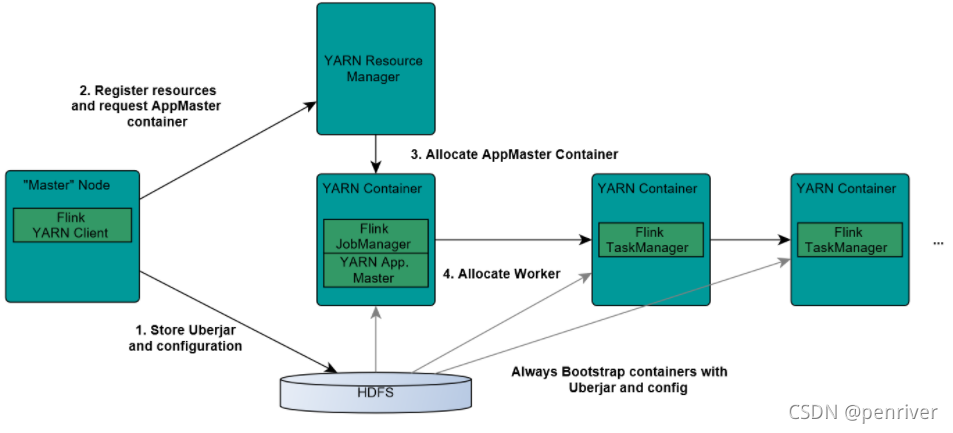
- 元件
- ResourceManager(RM)
- NodeManager(NM)
- AppMaster(
job manager 跑在同一個 container 裡) - Container(task manager 跑在上面)
- 步驟
- 步驟 1) flink client 把
flink jar、應用 jar 與設定檔上傳到 HDFS - 步驟 2) client 把作業提交給 Yarn ResourceManager,並登記資源
- 步驟 3) ResourceManager 配發 container 並啟動
AppMaster,AppMaster 接著載入 jar、設定環境,然後啟動job manager - 步驟 4) 上述步驟成功後,AppMaster 就知道 job manager 的 ip
- 步驟 5) Job Manager 為 task manager 產生一份新的 flink 設定,這份設定也上傳到 HDFS。AppMaster 提供 flink web 服務的端點
- 注意:Yarn 提供的端點都是暫時性的,使用者可以在 Yarn 上跑多個 flink
- 步驟 6) AppMaster 向 ResourceManager 要資源。NodeManager 載入 flink jar 並啟動 TaskManager
- 步驟 7) TaskManager 啟動成功後,對 job manager 送 heartbeat,準備執行任務(job manager 的指令)
- 步驟 1) flink client 把
- 優點:
- 「要用才拿」-> 可以提高系統的記憶體使用率
- 可以依 Yarn 作業的優先序設定,按「優先序」執行工作
- 可以自動處理
各種角色的 failover- JobManager、TaskManager 出錯……Yarn 都能自動重試/重跑
- 圖
- 參考
20. 說明 flink 的 watermark?
watermark是一個時間戳(事件發生的時間,不是被處理的時間)watermark告訴 Flink從什麼時候起就不必再等遲到的事件了- 串流框架用它來「判斷是否還有事件沒到」
- 種類
- Punctuated Watermark
- 有「特殊事件」時才產生 watermark
- 和視窗時間無關,取決於何時收到「特殊事件」
- 通常用在「真・即時」的場景
- Periodic Watermark
- 週期性地產生 watermark
- 時間間隔可以由使用者設定
- Punctuated Watermark
- 例子:
- 「亂序(out-of-order)」
watermark的時間戳 > 視窗的 endTime- 表示 (window_start_time, window_end_time] 之間還有資料
- 「遲到元素(late element)」的情況
watermark抵達之後 -> 觸發window-> 做運算
- 「亂序(out-of-order)」
- 參考
21. 說明 flink 的 EventTime、IngestionTime、ProcessingTime?
EvenTime- 「事件發生的時間」。事情真正發生當下最準確的時間
IngestionTime- 事件被攝入 Flink 的時間,也就是 source operator 建立它的時間。多數情況下是 Flink job manager 的系統時間
ProcessingTime- 事件被處理的時間。是轉換發生當下的時間戳,由 Flink task manager 產生