資料庫與資料倉儲 FAQ
1) 資料庫的類型
- RDBMS(SQL)(關聯式資料庫管理系統)
-
MySQL
- ACID 相容性:部分版本相容
- SQL 標準相容性:部分版本相容
- 常被選用在只需要單純資料交易的網站專案上。不過負載一重、 或要跑複雜查詢時,MySQL 的表現就會下滑。
- 在需要讀取速度的 OLAP/OLTP 系統裡,MySQL 表現不錯。
- MySQL + InnoDB 在 OLTP 場景提供相當好的讀寫速度。整體來說, MySQL 在高併發場景下表現良好。
- MySQL 穩定,和商業智慧(BI)應用搭配得不錯,因為 BI 應用 通常是讀取為主。
- MySQL 支援 JSON 資料型別,但沒有其他 NoSQL 功能,而且 不支援對 JSON 建索引
- 支援暫存表,但不支援 materialized view。
-
PostgreSQL
- ACID 相容性:完整支援 ACID
- SQL 標準相容性:幾乎完全相容
- 廣泛用在讀寫速度關鍵、且資料需要被驗證的大型系統。此外, 它支援許多原本只有商業方案(例如 Oracle、SQL Server)才有的效能最佳化,例如地理空間資料支援、讀取不上鎖的並發等等。
- PostgreSQL 的效能在需要執行複雜查詢的系統裡發揮得最好。
- 在需要讀寫速度、又要做大量資料分析的 OLTP/OLAP 系統裡, PostgreSQL 表現很好。
- PostgreSQL 也能搭配 BI 應用,但更適合資料倉儲與需要 快速讀寫的資料分析應用。
- PostgreSQL 支援 JSON 與其他 NoSQL 功能,例如原生的 XML 支援與用 HSTORE 存 key-value。它也支援對 JSON 資料建索引, 讓存取更快。
- 支援 materialized view 與暫存表。
-
MySQL 與 PostgreSQL
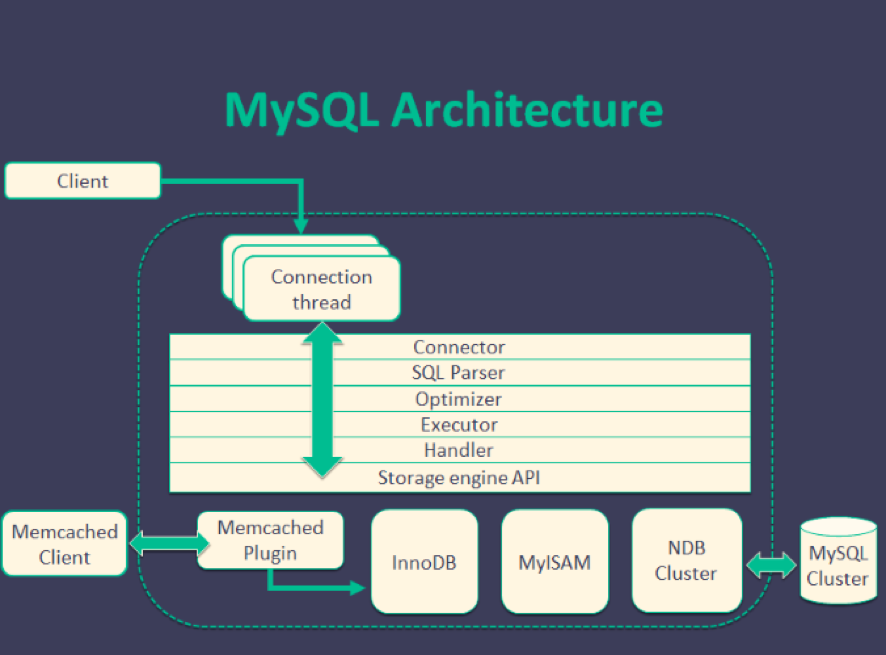
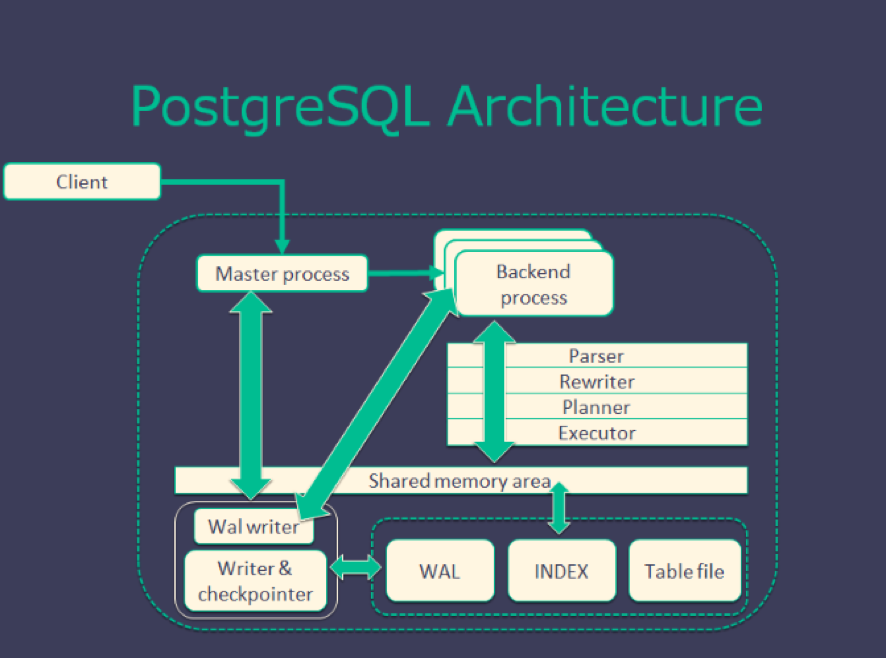
- 架構
- 授權
- 開發風格
- MySQL:
- 多執行緒
- 可自訂的儲存引擎讓存資料更有彈性
- 可以用
INSERT指令把資料存進 memcached - 可以從從伺服器(叢集)更新資料
- PostgreSQL:
- 多行程
- 資料必須存在 RDBMS 裡(遵守嚴格規則)
- 不能從從伺服器(叢集)更新資料
- MySQL:
- 參考
- 架構
-
MSSQL/DB2/Oracle/SQLITE……
-
- NoSQL
- MongoDB
- Redis
- 其他
2) 資料庫的性質
- RDBMS
- ACID:atomicity(原子性)、consistency(一致性)、isolation(隔離性)、durability(耐久性)
-
原子性 Atomicity
- 保證一筆交易要嘛全部成功,要嘛完全不生效。不會有一部分成功、 另一部分沒成功的情況。交易裡任何一步失敗,整筆交易就失敗。原子性就是「全有或全無」。
-
一致性 Consistency
- 保證所有資料都會是一致的。所有資料都會符合已定義的規則, 包含資料庫上的各種約束、cascade 與觸發器。
-
隔離性 Isolation
- 保證所有交易都在彼此隔離的狀態下發生。任何交易都不會被其他 交易影響。所以一筆交易讀不到另一筆還沒完成的交易的資料。
-
耐久性 Durability
- 交易一旦提交,就會留在系統裡 —— 就算提交之後系統立刻 崩潰也一樣。交易造成的任何變更都必須永久保存。如果系統告訴使用者交易成功了,那筆交易就 必須真的成功了。
-
- ACID:atomicity(原子性)、consistency(一致性)、isolation(隔離性)、durability(耐久性)
3) 資料庫設計
-
流程
-
概念
-
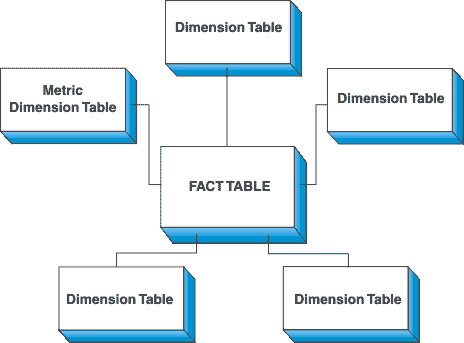
星型 STAR SCHEMA
- 形狀像星星,
FACT 表是星星的中心,其他是描述 FACT 表屬性的維度表。 - 各個
維度表彼此獨立
- 形狀像星星,
-
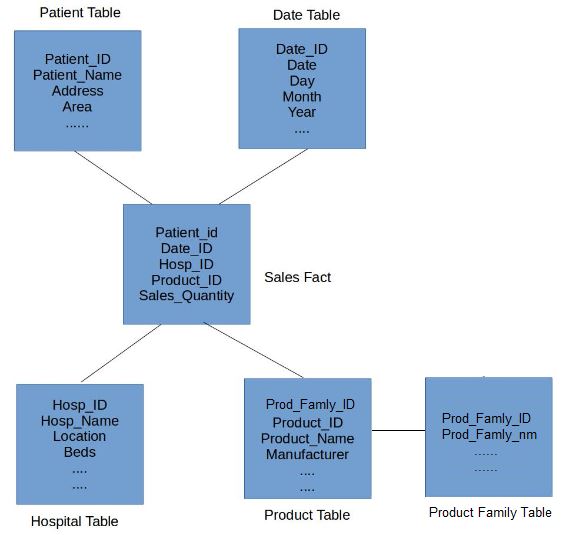
雪花 SNOWFLAKE SCHEMA
- 其實是星型 schema 的延伸
- 中心是
FACT 表,其餘是維度表;差別在於:維度表是可以再展開的, 也就是可以一路串起多層維度表 - 優點:可以把每個維度表的資料量切小 ->
join之類的操作更快 - 缺點:要多維護一些表
-
星系 GALAXY SCHEMA
- 星系 schema 有多張事實表,並共用一些維度(一致維度)。這個 schema 相當於許多 data mart 的組合。
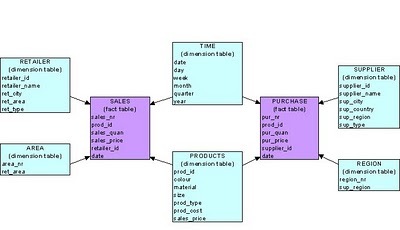
-
範例
4) 索引
-
什麼是資料庫索引?
-
資料庫索引是一種資料結構,用來加快資料表上讀取資料的速度,代價是維護這個索引結構所需的額外寫入與儲存空間。有了索引,就不必每次存取資料表時都掃過每一列。索引可以用資料表的一個或多個欄位建立,既能做快速的隨機查找,也能有效率地依序存取紀錄。
-
索引是資料表中某些欄位的一份副本,它能被非常有效率地搜尋,同時附帶低階的磁碟區塊位址、或直接連到它複製而來的那整列資料。有些資料庫把索引的能力延伸到讓開發者對函式或運算式建索引。例如可以對 upper(last_name) 建索引,那麼索引裡只會存 last_name 的大寫版本。另一個有時會支援的選項是部分索引(partial index):只為滿足某個條件式的紀錄建立索引項目。再進一步的彈性是允許對使用者自訂函式、以及由各種內建函式組成的運算式建索引。
-
為什麼要索引?
-
FULL TABLE SCAN -> INDEX SCAN(平衡樹)-> INDEX SEEK
-
全表掃描 Full table scan:
- 這就是所謂的 Full Table Scan,或簡稱 Table Scan。在各種資料搜尋方式裡,Table Scan 是最貴的。
-
索引掃描 Index scan:
- Index Scan 只是從第一頁掃到最後一頁地掃過那些資料頁。如果表上有索引,而查詢要碰的資料量很大(例如撈超過 50% 或 90% 的資料),最佳化器就會乾脆掃過所有資料頁來取資料。如果沒有索引,你在執行計畫裡看到的就會是 Table Scan(Index Scan)。
-
索引定位 Index seek:
- Index seek 一般用在選擇性很高的查詢上。也就是說,查詢只要求少量的列,或說只撈表裡 10%(有些文件說 15%)的列。
-
一般來說查詢最佳化器會盡量用 Index Seek,也就是它找到了一個有用的索引來撈資料集。但如果做不到 —— 沒有索引,或表上沒有有用的索引 —— SQL Server 就只能掃過所有符合查詢條件的紀錄。
-
https://blog.sqlauthority.com/2007/03/30/sql-server-index-seek-vs-index-scan-table-scan/
-
-
索引有哪些類型?
-
叢集索引 Clustered index
- 每張表只能有一個
- 存在
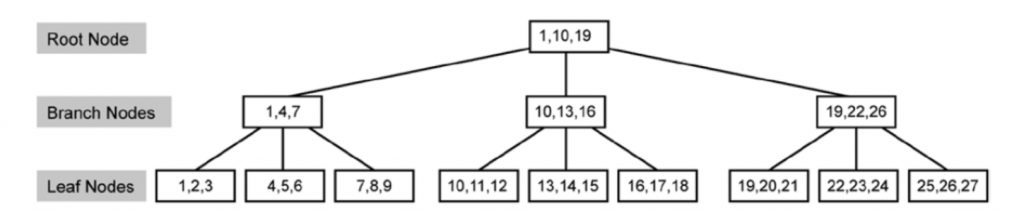
資料庫的硬碟上 - 資料結構用「B-Tree」(平衡樹),元件有:Root/中間/leaf 節點
- Heap(沒有索引時,資料無序)-> B-tree(有索引時,資料有序)
- 如果已經設了
主鍵,資料庫預設就會把主鍵當成叢集索引 - 避免把
經常更新的欄位設成叢集索引,因為每次資料更新,系統都得花時間重排資料 - 避免把
不重複的資料欄位設成叢集索引,因為這種索引對where條件來說不是有效的過濾器 - 避免把
太長/太多的欄位設成叢集索引,因為重排時會給系統很重的負擔
-
非叢集索引 Non-Clustered index
- 每張表可以有很多個(但理想上 < 5 個)
- 透過資料庫硬碟上的叢集索引指向資料
- 同樣用「B-Tree」資料結構維持排序
- 是叢集索引的補充
-
覆蓋索引 Covering Index
- 一個索引建在
多個欄位上 - 利用
既有的非叢集索引,把(覆蓋索引涵蓋的)欄位複製到 leaf 節點,於是 index scan/seek 也能透過平衡樹完成 高密度的欄位是好選擇- 理想上不要包含超過 3 個欄位
- 一個索引建在
-
帶 include 的索引
- 索引 include 欄位
-
索引檢視 Indexed View
View是資料庫裡的一個邏輯定義,不是真的表。Indexed View 可以當成中間檢視,讓查詢直接從它開始,而不必每次都帶著複雜的語法回到原始表。
-
過濾索引 Filtered Index
-
(叢集索引示意圖)
-
-
用索引與不用索引之間的取捨
-
主要考量:資料更新時的索引維護成本
-
-
建一個新索引時,資料庫伺服器底層發生了什麼事?
5) 資料庫調校
- 出手順序(最便宜、收益最高的先做)
- 步驟 1)
找出慢查詢——slow query log、pg_stat_statements,或 APM 裡依總時間排的前 N 名。去優化一個沒人在跑的查詢是白費工 - 步驟 2)
讀執行計畫——EXPLAIN ANALYZE。注意大表上的Seq Scan、估算列數差了好幾個數量級(統計資訊過期 ->ANALYZE)、對大量列跑 nested loop,或排序溢寫到磁碟 - 步驟 3)
索引—— 新增或重新設計,讓條件與 join key 都被涵蓋(見 8/9)。然後再確認執行計畫真的用了它 - 步驟 4)
改寫查詢—— 拿掉SELECT *、避免對已建索引的欄位套函式(WHERE date(ts) = …會讓索引失效)、把相關子查詢改成 join、用 keyset 而不是OFFSET分頁、把 N+1 次往返併成一句 SQL - 步驟 5)
schema—— 選對資料型別、對超大的 append-only 表按時間分區、把讀取很熱的 join 反正規化 - 步驟 6)
伺服器/基礎設施—— 連線池(資料庫死於連線太多,遠早於死於 CPU 太多)、buffer pool/shared_buffers大小、讀取複本,最後才是前面加快取
- 步驟 1)
- 一次只改一件事,而且要對著真實的資料量量測 —— 表一長大,執行計畫就會翻盤
6) 資料庫維運
備份與還原:全量 + 增量(或用 WAL/binlog 做時間點還原)。只有在還原演練過、而且對著 RTO/RPO 計時過之後,那份備份才算真的存在高可用:主庫 + 複本並自動故障轉移;要知道你的複製是非同步(快,但可能掉最後幾筆寫入)還是同步(不掉資料,但寫入較慢)Schema 遷移:納入版本控制、只往前不回頭(Flyway/Liquibase/Alembic),零停機就用 expand-then-contract —— 先加欄位、回填、雙寫、切換讀取,最後才刪掉舊的監控:連線數、複製延遲、慢查詢、buffer 命中率、鎖等待、磁碟餘裕,以及最後一次成功備份到現在多久了存取控制:最小權限的角色、不要共用 superuser、每個服務各自的憑證、傳輸中與靜態都加密維護:更新統計資訊(ANALYZE)、處理膨脹/vacuum(Postgres)、重建索引、保留與歸檔作業
7) 案例研究
- gcloud 上的 NeoDDL
8) 叢集索引
叢集索引定義了列在實體上的順序—— 表本身就是索引(它的 leaf 層存的就是完整的列)- 因此
每張表最多一個 - InnoDB 一定有一個:
PRIMARY KEY(或第一個 unique not null 的鍵,或一個隱藏的 row id) - 對叢集鍵做範圍掃描是順序 I/O -> 非常快
- 因此
次要(非叢集)索引存的是鍵 -> 指標。在 InnoDB 裡那個指標就是主鍵,所以一次查找要走兩趟B+tree:索引 -> PK -> 列(所謂的 bookmark lookup)。覆蓋索引(包含查詢需要的每個欄位)可以省掉第二趟- 設計上的後果:主鍵要
短、單調遞增、不可變- 隨機的 UUID 主鍵會讓插入散落在整棵 B+tree(頁分裂、快取局部性差),還會讓每個次要索引都變胖 —— 優先用自動遞增 id,或依時間排序的 ULID/UUIDv7
- Postgres 不一樣:它的表是 heap,所以沒有叢集索引 ——
CLUSTER是一次性的實體重排,不是一個會被維持的性質
9) 索引
- 結構:幾乎都是
B+tree—— 查找O(log n),而且 leaf 之間有連結,所以範圍掃描與ORDER BY都是免費送的。其他還有:hash(只能等值)、bitmap(低基數、分析用)、GIN/GiST(全文、陣列、地理)、LSM-tree(寫入為主的儲存) 複合索引 + 最左前綴:建在(a, b, c)上的索引可以服務WHERE a、WHERE a AND b、WHERE a AND b AND c。單獨的WHERE b通常用不到它 —— 有些引擎可以對低基數的前導欄位做 skip scan(Oracle、MySQL 8 的部分計畫、PostgreSQL 18),但別指望它。等值條件的欄位放前面,範圍條件的放最後選擇性:索引要能濾掉大部分的列才划算。在只有 2 種值的欄位上,最佳化器會(正確地)選擇全表掃描- 會讓索引悄悄失效的東西
- 對欄位套函式或轉型:
WHERE YEAR(created_at) = 2026會讓created_at上的普通索引失效 -> 改寫成範圍WHERE created_at >= '2026-01-01' AND < '2027-01-01',或建一個對應的運算式/函式索引(Postgres、MySQL 8、Oracle),讓這個條件本身被索引 - 前導的萬用字元:
LIKE '%foo' - 跨不同欄位的
OR(常見),以及隱含型別轉換(WHERE varchar_col = 123) - 某些引擎上的
IS NULL/!=
- 對欄位套函式或轉型:
- 成本:每個索引在
每次 INSERT/UPDATE/DELETE 都要被寫,也會佔用 buffer pool 的記憶體。沒用到的索引與重複的索引純粹是負擔 —— 有(a, b)時,(a)上的索引通常是多餘的,但要先確認:比較窄的索引比較小(掃起來也比較便宜),而(a, b)完全不隱含UNIQUE (a)這個約束
10) 正規化與反正規化
正規化—— 消除冗餘,讓每一則事實只住在一個地方1NF:值是原子的,沒有重複的群組2NF:1NF + 沒有對複合鍵某一部分的部分相依3NF:2NF + 沒有遞移相依(一個非鍵欄位相依於另一個非鍵欄位)- 還有 BCNF 與更高階;實務上
OLTP 的 schema 停在 3NF - 好處:不會有更新異常 —— 改一次客戶地址,而不是改四萬列訂單
反正規化—— 刻意複製資料以避開 join- 代價:副本之間可能不一致,而且每次寫入都得維護它們
- 讀取為主、而 join 就是瓶頸時再用:倉儲裡的
星型 schema(事實表 + 寬維度表)、materialized view,或用一個計數欄位取代COUNT(*)
- 經驗法則:
寫入模型正規化,讀取模型反正規化—— 和 CQRS 是同一個切法。也見下面第 15 題
11) SQL 效能調校
- 參考
- https://docs.aws.amazon.com/redshift/latest/dg/c-optimizing-query-performance.html
- http://udayarumilli.com/sql-server-performance-tuning-interview-questions-part-1/
- https://stackify.com/postgresql-performance-tutorial/
- https://www.revsys.com/writings/postgresql-performance.html
- https://www.mssqltips.com/sqlservertip/1429/sql-server-dba-performance-tuning-interview-questions/
- https://aws.amazon.com/tw/blogs/big-data/top-10-performance-tuning-techniques-for-amazon-redshift/
12) 資料模型的例子?
- 大公司的資料模型:
Netflix、linkedin、yelp、uber、廣告、電商 - Kimball —— 星型 schema
- Inmon = 自底向上的做法。
- 兩種做法各自的優缺點。(3NF vs 星型 schema,為什麼用或不用)
- 用代理鍵還是不用(優缺點)
- 參考
13) 你怎麼理解 data mart?
- Data mart 大多是為單一個業務分支設計的,服務個別的部門。
- 我們有一個資料倉儲,放著所有這些部門的資料,然後在這個倉儲之上建了幾個 data mart,每個對應一個部門。簡單說,data mart 就是資料倉儲的一個子集。
- 例如:我以前待過一家健康保險公司,裡面有財務、報表、業務等不同部門。
14) 說明 SQL 的各種鍵?
15) 資料庫正規化與反正規化
16) 索引的優缺點
| 優點 | 缺點 |
|---|---|
把全表掃描變成 O(log n) 的查找與範圍查詢 |
每次寫入都得維護所有受影響的索引 |
不用排序就能服務 ORDER BY / GROUP BY |
多佔儲存空間,也在 buffer pool 裡跟資料搶位置 |
可以強制唯一性(UNIQUE) |
選擇性低的索引永遠不會被用到 —— 純粹是成本 |
| 覆蓋索引可以只靠索引就回答查詢 | 索引越多,最佳化器可以選錯的計畫也越多 |
| 加快在外鍵上的 join | 膨脹與碎片化需要偶爾重建 |
17) MySQL 索引
- 引擎:
InnoDB(預設,支援交易、列級鎖、叢集主鍵)。MyISAM 是舊時代的產物 —— 表級鎖、沒有交易 - 結構:
B+tree。主鍵索引是叢集的(leaf 存的就是整列);每個次要索引的 leaf 存的是<索引欄位, 主鍵>—— 所以非覆蓋的次要查找要多走一趟回到主鍵樹(回表) - 索引種類:
PRIMARY、UNIQUE、普通KEY、複合、前綴(長字串用KEY(url(64)))、FULLTEXT、SPATIAL - 怎麼讀執行計畫
EXPLAIN SELECT …→ 重點是type欄:system > const > eq_ref > ref > range > index > ALL(ALL=全表掃描)key=選到的索引,rows=估計要看的列數,Extra=Using index(覆蓋 —— 好事)、Using filesort/Using temporary(排序或暫存表 —— 通常加個索引就能解)EXPLAIN ANALYZE(8.0.18+)會真的執行它並回報實際耗時
- 實務規則
- 對
WHERE、JOIN與ORDER BY用到的欄位建索引;遵守最左前綴 - 主鍵要短而且單調遞增(見第 8 題)
LIMIT n OFFSET 100000會重新讀 10 萬列 —— 改用「上次看到的鍵」來分頁- 盯著 buffer pool 的命中率(
innodb_buffer_pool_size是 MySQL 最重要的單一設定)
- 對
參考資料
- Edureka 資料倉儲教學
- 資料倉儲綜合