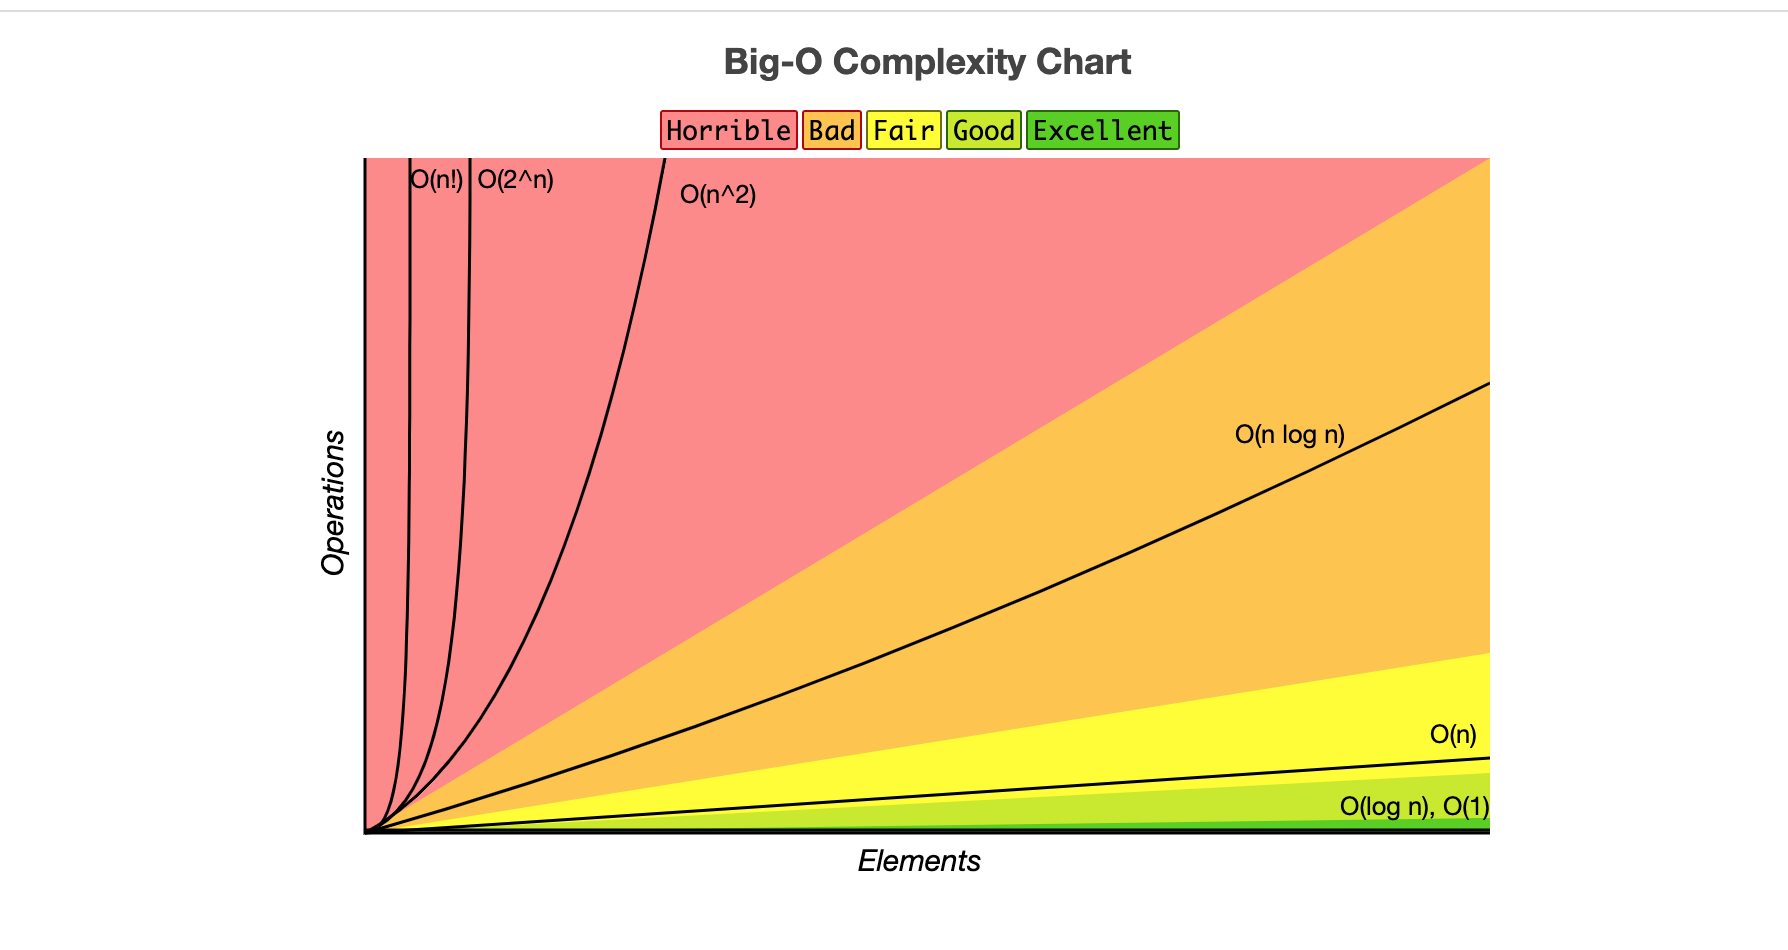
Big-O 比較
看每個複雜度類別成長得多快、畫出任何你輸入的式子,並讀出一個解法在逾時前能處理的最大輸入。
複雜度階梯 —— 點一個類別來顯示或隱藏
試試:
輸入大小 n,最大到
運算次數軸
那是多少次運算?
評測系統每秒大約跑 10⁸ 次簡單運算。這一個數字就能把
n ≤ 10⁵ 這種限制換算成面試官預期的複雜度 —— 從最後一欄反著讀。
預算:
~1 秒內跑得完
在 10 倍以內 —— 很緊,由常數決定
超過 10 倍 —— 逾時
比較兩個
哪個成長得比較快?是不是同一類別?差距從哪個 n 開始真正顯現?所有變數都視為 n。
看限制,猜演算法
找到預期解法最快的方法,就是看 n 的上限。以每秒 ~10⁸ 次運算計算,各個大小允許的複雜度如下。
| 若 n 最大到 | 目標 | 通常代表 |
|---|---|---|
| 10 – 11 | O(n!) | 列舉每種排列:backtracking、暴力排序。 |
| 20 – 25 | O(2ⁿ), O(n·2ⁿ) | 列舉每個子集:選 / 不選的遞迴、bitmask DP。 |
| ≈ 500 | O(n³) | 區間 DP、Floyd–Warshall、三層巢狀迴圈。 |
| ≈ 5,000 | O(n²) | 以兩個索引為狀態的 2-D DP(LCS、edit distance)、所有配對。 |
| 10⁵ – 10⁶ | O(n log n) | 先排序、heap、迴圈裡做 binary search。最常見的面試上界。 |
| 10⁷ – 10⁸ | O(n) | 掃一遍:hash map、two pointers、sliding window、prefix sum、BFS / DFS。 |
| 超過 10⁸ | O(log n), O(1) | 對答案做 binary search、數學、公式。 |
每個類別從哪裡來
認得程式碼的樣子,還沒開始數就知道上界。
面試時怎麼講複雜度
- 丟掉常數和低次項。
3n² + 10n + 7是O(n²)。把陣列掃兩遍仍然是O(n)。 - 依序執行用加的,巢狀執行用乘的。 一個迴圈接著另一個迴圈是
O(a + b);迴圈裡面再一個迴圈是O(a · b)。 - 不同的輸入用不同的字母。 比較兩個字串是
O(m · n),不是O(n²);圖是O(V + E)。把它們都併成 n 是講錯上界最常見的方式。 - 砍半就會出現 log。 只要每一步把剩下的工作砍半 ——
binary search、平衡樹、heap —— 步數就是
log n。底數永遠不重要:log₂ n和log₁₀ n只差一個常數。 - 遞迴是 分支數深度。 暴力 Fibonacci 每層呼叫 2 次、深度 n:
O(2ⁿ)。加上 memoization 後每個狀態只算一次:O(狀態數 × 每個狀態的工作量)=O(n)。 - Divide and conquer: 切半、用線性時間合併 ——
O(n log n)(merge sort)。切半、只留一邊 ——O(log n)(binary search)。 - 攤銷(amortised)看的是整段執行。 動態陣列偶爾的擴容,或每個元素只 push、pop 一次的
monotonic stack,在整段執行中每次操作是
O(1)—— 要把「amortised」說出口。 - 空間要算遞迴堆疊。 在歪斜的樹上做 DFS,即使看不到任何資料結構,空間也是
O(n);在平衡的樹上則是O(log n)。 - 點出決定複雜度的那一行。「排序是
O(n log n),之後都是線性, 所以總共是O(n log n)」就是面試官在等的那句話。
經典的 Big-O 圖(參考圖片)