Spark & Hadoop 面試題庫
範圍 — 經典的 Spark / Hadoop 面試題,每題都用你會說出口的幾句話回答;外加把這些題目變成練習的排錯演練、管線設計題與讀書計畫。每個答案背後的機制在深入解析
../de/spark.md裡,這份文件只連過去,不重複。 另見:../de/spark.md— 深入的 Spark 內部機制;../de/hadoop.md— 深入的 HDFS、YARN 與 MapReduce;../de/stream_pipeline.md— 串流語意與各引擎;./faq_hadoop.md與./faq_mapreduce.md— 延伸閱讀清單。
每個答案都以一句粗體 —— 最先要說的那句話 開頭,接著是面試官預期聽到的兩三個重點。 設定名稱與預設值都以 Spark 3.5 為準。第 0 節把這份文件和深入解析配成一組,並定出複習順序; 第 14 節是讀書計畫與模擬題庫。
0) 兩份 Spark 文件怎麼搭配使用
0-1) 哪份文件負責什麼
這裡有兩份 Spark 文件。這份題庫告訴你要回答什麼;de/spark.md 這份深入解析
說明答案為什麼成立。兩份要搭配著用,而不是讀完一份再讀另一份。
| 本文件:題庫 | de/spark.md:深入解析 |
|
|---|---|---|
| 每一節給你 | 說出口的那幾句話 | 背後的機制,以及面試官接著會追問的取捨 |
| 只有這裡有 | 排錯演練(§12)、設計題(§13)、讀書計畫與模擬題庫(§14) | PySpark(§10)、寫入與 table format(§11)、調校清單(§13)、Spark UI 症狀判讀(§14) |
| 什麼時候打開 | 正在練習,或面試前一晚 | 這裡的答案經不起一句「為什麼?」 |
| 章節順序 | 依面試提問的順序 | 依 Spark 的構造 |
兩份文件的章節順序不同,所以單獨從頭讀到尾都不理想;0-2 把它們對齊。相鄰主題
請看 de/hadoop.md(HDFS 與 YARN)、de/stream_pipeline.md
(Spark 以外的串流),以及 faq_hadoop.md 與 faq_mapreduce.md
延伸閱讀清單。
0-2) 複習順序
照步驟依序進行。每一步先把「說出口」欄的章節大聲回答一遍,再讀「弄懂它」欄裡你講不清楚的部分, 然後再回答一次。
| 步驟 | 階段 | 主題 | 說出口 —— 本文件 | 弄懂它 —— de/spark.md |
|---|---|---|---|---|
| 1 | 1 · 基礎 | Spark 是什麼,以及 Spark vs MapReduce | 1-1, 1-2, 1-4 | 1-1, 1-2, 1-3 |
| 2 | Driver、executor、spark-submit |
2-1, 2-2, 2-3 | 2-1, 2-2 | |
| 3 | Job → stage → task、窄依賴 vs 寬依賴、partition | 3-1, 3-2, 3-3, 3-4 | 2-3, 3-3, 6-1 | |
| 4 | RDD vs DataFrame、transformation vs action | 4-2, 4-3, 4-5 | 3-1, 3-2, 3-4 | |
| 5 | 2 · 效能核心 | Shuffle | 5-1, 5-2, 5-3 | 5-1, 5-2, 5-3, 9-5 |
| 6 | repartition、coalesce、檔案配置、小檔案 |
3-5, 12-3 | 6-2, 6-3, 6-4 | |
| 7 | Join 策略與資料傾斜 | 5-5, 6-1, 6-2, 12-2 | 7-1, 7-2, 7-3 | |
| 8 | 快取與 checkpoint | 7-1, 7-2, 7-3 | 8-1, 8-2, 8-3 | |
| 9 | 記憶體、資源配置與 OOM | 8-1, 8-2, 8-3 | 9-1, 9-2, 15-1 | |
| 10 | 3 · 引擎與正式環境 | 容錯 | 9-1, 9-2 | 2-4 |
| 11 | Catalyst、AQE、讀懂執行計畫 | 10-1, 10-2, 10-3, 10-4 | 4-1, 4-2, 4-3, 4-4 | |
| 12 | PySpark:worker、UDF、Arrow | — | 10-1, 10-2, 10-3 | |
| 13 | 寫入、save mode、table format | — | 11-1, 11-2, 11-3, 11-4 | |
| 14 | Structured Streaming | 11-1, 11-2, 11-3 | 12-1, 12-2, 12-3, 12-4, 12-5, 12-6 | |
| 15 | 調校與 Spark UI | 12-1, 12-4 | 13-1, 13-2, 14-1, 14-2, 15-2 | |
| 16 | 4 · 演練 | 管線設計 | 13-1, 13-2 | 15-3, 16-2 |
| 17 | 模擬面試:大聲回答,再自我檢查 | 14-2, 14-3 | 16-1 |
- 步驟 1–9 就是 14-1 裡的 P0 與 P1 核心,多數面試根本不會超出這個範圍。
- 步驟 12 與 13 只有深入解析才有。PySpark 與 table format 的題目在資料工程面試中遠比一般 SWE 面試常見。
0-3) 你有多少時間?
時間花在步驟上,而不是把文件從頭讀到尾。
| 時間 | 計畫 |
|---|---|
| 一個晚上 | 步驟 1–9,只看「說出口」欄,然後做模擬題庫 14-2 |
| 一週 | 第 1 天:階段 1。第 2–3 天:階段 2。第 4–5 天:階段 3。第 6 天:階段 4。第 7 天:重做每個卡住的步驟 |
| 面試前一晚 | 大聲回答 14-2,跑一遍 14-3 清單;不學新東西 |
1) Spark、Hadoop 與 MapReduce 優先度 4/5 — 高價值 — 這裡有缺口就會掉關
1-1) 什麼是 Apache Spark?
Spark 是分散式運算引擎:你描述對資料集的運算,Spark 把它轉成由平行 task 組成的計畫, 在叢集上執行,並從 lineage 重新計算任何遺失的部分。
- 統一引擎 —— 批次 SQL / DataFrame、Structured Streaming、MLlib 與 GraphX 共用同一個引擎。
- 不是資料庫,也不是佇列 —— 它不持久保存任何東西。它從 HDFS、S3 / GCS / ADLS、JDBC、 Kafka 以及 Delta、Iceberg 這類 table format 讀取並寫回。
- 語言 —— Scala、Java、Python(PySpark)、SQL 與 R。
| 特性 | 意思 |
|---|---|
| 分散式 | 資料切成 partition,由多個 executor 平行處理 |
| 記憶體優先 | 放得下時,中間結果在 stage 之間留在記憶體 |
| 延遲執行(lazy) | transformation 只建立計畫;action 才執行它 |
| 容錯 | 遺失的 partition 從 lineage 重算,而不是從副本還原 |
| 水平擴展 | executor 越多,可平行的 task 越多 |
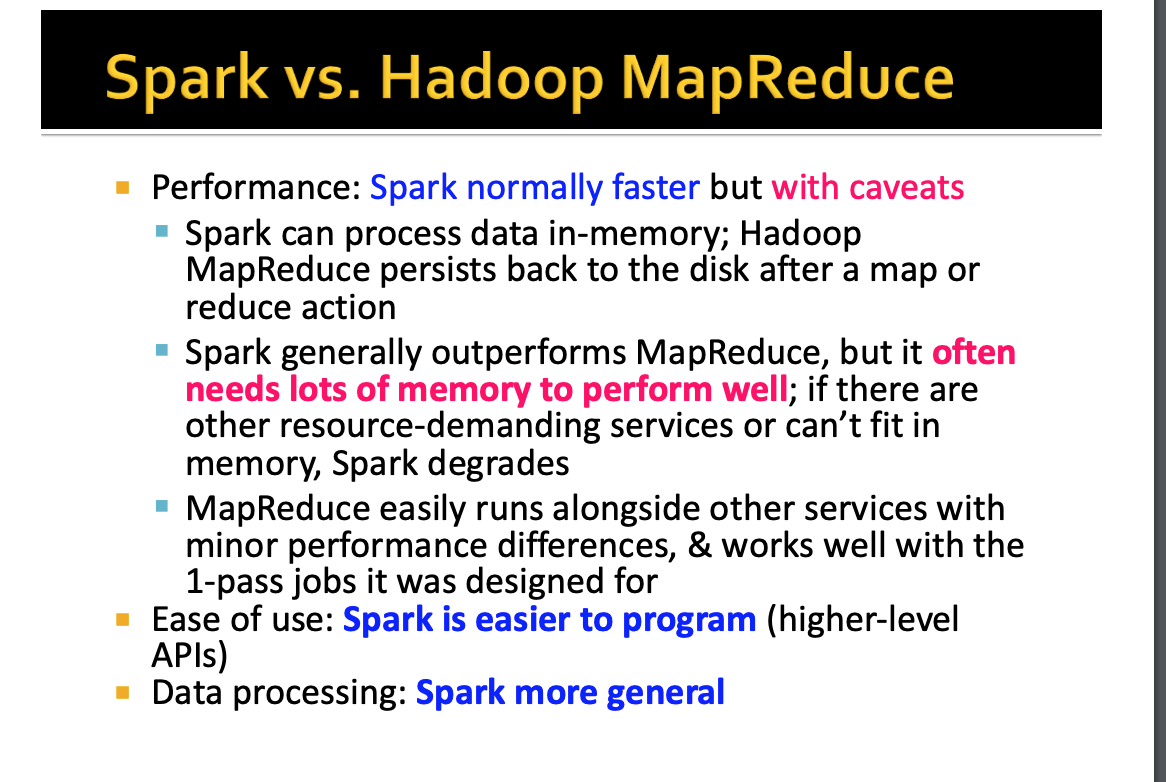
1-2) Spark vs Hadoop MapReduce
MapReduce 在每個 job 之間都寫回 HDFS,所以十個步驟的管線就是十次磁碟來回; Spark 把整條管線規劃成一個 DAG,stage 之間的中間資料留在記憶體或本機磁碟。
| Spark | Hadoop MapReduce | |
|---|---|---|
| 執行模型 | 由 stage 組成的 DAG,窄步驟融合成一個 task | 每個 job 一個 map 階段、一個 reduce 階段 |
| 中間資料 | 記憶體,不夠時溢寫到本機磁碟 | job 之間走 HDFS,job 內走本機磁碟 |
| 迭代運算(ML、圖) | 快 —— 重複使用快取的資料集 | 慢 —— 每次迭代都從 HDFS 重讀 |
| API | DataFrame、SQL、RDD、串流、ML | map 與 reduce 函式,上層再加 Hive / Pig |
| 串流 | Structured Streaming(micro-batch) | 不適合 |
| 儲存 | 沒有自己的儲存 | 內建 HDFS |
- Hadoop 不只是 MapReduce。 它是 HDFS(儲存)+ YARN(資源)+ MapReduce(運算)。 Spark 取代的是運算層,而且常常仍跑在 HDFS 之上的 YARN。
- 「Spark 需要把所有東西放進記憶體」是迷思。 記憶體不夠時運算子會溢寫到磁碟,
而資料集只有在你
cache()之後才會留在記憶體。資料遠大於叢集記憶體對 Spark 來說很常見 —— 只是跑得比較慢。所以「資料很大就用 MapReduce」不是今天會有人給的理由。
1-3) 什麼是 MapReduce 程式模型?
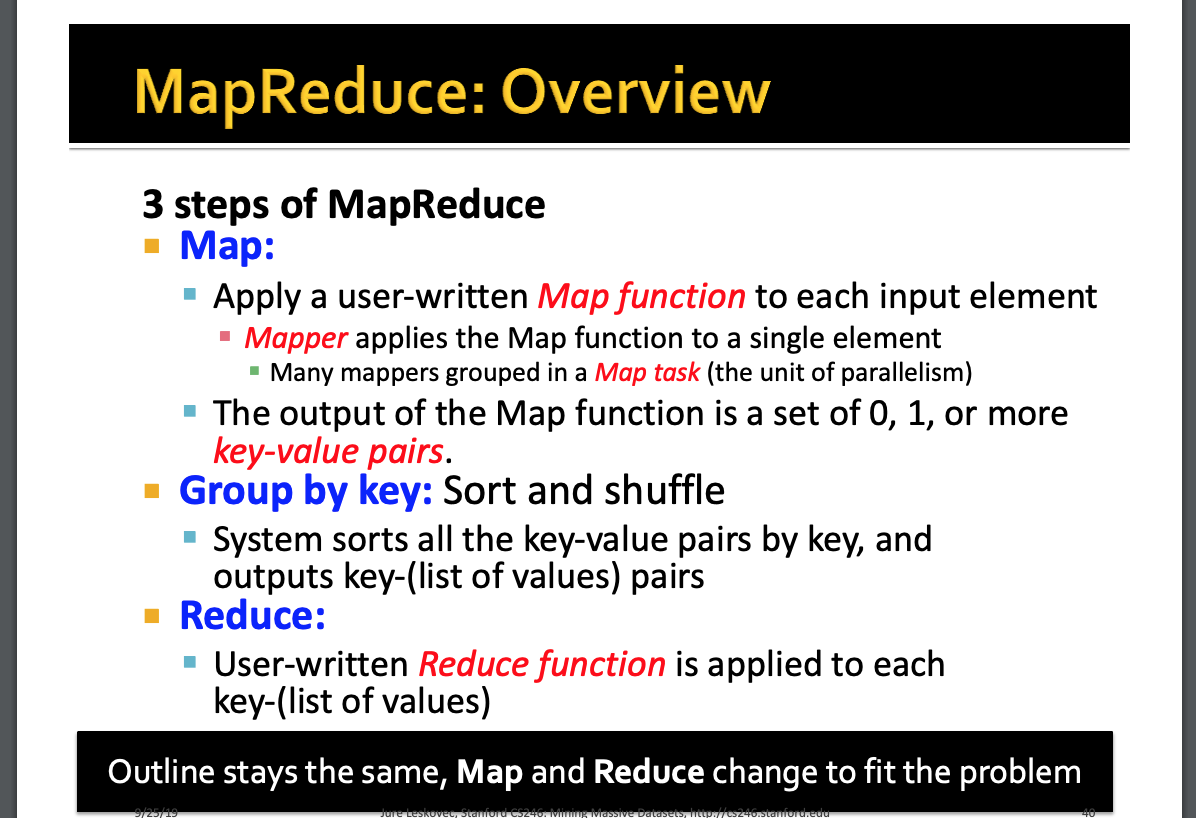
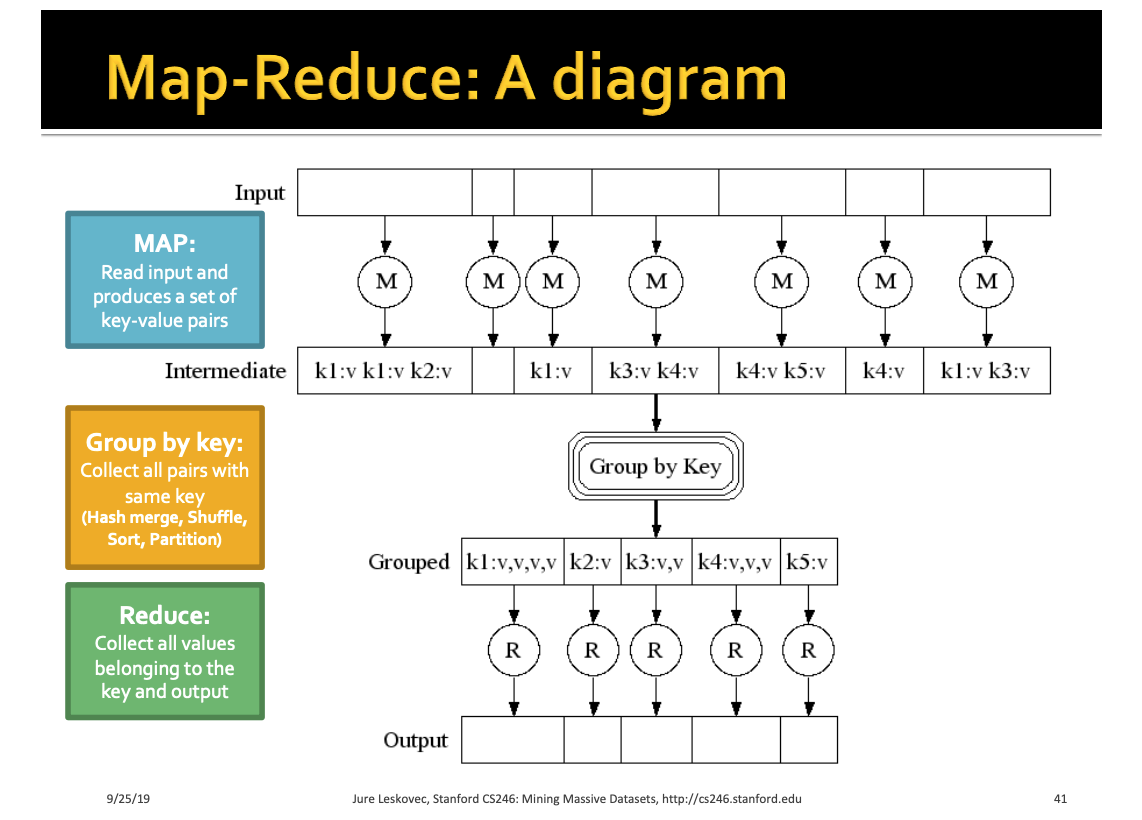
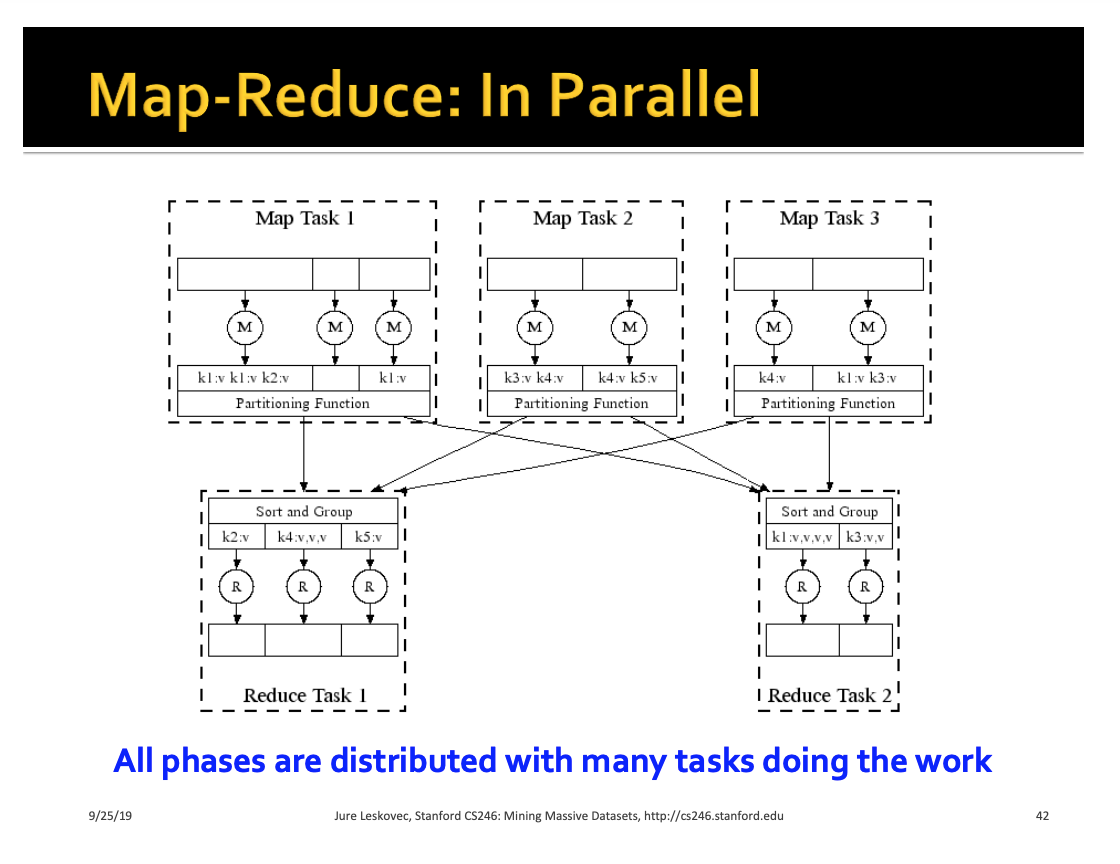
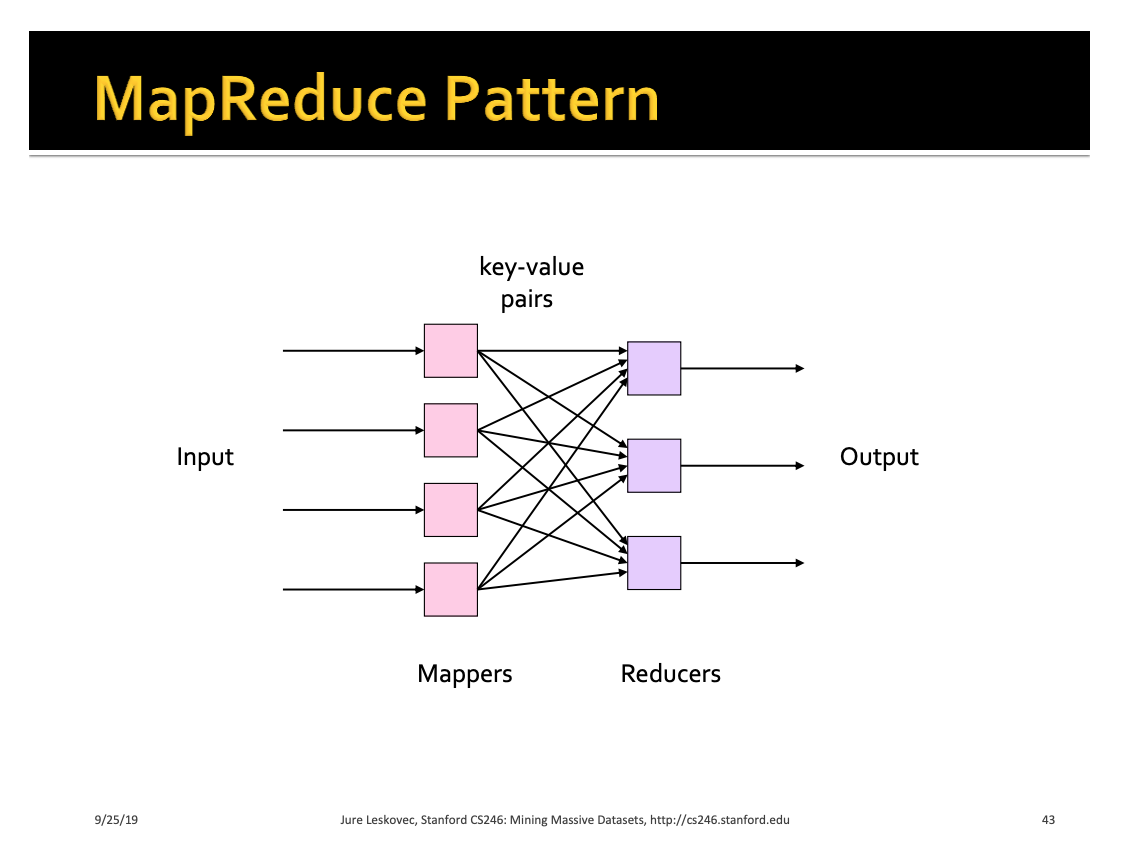
Map 把每筆輸入轉成 key-value pair,框架把所有 pair 依 key 分組(也就是 shuffle), reduce 再把每個 key 的值摺疊成結果。
- 你只需要寫
map與reduce;分區、排序、shuffle 與重試都是框架的工作。 - combiner 是可選的 map 端 reduce —— 它縮小 shuffle 要搬的資料量,這正是 Spark 的
reduceByKey替你做的事(見 4-5)。 - 優點:模型簡單、線性擴展、能撐過節點故障。 缺點:程式冗長、每個 job 只有一個 map + 一個 reduce,而且每個 job 都要經過 HDFS 來回。
1-4) 為什麼 Spark 通常比 MapReduce 快?
因為它避開了每個 job 的 HDFS 來回,並且一次規劃整個運算 —— 而不是因為所有東西都在記憶體裡。
- 一個 DAG,而不是一串 job —— 多步驟管線是一個 Spark job,stage 之間透過本機 shuffle 檔案傳資料,而不是寫有副本的 HDFS。
- Pipelining —— 窄轉換(
map、filter、select)融合成每個 partition 一個 task, 中間的資料列從不實體化。 - 快取 —— 迭代演算法從記憶體重用資料集,不必重讀。
- 最佳化器 —— Catalyst 改寫計畫(下推、裁剪、選 join 策略),Tungsten 針對二進位資料列 產生精簡的 JVM 程式碼。
- task 很便宜 —— executor 是長壽的 JVM,可以跑很多 task;MapReduce 每個 task 都要啟動一個 JVM。
1-5) MapReduce 還值得學嗎?
值得,作為一個模型 —— map、依 key shuffle、reduce 正是 Spark groupBy 在做的事 ——
但不是作為你會去寫的 API。
- 每一個分散式聚合、join 與排序仍然是「依 key 分區,再合併」,所以第 5 節的 shuffle 題目 其實就是換了包裝的 MapReduce 題目。
- 上層的引擎已經換代了:Hive 跑在 Tez 上而不是 MapReduce,Pig 實際上已經退場。 HDFS 與 YARN 仍然常見,尤其是地端環境。
1-6) Spark 的弱點是什麼?
成本主要花在 shuffle 與記憶體壓力上,串流是 micro-batch 而不是真正的逐筆處理,而且可調的參數很多。
- 吃記憶體 —— 寬操作、快取與 broadcast 都在搶 executor 記憶體;OOM 與溢寫是正式環境最常見的故障。
- 小檔案 —— 除非刻意控制輸出大小,否則很多 writer 就會產生很多小檔案。
- 串流延遲 —— Structured Streaming 預設的 trigger 是 micro-batch,所以延遲在數百毫秒到數秒; 要更低通常選 Flink。
- Python 開銷 —— 逐列執行的 Python UDF 會把每一列序列化送到 Python 程序。
- 調校面很大 —— partition 數、executor 大小與 join 策略都有影響,而錯誤的預設值代價很高。
1-7) 什麼時候你不會用 Spark?
當資料一台機器就放得下、當你需要帶大量狀態的逐事件低延遲,或當資料倉儲已經能直接跑那段 SQL 時。
| 需求 | 更合適的選擇 | 原因 |
|---|---|---|
| TB 級批次 ETL、大型 join、ML 特徵管線 | Spark | 成熟的批次引擎、豐富的 API |
| 次秒級、有狀態、以事件時間為準的串流 | Flink | 逐筆處理,狀態與事件時間是一等公民 |
| 以 Kafka 為中心的服務裡做串流處理 | Kafka Streams | 是函式庫,不用維運叢集 |
| 批次與串流共用一份管線定義 | Apache Beam(跑在 Dataflow / Flink / Spark) | 可攜的程式模型 |
| 對已在倉儲裡的資料跑 SQL | BigQuery / Snowflake / Redshift | 沒有叢集要調大小或調校 |
| 一台機器上的幾 GB 資料 | pandas / Polars / DuckDB | 沒有分散式開銷 |
Spark vs Flink 各一句話:Spark 以批次為主、串流是 micro-batch,批次生態系比較大;
Flink 以串流為主,逐筆處理、狀態有 checkpoint,事件時間的處理更強。更多內容見 ../de/stream_pipeline.md。
2) 架構與部署 優先度 5/5 — 必備 — 幾乎每一輪面試都會出現
2-1) Driver、executor、worker 與 cluster manager
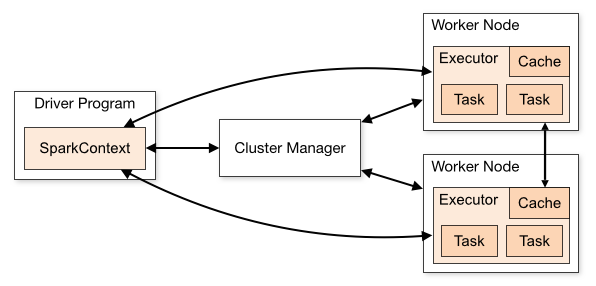
Driver 負責規劃與排程;executor 執行 task 並保存快取資料;cluster manager 分配機器; worker 是承載 executor 的節點。
| 元件 | 負責什麼 |
|---|---|
| Driver | 執行你的 main()、持有 SparkSession、建立計畫、切成 job / stage / task、排程 task 並追蹤結果 |
| Executor | worker 節點上的一個 JVM,執行 task(每個核心同時一個)、保存快取的 partition、提供 shuffle 檔案 |
| Cluster manager | 把 CPU 與記憶體分配給各應用程式 —— Standalone、YARN 或 Kubernetes |
| Worker node | 任何可以承載 executor 的機器 |
- Driver 是程序,不是節點,也不是 master。在
client模式下它跑在你提交的地方; 在cluster模式下由 cluster manager 在叢集內啟動。多個應用程式 —— 各有自己的 driver —— 共用一個 cluster manager。 - Driver 不處理你的資料 —— 除非你把資料拉過去:
collect()與toPandas()會把整個結果送到 driver,這就是典型的 driver OOM。 - Executor 屬於單一應用程式。 兩個應用程式從不共用 executor,所以也無法共用快取。
深入解析:../de/spark.md §2-1。
2-2) spark-submit 之後發生了什麼?
Driver 啟動,向 cluster manager 要 executor;當 action 執行時把你的程式碼轉成由 stage 組成的 DAG,並把每個 stage 的 task 送給 executor,直到 job 結束。
spark-submit啟動 driver(client模式在本機,cluster模式在叢集裡)。- Driver 建立
SparkSession/SparkContext,並向 cluster manager 註冊。 - Cluster manager 在 worker 節點上啟動 executor;executor 再回頭向 driver 註冊。
- 你的程式碼開始執行。transformation 只會建立邏輯計畫。
- 一個 action 建立一個 job。Catalyst 把計畫最佳化成實體計畫,DAGScheduler 在每個 shuffle 處把它切成 stage。
- TaskScheduler 把每個 stage 的 task(每個 partition 一個)送給 executor, 優先選已經持有該資料的 executor(locality)。
- Executor 執行 task、為下一個 stage 寫出 shuffle 輸出並回報狀態。失敗的 task 會重試(見 9-1)。
- 當
main()結束或呼叫spark.stop(),executor 就被釋放。
User code ─► SparkSession ─► logical plan ─► Catalyst ─► physical plan
                                                              │
               executors ◄─ TaskScheduler ◄─ stages ◄─ DAGScheduler
                   │
                   └─► results to the driver, or output to storage
2-3) spark-submit 指令,以及加入外部 jar
用 --master 指定 cluster manager、用 --deploy-mode 指定 driver 跑在哪裡,設定 driver 與
executor 的大小,並用 --jars 或 --packages 帶上相依套件。
./bin/spark-submit \
  --master yarn \
  --deploy-mode cluster \
  --driver-memory 4g \
  --executor-memory 8g \
  --executor-cores 4 \
  --num-executors 20 \
  --conf spark.sql.shuffle.partitions=400 \
  --jars /libs/postgresql.jar,/libs/extra.jar \
  --packages org.apache.spark:spark-sql-kafka-0-10_2.12:3.5.1 \
  --class com.example.DailyEtl \
  daily-etl.jar 2026-11-06
--jars接受以逗號分隔的本機或遠端 jar 清單,會加入 driver 與 executor 的 classpath。--packages在提交時解析 Maven 座標(以及其遞移相依)。- PySpark 用
--py-files帶上.py/.zip/.egg檔;打包好的虛擬環境用--archives。 - 把相依套件一起打包的 fat(uber)jar 可以避免正式環境的 classpath 意外。
2-4) SparkSession vs SparkContext
SparkSession(Spark 2.0+)是 DataFrame、SQL 與 catalog 的單一入口;它包住較舊的
SparkContext,而後者仍是 RDD、broadcast 與 accumulator 的入口。
SparkSession取代了SQLContext與HiveContext;enableHiveSupport()會接上 Hive metastore。- 每個 JVM 只有一個
SparkContext;從 session 用spark.sparkContext取得它。 - 在
spark-shell與pyspark裡,這兩個物件已預先建立為spark與sc。
# python
from pyspark.sql import SparkSession

spark = SparkSession.builder.appName("daily-etl").getOrCreate()
sc = spark.sparkContext            # the underlying SparkContext
2-5) Cluster manager:Standalone、YARN、Kubernetes(以及 Mesos)
Cluster manager 只負責分配資源 —— task 仍由 driver 排程 —— 所以選哪個取決於叢集本來在哪裡。
| Manager | 什麼時候用 | 備註 |
|---|---|---|
| Standalone | 專給 Spark 用的叢集 | Spark 自己的 master 與 worker;最簡單 |
| YARN | Hadoop 叢集(EMR、地端) | 每個應用程式有一個 ApplicationMaster;可用 external shuffle service |
| Kubernetes | 容器平台 | driver 與 executor 都是 pod;dynamic allocation 靠 shuffle tracking |
| Mesos | 只剩舊系統 | Spark 3.2 標記淘汰,4.0 移除 |
--master local[*] 在單一 JVM 裡執行,每個核心一個執行緒 —— 用於測試與 notebook,不是 cluster manager。
2-6) 如何讓 Standalone master 具備高可用性?
跑幾個由 ZooKeeper 協調的備援 master;作用中的 master 掛掉時,備援者接手,執行中的應用程式繼續跑。
- ZooKeeper 模式(
spark.deploy.recoveryMode=ZOOKEEPER)—— 正式環境用。leader election 選出作用中的 master;worker 與應用程式重新向新的 master 註冊。執行中的應用程式不受影響, 只有新的提交要等切換完成。 - 檔案系統模式(
spark.deploy.recoveryMode=FILESYSTEM)—— 單節點復原:master 的狀態寫到本機 目錄,重啟時再讀回來。 - 在 YARN 或 Kubernetes 上這題不存在:它們自己的控制平面就提供 HA。
參考:Spark Standalone — High Availability。
3) Job、Stage、Task 與 Partition 優先度 5/5 — 必備 — 幾乎每一輪面試都會出現
3-1) Application、job、stage 與 task
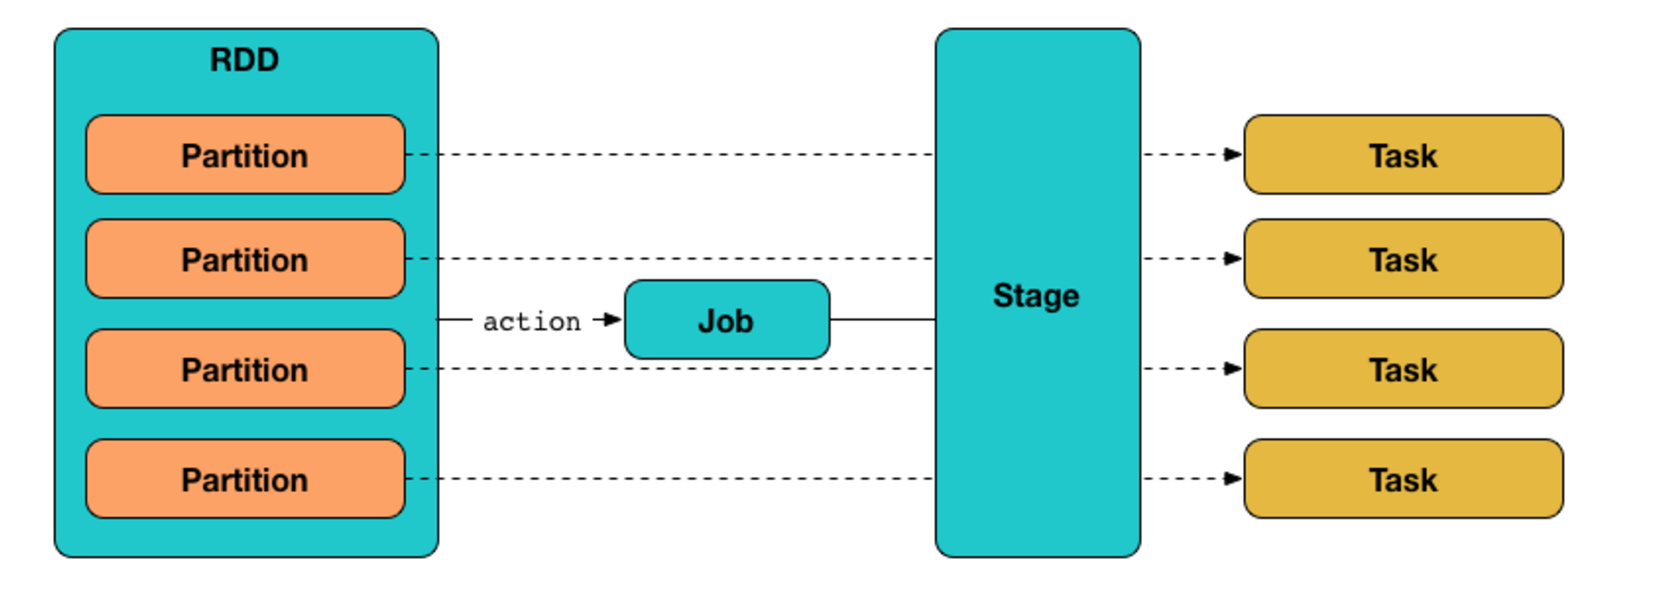
一個 application 就是一個 SparkSession;每個 action 啟動一個 job;job 在每個 shuffle 處被切成
stage;每個 stage 對每個 partition 跑一個 task。
由大到小:
Application  →  Job  →  Stage  →  Task
   1 : many      1 : many  1 : many  1 task : 1 partition
| 層級 | 由什麼產生 | 數量 |
|---|---|---|
| Application | 一個 SparkSession / SparkContext |
每次 spark-submit 一個 |
| Job | 一個 action —— count、collect、show、write、foreach |
每個 action 一個(有些像 show 或 schema 推斷會跑更多個) |
| Stage | job 內的一個 shuffle 邊界 | shuffle 數 + 1 |
| Task | stage 的一個 partition | 該 stage 的 partition 數 |
- 一個 task 對一個 partition 執行該 stage 整條融合後的管線 ——
read → filter → map是每個 partition 一個 task,不是三個。 - 每個 task 跑在一個 executor 核心上。排程器把 stage 以 TaskSet 提交 —— 那是 stage 被排程的方式, 不是 stage 本身。
實際例子:
# python
df = spark.read.parquet("s3://bucket/events/")           # 400 input partitions
result = (df.filter("age > 18")
            .groupBy("country")
            .count())
result.show()                                            # the action: one job
Job 0 (show)
├── Stage 0: scan → filter → partial count      400 tasks, writes shuffle files
│            ── shuffle by country (Exchange) ──
└── Stage 1: final count per country            spark.sql.shuffle.partitions tasks,
                                                which AQE usually coalesces to a few
Catalyst、AQE 與資料來源都可能改變實際數量 —— explain() 與 Spark UI 才是準的。
Task 是一個行程(process)嗎?
不是。Executor 才是行程(每個 executor 一個 JVM);task 是在 executor 某條執行緒上跑的一個工作單元。
| Executor | Task | |
|---|---|---|
| 它是什麼 | worker 節點上的一個 JVM 行程 | 把 stage 的管線套用在一個 partition 上 |
| 存活多久 | 整個 application,除非 dynamic allocation 把它釋放 | 直到它的 partition 處理完:幾毫秒到幾分鐘 |
| 記憶體 | 自己的 heap,spark.executor.memory |
和同一個 executor 裡正在跑的其他 task 共用那個 heap |
| 有幾個 | spark.executor.instances,或 dynamic allocation 決定的數量 |
stage 的每個 partition 一個 |
- Driver 把每個 task(closure 加上它要讀的 partition)序列化後送到 executor,executor 用自己 task 執行緒池裡的一條執行緒來跑。task 從來不需要新的 executor JVM;一個 task 跑完,executor 就接下一個。
- 同一個 executor 裡的 task 共用它的 heap、快取區塊與 broadcast 變數。所以一個過大的 task 可能讓整個 executor 記憶體不足,連帶讓旁邊的 task 一起失敗。
- 用作業系統的說法:application 是程式,executor 是行程,task 是交給這個行程某條工作執行緒的一件工作。
- PySpark 多了一個細節。會執行 Python 程式碼的 task(Python UDF 或 RDD lambda)會把程式碼交給
executor 在 JVM 旁啟動的 Python worker 行程;只用內建表達式的 DataFrame task 完全不需要。
Worker 預設會重複使用(
spark.python.worker.reuse=true);設成false時,每個這類 task 會 啟動自己的 worker。無論哪種,排程與重試仍由 driver 負責,executor JVM 則執行 task 並回報狀態。
同一時間會跑幾個 task?
每個 executor 同時最多能跑 ⌊spark.executor.cores ÷ spark.task.cpus⌋ 個 task。除法無條件
捨去:5 個核心、spark.task.cpus=2 是 2 個 slot,不是 2.5。因為 spark.task.cpus 預設是 1,
整個 cluster 同時 task 數的上限約為 executor 數 × 每個 executor 的核心數;task 比 slot 少的
stage,其餘 slot 就閒置。
兩個 executor、各兩個核心,共四個 slot,所以一個有八個 task 的 stage 大約分兩波跑完:
Stage 0: 8 tasks, 4 slots (2 executors x 2 cores)

             slot 1     slot 2
Executor 1   T0 -> T4   T1 -> T5
Executor 2   T2 -> T6   T3 -> T7

wave 1: T0-T3   wave 2: T4-T7      8 tasks / 4 slots = 2 waves
- 「波」只是近似說法。slot 一空出來就會領下一個待執行的 task,不會等其他 slot;排程器也偏好
已經持有該資料的 executor(
spark.locality.wait),所以實際分配不是嚴格輪流。 - Partition 決定 task 數(3-4),cluster 決定 slot 數。目標是每個核心至少 兩到三個 task(12-4),這樣 slot 不會閒置, 最後一波也不會只剩一個拖慢全局的 task。
增加 executor,task 會變多嗎?
通常不會。Task 數量來自 partition 數量;增加 executor 只是增加 slot,讓同樣的 task 用更少的波次跑完。
| 之前 | 之後 | |
|---|---|---|
| Executor 數 | 2 | 10 |
| 每個 executor 的核心數 | 2 | 2 |
| Stage 的 partition 數 | 100 | 100 |
| Stage 的 task 數 | 100 | 100 |
| 同時可用的 slot | 4 | 20 |
| 波次(task / slot) | 25 | 5 |
- 只有在 task 比 slot 多的時候,多加 executor 才有幫助。只有 8 個 partition 的 stage 只會用到
20 個 slot 中的 8 個,其餘 12 個閒置。要用上它們,就要提高 partition 數:
repartition、spark.sql.shuffle.partitions,或在掃描時調小spark.sql.files.maxPartitionBytes。 - 這就是答案是「通常」而不是「永遠」的原因。
spark.default.parallelism沒設定時,預設是 cluster 上已註冊的總核心數,所以沒指定切片數的sc.parallelize在更大的 cluster 上確實會得到 更多 partition,也就更多 task。Shuffle 大多不受影響:沒設定時,RDD 的reduceByKey沿用上游 最大的 partition 數,DataFrame 的 shuffle 則用spark.sql.shuffle.partitions。
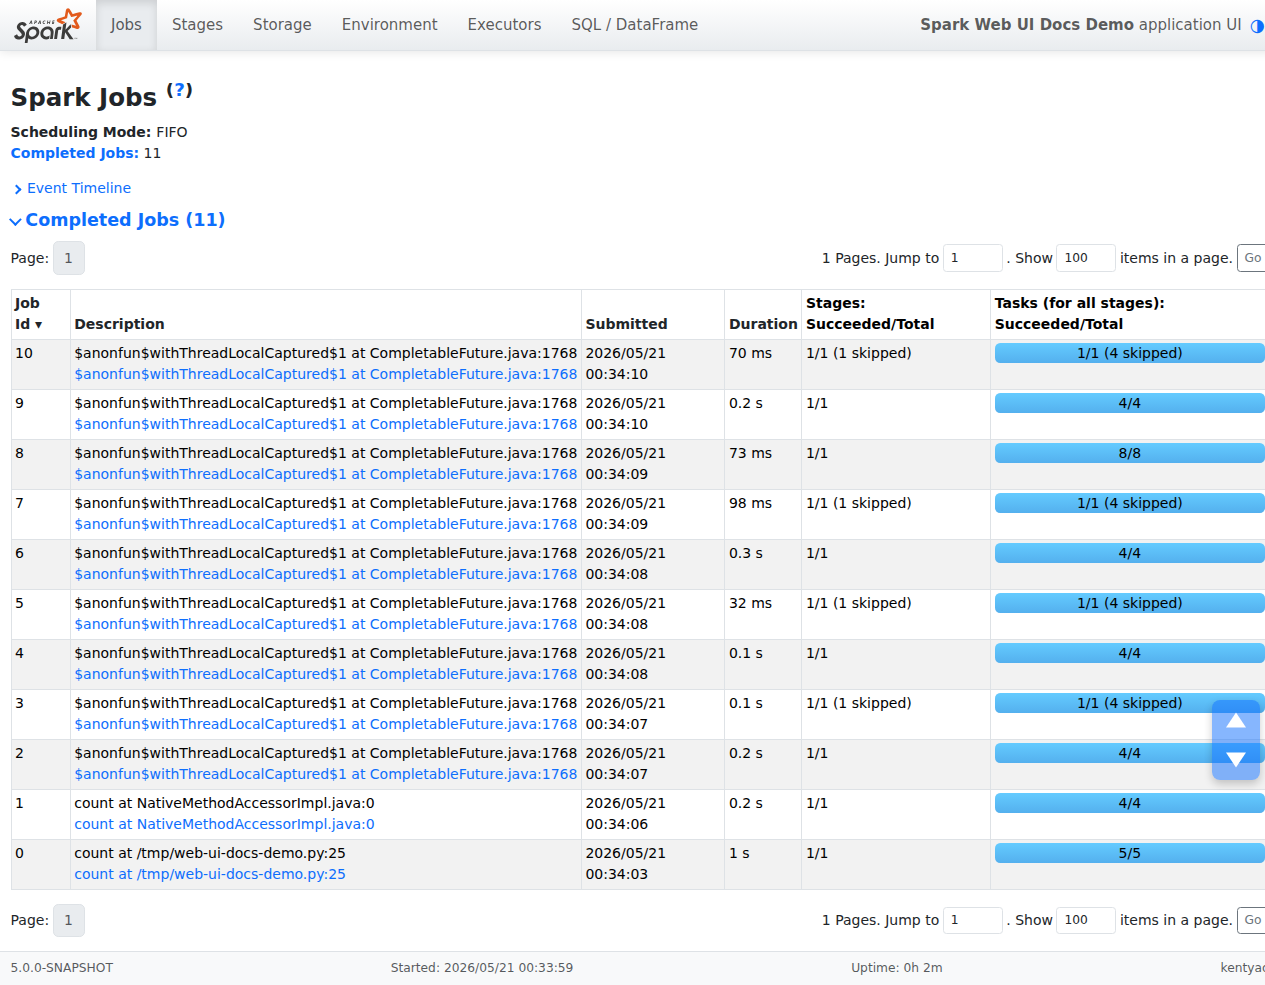
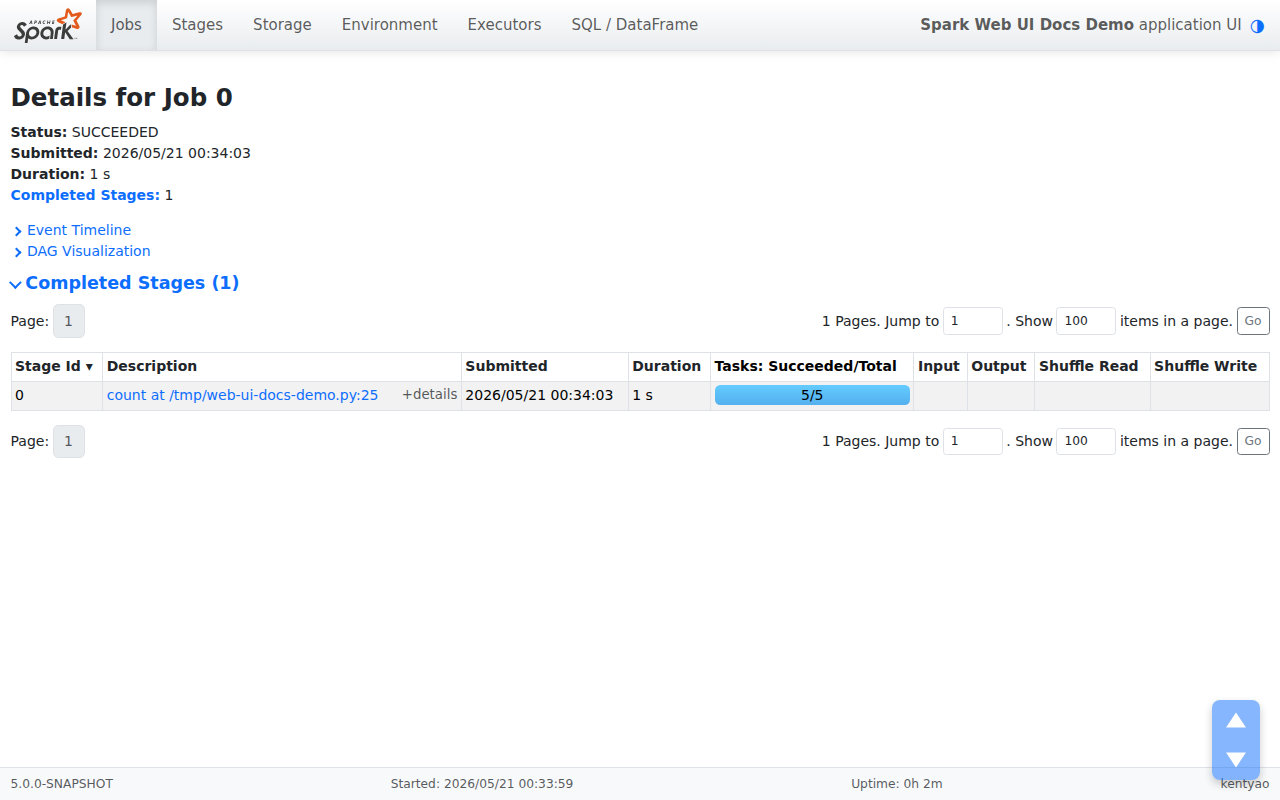
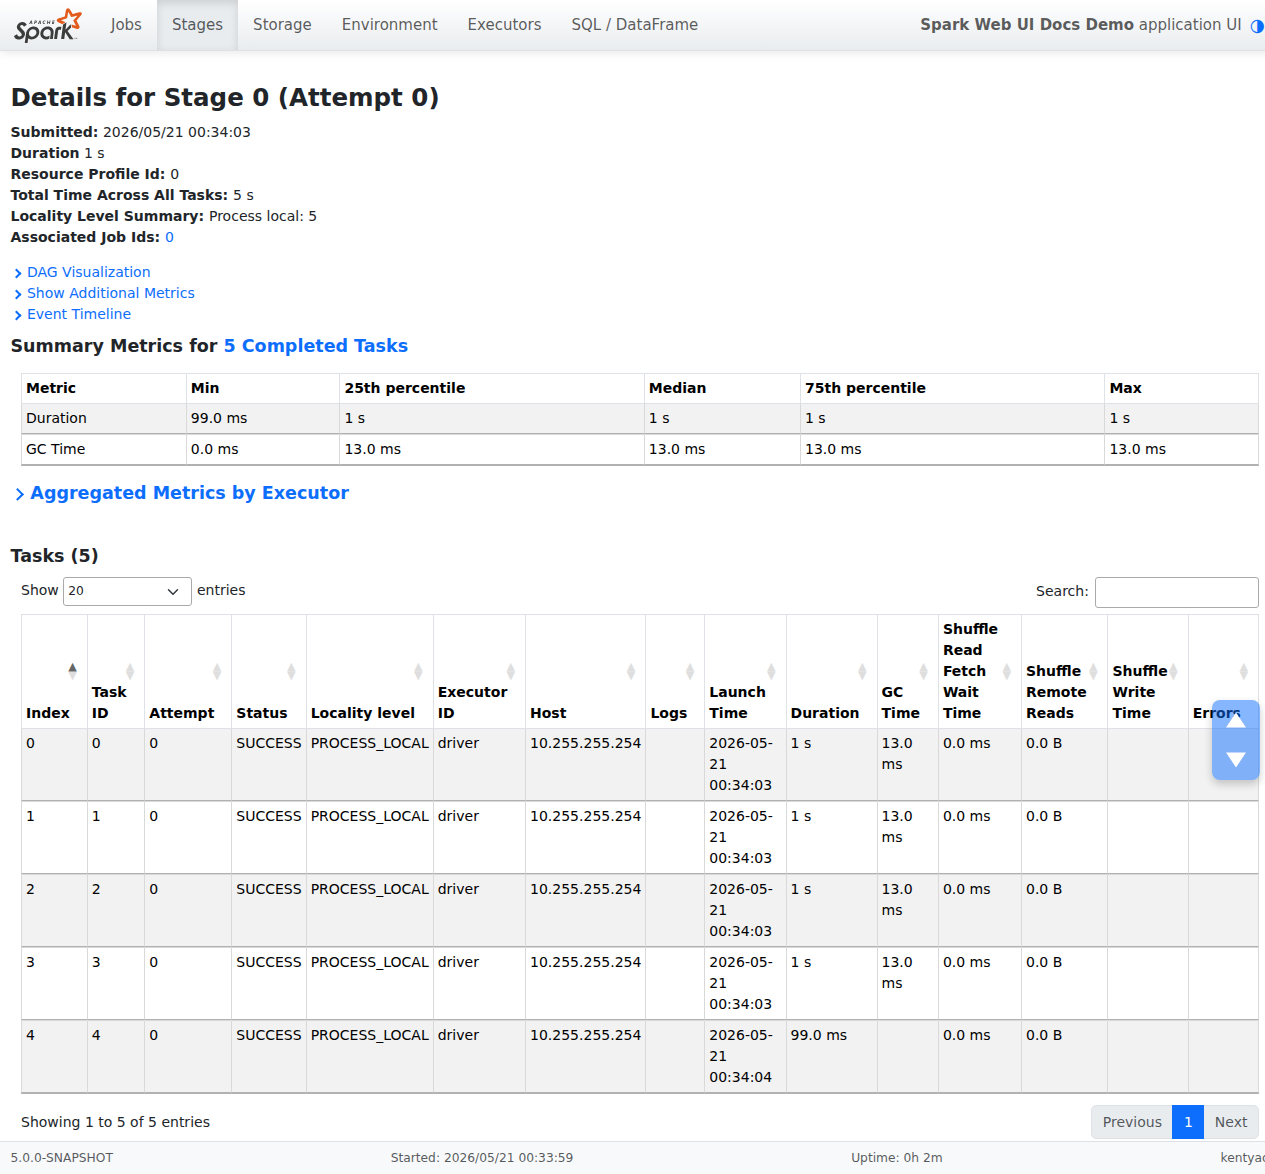
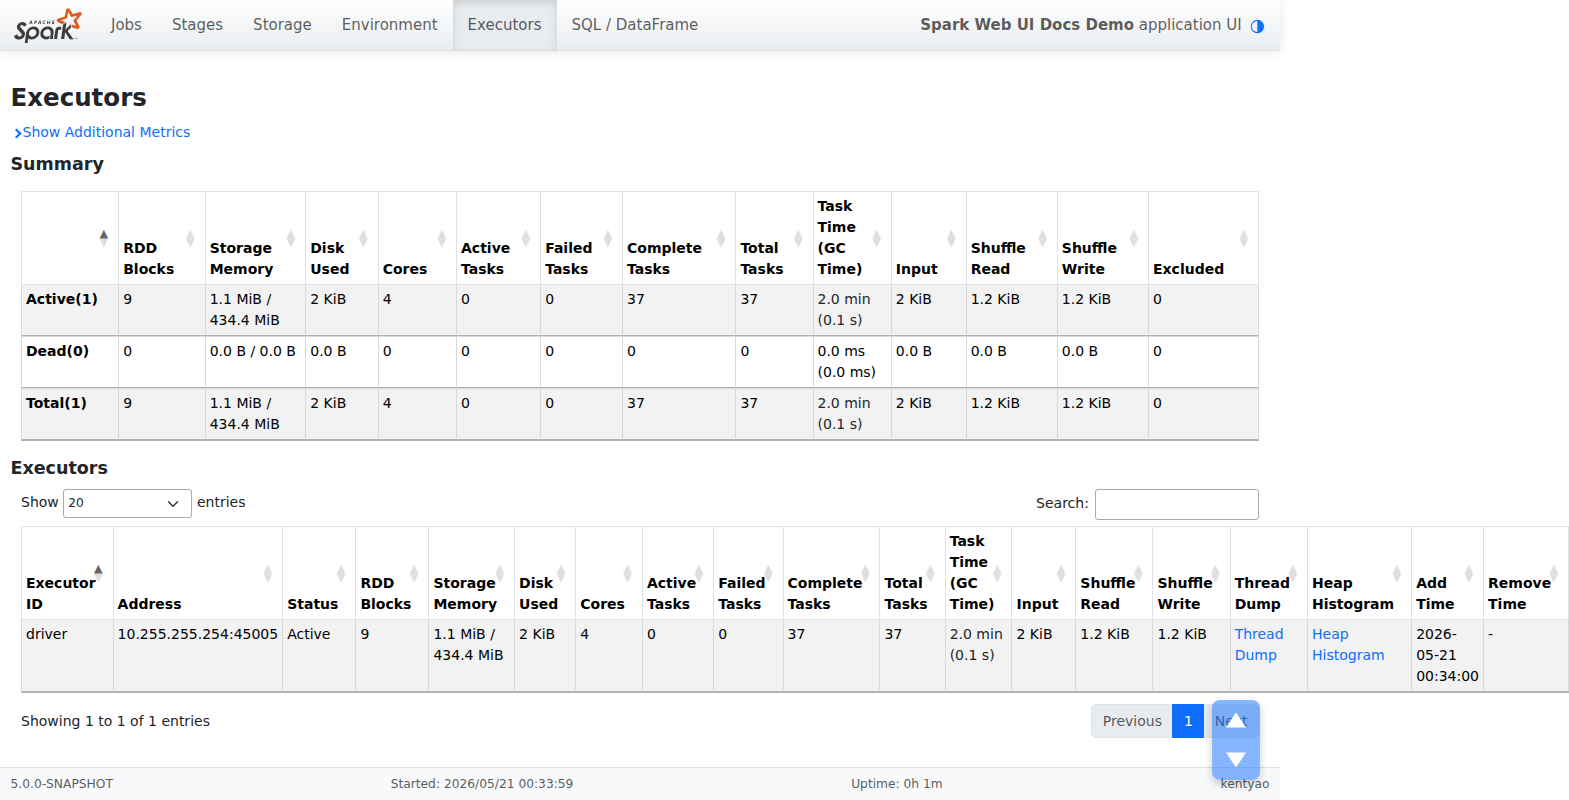
在 Spark UI 裡看到每一層
UI 也是同樣的層級。Jobs 分頁每個 job 一列,job 頁面列出它的 stage,stage 頁面每個 task 一列, Executors 分頁則顯示 task 執行時用到的 slot。
截圖取自 Apache Spark 官方文件 Web UI
(Apache License 2.0)。這個範例跑在 local 模式,所以唯一的 executor 就是 driver。
- Jobs 分頁:每個 action 一列。 Job 0 是
count at web-ui-docs-demo.py:25。Stages 欄出現1/1 (1 skipped)表示這個 job 重用了先前 job 已寫好的 shuffle 輸出,那個 stage 就不再重跑 (3-2)。
- Job 頁面:這個 job 的 stage。 Job 0 沒有 shuffle,所以只有一個 stage;它的
5/5個 task 就是它的五個 partition。
- Stage 頁面:每個 task 一列。
Index是這個 task 處理的 partition,Executor ID是執行它的 executor。Summary Metrics 是看出傾斜的地方:Max執行時間遠高於Median(6-1)。
- Executors 分頁:slot。
Cores是 executor 的核心數,在預設spark.task.cpus=1下也就是它 同時能跑幾個 task;Active Tasks是它現在正在跑幾個。這裡 37 個 task 全都經過同一個有 4 個核心的 executor,可見 task 是工作單元,不是行程。
3-2) Spark 怎麼把 job 切成 stage?
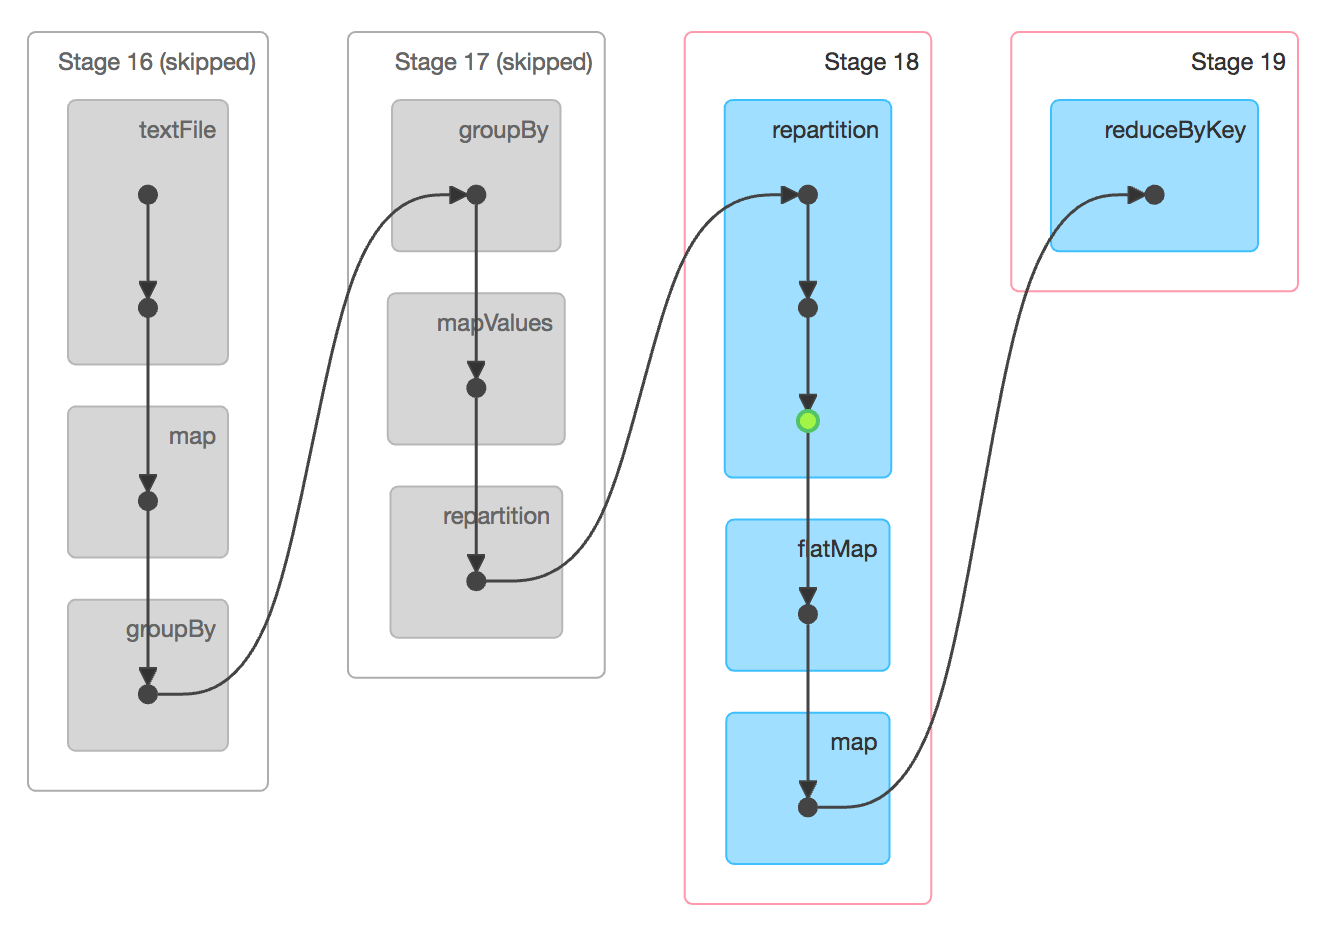
DAGScheduler 從 action 往回走,在每個寬(shuffle)依賴處切一刀;兩刀之間的所有東西就是一個 stage。
- 窄依賴留在 stage 內,並被 pipeline 起來。
- 餵給 shuffle 的 stage 是 shuffle map stage;產生 action 結果的最後一個 stage 是 result stage。
- 一個 stage 必須等它所有的父 stage 完成才會執行,因為它要讀父 stage 的 shuffle 輸出。
- 如果前一個 job 留下的 shuffle 輸出還在,該 stage 會被跳過 —— 在 Spark UI 裡顯示為灰色。
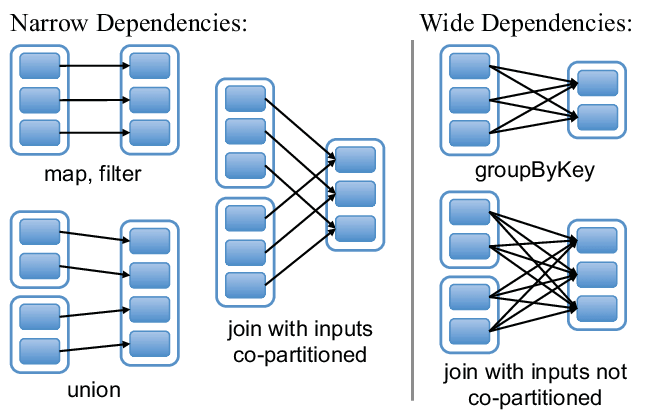
3-3) 窄依賴 vs 寬依賴
窄依賴:每個父 partition 最多供應一個子 partition,所以資料不用移動。寬依賴:一個父 partition 供應多個子 partition,需要 shuffle 與新的 stage。
| 窄依賴 | 寬依賴 | |
|---|---|---|
| 例子 | map、filter、flatMap、select、union、coalesce |
groupByKey、reduceByKey、distinct、repartition、大部分 join |
| 資料移動 | 沒有 | 透過網路 shuffle |
| Stage 邊界 | 不會 —— 被 pipeline 起來 | 會 |
| 遺失 partition 的復原 | 重算一個父 partition | 可能要重算很多父 partition |
- 如果 join 的兩邊已經 co-partitioned(相同的 partitioner、相同的 partition 數),那它是窄依賴 —— 不需要 shuffle。
- 從實體計畫判斷,不要看 API 名稱:
Exchange節點就是 shuffle。
3-4) 什麼是 partition?
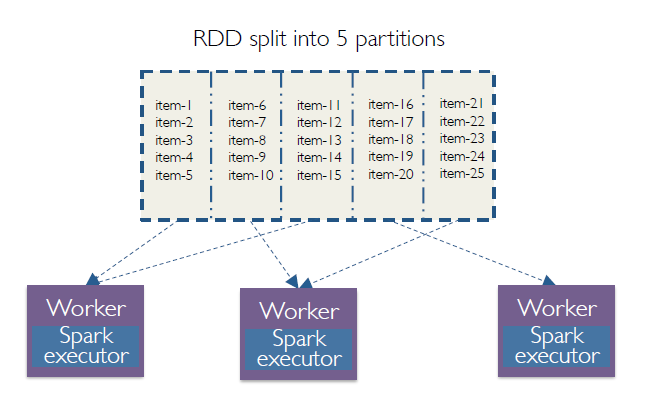
Partition 是分散式資料集的一塊,也是平行度的單位:一個 task 在一個核心上處理一個 partition。
- Partition 數決定平行度 —— 4 個 partition 跑在 16 個核心上,會有 12 個核心閒著。
- Partition 大小決定每個 task 的記憶體與時間 —— 目標大約每個 partition 100–200 MB; 太小會把時間浪費在排程,太大會溢寫或 OOM。
- 數量從哪來 —— 檔案掃描把輸入切成每份約
spark.sql.files.maxPartitionBytes(128 MB); shuffle 產生spark.sql.shuffle.partitions(200)個 partition,除非 AQE 把它們合併; RDD 操作預設用spark.default.parallelism。 - Locality —— 排程器偏好在 partition 資料已經所在的地方執行 task。
3-5) repartition vs coalesce
repartition(n) 做完整 shuffle,可以增加或減少數量,輸出大小平均;coalesce(n) 不 shuffle、
直接合併現有的 partition,只能減少。
coalesce(2) — no shuffle, neighbours merged       repartition(3) — full shuffle, rebalanced
[P1] ─┐                                            [P1] ─┐ ┌─► [N1]
[P2] ─┴─► [M1]                                     [P2] ─┼─┼─► [N2]
[P3] ─┐                                            [P3] ─┘ └─► [N3]
[P4] ─┴─► [M2]
repartition(n) / repartition(col) |
coalesce(n) |
|
|---|---|---|
| Shuffle | 一定會 | 不會 |
| 增加數量 | 可以 | 不行 |
| 輸出平衡 | 平均(hash 或 round-robin) | 跟輸入一樣不平均 |
| 典型用途 | 修正傾斜或太少的 partition;寫入前依某欄位分群 | 大量 filter 之後減少輸出檔案數 |
- 陷阱:寫入前的
coalesce(1)會把整個上游 stage 壓成一個 task,而不只是寫入那一步。 如果上游工作很重,repartition(1)能讓工作保持平行,代價是一次 shuffle。 repartitionAndSortWithinPartitions(partitioner)(RDD)在 shuffle 本身裡完成重新分區與排序 —— 比先repartition再排序便宜。
3-6) 如何用自訂 partitioner 做最佳化?
對反覆 join 或查找的兩邊,先依同一個 key 分區一次,之後在該 key 上的操作就會發現對應的資料列已經放在一起,從而省掉 shuffle。
// scala — RDD API
import org.apache.spark.HashPartitioner

val users = usersRdd.partitionBy(new HashPartitioner(200)).persist()
val joined = users.join(eventsRdd)      // only eventsRdd is shuffled; users stays put
partitionBy之後要 persist,否則分區每次都會重算 —— 而且會遺失。map會丟掉 partitioner(key 可能變了);mapValues與flatMapValues會保留它。- DataFrame 要達到同樣效果,反覆 join 時用 bucketing(寫入時
bucketBy),單一 job 內則用repartition(col)。
4) RDD、DataFrame 與運算子 優先度 4/5 — 高價值 — 這裡有缺口就會掉關
4-1) 什麼是 RDD?它和 HDFS block 有什麼不同?
RDD(Resilient Distributed Dataset)是一個不可變、已分區的集合,加上重算任何 partition 的配方 —— 它的 lineage —— 所以遺失的 partition 是被重建,而不是從副本還原。
- Resilient —— 透過 lineage 容錯。Distributed —— partition 分散在各 executor。 Dataset —— 一個資料紀錄的集合。
- RDD 是延遲且邏輯上的:它是一份計畫,不是記憶體裡的資料。只有 action 執行時才會實體化,
而且只有你
cache()它才會保留。 - HDFS vs RDD:HDFS 把資料以有副本的 block 持久保存(預設三份);RDD 是對這類資料的運算, 靠重算而不是靠副本撐過故障。兩者搭配運作 —— RDD 的 partition 常常一個 HDFS block 建一個, 讓 task 可以在 block 所在的地方執行。
4-2) RDD vs DataFrame vs Dataset
預設用 DataFrame(或 Spark SQL):它帶有 schema,所以 Catalyst 與 Tungsten 能最佳化它。 只有遇到 DataFrame API 表達不了的邏輯時才降到 RDD。
| RDD | DataFrame | Dataset | |
|---|---|---|---|
| Schema | 沒有 —— 不透明的物件 | 有 —— 具名、有型別的欄位 | 有 |
| 最佳化 | 沒有 —— 照你寫的 lambda 執行 | Catalyst + Tungsten | Catalyst + Tungsten(lambda 不透明) |
| 型別安全 | 編譯期(Scala) | 執行期 —— 錯的欄位在分析階段失敗 | 編譯期(Scala / Java) |
| 語言 | 全部 | 全部 | 只有 Scala 與 Java |
| 適用 | 低階控制、非結構化資料 | 幾乎所有情況 | 有型別的 Scala 管線 |
在 Scala 裡 DataFrame 就是 Dataset[Row]。PySpark 沒有有型別的 Dataset —— PySpark 的
DataFrame 就是無型別的 API。深入解析:../de/spark.md §3-1。
4-3) Transformation、action 與延遲執行
Transformation 回傳新的資料集,只是在計畫裡加一步;action 把值回傳給 driver 或寫出輸出, 是它們讓 Spark 真正執行。
| Transformation(延遲) | Action(執行一個 job) |
|---|---|
map、flatMap、filter、select、withColumn |
count、collect、take(n)、first |
groupBy、join、distinct、union、sample |
show、reduce、foreach |
repartition、coalesce、sortBy |
write…save、saveAsTextFile |
為什麼要延遲? 在執行前看到整條鏈,Spark 才能把窄步驟融合成一次掃描、把過濾與欄位選擇推進 掃描裡、挑選 join 策略,並跳過結果從未被用到的工作。
# python
df = spark.read.parquet("s3://bucket/events/")
adults = df.filter("age > 18")            # nothing runs
slim = adults.select("user_id", "age")    # nothing runs
slim.show()                               # one job: scan only two columns, filter in the scan
- 「Spark 運算子」(常見的說法)指的就是這兩類。
- 因為 action 之前什麼都不執行,transformation 裡的錯誤會在 action 時才出現,常常在好幾行之後 —— 這是除錯時常見的困惑來源。
4-4) map vs flatMap、map vs mapPartitions、reduce vs reduceByKey
map 是一對一,flatMap 是一對多;mapPartitions 每個 partition 呼叫你的函式一次,而不是每列一次;
reduce 是回傳單一值的 action,reduceByKey 是每個 key 回傳一個值的 transformation。
# python
lines = sc.parallelize(["a b", "c"])
lines.map(lambda s: s.split(" ")).collect()       # [['a', 'b'], ['c']]
lines.flatMap(lambda s: s.split(" ")).collect()   # ['a', 'b', 'c']

def enrich(rows):
    client = make_client()          # one expensive setup per partition, not per row
    for row in rows:
        yield client.lookup(row)

enriched = records.mapPartitions(enrich)
- 當每次呼叫都有初始化成本時 —— 資料庫連線、載入模型 ——
mapPartitions才划算。 它的陷阱:把整個 partition 建成 list 而不是逐列 yield,會把整個 partition 載入記憶體,可能讓 executor OOM。 reduce(f)把一個值帶回 driver;reduceByKey(f)保持分散並會 shuffle。
4-5) reduceByKey vs groupByKey vs combineByKey
優先用 reduceByKey:它在 shuffle 前先在 map 端合併值,所以每個 partition 每個 key 只有一個部分結果
跨網路傳送。groupByKey 會傳送每一個值,然後一次把某個 key 的所有值放進記憶體。
// scala
val sums1 = pairs.reduceByKey(_ + _)                 // map-side combine, then shuffle
val sums2 = pairs.groupByKey().mapValues(_.sum)      // shuffles every value; a hot key can OOM
combineByKey(createCombiner, mergeValue, mergeCombiners)是前兩者建構其上的通用形式; 當結果型別和值的型別不同時用它 —— 算平均需要每個 key 一個(sum, count)。aggregateByKey(zero)(seqOp, combOp)是同樣的概念,多了一個初始值。- 只有在你真的需要所有值放在一起時,
groupByKey才是對的 —— 而且要小心傾斜。 - 在 DataFrame 裡這個選擇不存在:
groupBy().agg()會自動做部分聚合 (計畫裡是HashAggregate→Exchange→HashAggregate)。
4-6) 對 Spark 來說,polyglot 是什麼意思?
一個引擎、多個語言前端:Scala、Java、Python、R 與 SQL 都建立同一份邏輯計畫, 所以 DataFrame 查詢不管用哪種語言寫,速度都一樣。
例外是 Spark 看不進去的程式碼:Python UDF 或 Python RDD 的 lambda 在獨立的 Python worker 裡逐列執行,
中間要序列化。內建函式與 pandas(Arrow)UDF 能避開大部分這類成本 —— 見 ../de/spark.md §10-2。
4-7) 什麼是 sparse vector?
只儲存非零項目的向量 —— 大小、索引、值 —— 而不是每個元素;MLlib 用它來表示高維特徵, 例如 one-hot 或 TF-IDF 欄位。
# python
from pyspark.ml.linalg import Vectors

dense = Vectors.dense([0.0, 3.0, 0.0, 4.0])
sparse = Vectors.sparse(4, [1, 3], [3.0, 4.0])     # the same vector, two stored values
5) Shuffle、Broadcast 與 Join 優先度 5/5 — 必備 — 幾乎每一輪面試都會出現
5-1) 什麼是 shuffle?什麼會觸發它?
Shuffle 在 partition 之間重新分配資料列,讓同一個 key 的所有資料列落在一起; 依 key 分組、join、去重、排序或重新分區都會觸發它。
Before (partitioned by file)        groupBy("user_id").sum("amount")      After
P0: (A,100) (B,200)                 every map task writes its rows          P0': A → 400
P1: (A,300) (C,400)        ──────►  bucketed by hash(user_id), every  ──►   P1': B → 700
P2: (B,500)                         reduce task fetches its bucket          P2': C → 400
- 觸發者:
groupBy/*ByKey、join(除非 broadcast 或已 co-partitioned)、distinct、orderBy、repartition、帶partitionBy的 window function。 - 在實體計畫裡 shuffle 是
Exchange節點;在 Spark UI 裡是 stage 的 Shuffle Write / Shuffle Read 欄位。
5-2) 為什麼 shuffle 很貴?它是怎麼實作的?
每一列被 shuffle 的資料都要序列化、寫到本機磁碟、透過網路傳送、再讀回來 —— 而且 map 端要全部完成, reduce 端才能開始。
- Sort-based shuffle(預設):每個 map task 依目標 partition 排序輸出,寫出一個資料檔加一個索引檔, 而不是每個 reducer 一個檔案。舊的 hash shuffle 會產生 M × R 個檔案,已被移除。
- Bypass-merge 路徑:當 reduce partition 數不超過
spark.shuffle.sort.bypassMergeThreshold(200)且沒有 map 端聚合時,Spark 為每個 reducer 寫一個檔案再串接起來,跳過排序。 - 成本:序列化的 CPU、磁碟 I/O、網路 I/O,以及排序緩衝區的記憶體 —— 滿了就溢寫到磁碟。
spark.shuffle.file.buffer(32 KB)是每個 shuffle 檔案 writer 的記憶體緩衝; 在超大的 shuffle 上調到 64 KB–1 MB 可以減少磁碟系統呼叫。- External shuffle service 在寫出 shuffle 檔案的 executor 消失後仍能提供這些檔案, 這是在 YARN 上安全使用 dynamic allocation 的前提。
深入解析:../de/spark.md §5-1;一筆資料如何經過序列化、磁碟與網路,見
§9-5。
5-3) 如何把 Spark job 的資料傳輸降到最低?
少搬資料:盡早過濾與選欄位、broadcast 小表、shuffle 前先合併,並且只 shuffle 一次而不是反覆 shuffle。
- 盡早過濾、只選需要的欄位 —— 搭配 Parquet / ORC 時,Catalyst 會把它們推進掃描,
那些資料根本不會被讀。在計畫裡確認
PushedFilters。 - Broadcast join 小的那邊,而不是 shuffle 大的那邊(5-5)。
- 在 map 端合併 —— 用
reduceByKey取代groupByKey;DataFrame 的聚合會自動這麼做。 - 重用分區 —— 同一個 key 反覆 join 時,依 join key 分區或分桶一次(3-6)。
- 避免不必要的
repartition/distinct/orderBy—— 每一個都是完整 shuffle。 - 用精簡的序列化器 —— RDD job 用 Kryo;DataFrame 已經用 Tungsten 的二進位格式。
有時會被列在這裡的 accumulator 不會減少資料傳輸 —— 它們只是回傳給 driver 的唯寫計數器。
5-4) Broadcast 變數與 accumulator
Broadcast 變數把一個唯讀值送到每個 executor 一次,而不是隨每個 task 送;accumulator 是 task 往上加、 只有 driver 能讀的計數器。
# python
country_names = sc.broadcast({"TW": "Taiwan", "US": "United States"})
bad_rows = sc.accumulator(0)

def label(row):
    if row.country not in country_names.value:
        bad_rows.add(1)
        return None
    return (row.user_id, country_names.value[row.country])

labelled = events.rdd.map(label).filter(lambda r: r is not None)
labelled.count()               # the action; bad_rows.value is now filled in
- Broadcast 必須放得進 driver 與 executor 的記憶體;
unpersist()/destroy()會釋放它。 - Accumulator 陷阱:在 transformation 裡的更新,如果 task 重試或 stage 重算,可能被算不只一次;
只有在 action(
foreach)裡的更新保證恰好一次。把 transformation 端的計數當成近似值。
5-5) Broadcast join vs shuffle join
如果有一邊很小,就 broadcast 它,join 時不必 shuffle 大的那邊;否則 Spark 會依 join key shuffle 兩邊,再 sort-merge。
| 策略 | Spark 何時選它 | Shuffle |
|---|---|---|
| Broadcast hash join | 有一邊小於 spark.sql.autoBroadcastJoinThreshold(10 MB),或有 broadcast() hint |
大的那邊不用 |
| Sort-merge join | 兩邊都大的 equi-join 的預設 | 兩邊都要 |
| Shuffle hash join | 每個 partition 裡有一邊小很多;放得下時 AQE 會偏好它 | 兩邊都要,但不排序 |
| Broadcast nested loop join | 有一邊很小的非等值 join | 不用,但要 O(n × m) 次比較 |
| Cartesian | cross join | 全部 —— 避免 |
# python
from pyspark.sql.functions import broadcast

joined = large_orders.join(broadcast(small_countries), "country_code")
- 陷阱:full outer join 完全不能用 broadcast hash join;left outer join 只能 broadcast 右邊。
- 陷阱:大小估計可能是錯的(過濾後的表看起來很小、UDF 的輸出大小未知)。AQE 會在執行期看到 真實大小後切換成 broadcast join 來修正。
深入解析:../de/spark.md §7-1。
6) 資料傾斜 優先度 5/5 — 必備 — 幾乎每一輪面試都會出現
6-1) 什麼是資料傾斜?怎麼發現它?
傾斜就是少數幾個 key 擁有大部分的資料列,所以少數 task 做了大部分的工作,整個 stage 都在等它們。
Stage 3 task durations            Stage 3 shuffle read per task
task 0      12 s                  task 0       110 MB
task 1      11 s                  task 1       105 MB
task 2      13 s                  task 2       118 MB
task 199   850 s   ◄── straggler  task 199     9.6 GB  ◄── one hot key
依序確認:
- Spark UI → Stages → 慢的那個 stage → Summary Metrics:比較 duration 與 shuffle read size 的 max 和 median。max 遠大於第 75 百分位就是傾斜。
- 排除其他可能:慢節點(總是同一個 executor 慢)、GC(GC time 很高)或溢寫(spill (disk) 很大)。
- 找出熱門 key:
# python
(df.groupBy("join_key").count()
   .orderBy("count", ascending=False)
   .show(20))
常見元凶:NULL 或空字串 key、像 0 或 "unknown" 這樣的預設值、名人使用者、某個國家、機器人流量。
6-2) 怎麼修正資料傾斜?
先開啟 AQE 的 skew join 處理,有一邊小就 broadcast,兩者都不夠時再對熱門 key 加鹽。
| 修法 | 什麼時候 | 怎麼做 |
|---|---|---|
| 丟掉或隔離垃圾 key | 熱門 key 是 NULL / "unknown" |
過濾掉,或另外處理後再 union 回來 |
| AQE skew join | sort-merge join,Spark 3.0+ | spark.sql.adaptive.skewJoin.enabled=true(啟用 AQE 時預設開啟)會切開過大的 partition |
| Broadcast join | 另一邊很小 | broadcast(small_df) —— 沒有 shuffle,就沒有傾斜的 partition |
| 兩階段(加鹽)聚合 | 可結合的聚合遇上傾斜的 groupBy |
先依 (key, salt) 聚合,再依 key 聚合 |
| 加鹽 join | 大表對大表、少數熱門 key | 傾斜那邊加隨機鹽,另一邊複製到所有鹽值 |
| 拆出熱門 key | 少數已知的熱門 key | 熱門 key 用 broadcast join,其餘用 sort-merge,再 union |
兩階段聚合:
# python
from pyspark.sql import functions as F

SALT_BUCKETS = 16
partial = (df.withColumn("salt", (F.rand() * SALT_BUCKETS).cast("int"))
             .groupBy("user_id", "salt")
             .agg(F.sum("amount").alias("partial_sum"),
                  F.count("*").alias("partial_cnt")))
totals = (partial.groupBy("user_id")
                 .agg(F.sum("partial_sum").alias("total"),
                      F.sum("partial_cnt").alias("cnt")))
這只適用於能由部分結果合併的聚合 —— sum、count、min、max;平均是在第二階段之後算
sum / count,而 countDistinct 需要別的做法。
加鹽 join —— 大的那邊加隨機鹽,小的那邊展開到每一個鹽值:
# python
from pyspark.sql import functions as F

SALT_BUCKETS = 16
big_salted = big.withColumn("salt", (F.rand() * SALT_BUCKETS).cast("int"))
small_salted = small.withColumn(
    "salt", F.explode(F.array([F.lit(i) for i in range(SALT_BUCKETS)])))
joined = big_salted.join(small_salted, ["join_key", "salt"]).drop("salt")
代價是把較小的那邊複製 SALT_BUCKETS 倍 —— 那邊不夠小時,只對熱門 key 加鹽。深入解析:../de/spark.md §7-3。
7) 快取、持久化與 Checkpoint 優先度 4/5 — 高價值 — 這裡有缺口就會掉關
7-1) cache vs persist
cache() 就是用預設儲存層級的 persist();persist(level) 讓你選擇記憶體、磁碟、序列化或複本。
兩者都是延遲的 —— action 執行前什麼都不會存。
- 預設層級:RDD 是
MEMORY_ONLY,DataFrame / Dataset 是MEMORY_AND_DISK(在 PySpark 裡顯示為MEMORY_AND_DISK_DESER)。 - 每個 executor 上的 block manager 保存 partition;driver 追蹤哪些 block 在哪裡。快取的資料在同一個 application 的多個 job 之間保留,不跨 application。
unpersist()會釋放它。記憶體壓力下,沒在用的快取資料以 LRU 方式被逐出。- 該快取的時候:資料集被兩個以上的 action 重用、或在迭代迴圈裡,而且重算很貴。 不要快取只用一次的東西,或大到會把其他東西都擠掉的東西 —— 重讀 Parquet 常常更便宜。
7-2) 有哪些儲存層級?
沿三個軸選擇 —— 記憶體和/或磁碟、反序列化的物件或序列化的位元組、一份或兩份。
| 層級 | 存在哪 | 放不下時會怎樣 |
|---|---|---|
MEMORY_ONLY |
記憶體,反序列化物件 | 缺的 partition 在需要時重算 |
MEMORY_AND_DISK |
先記憶體,再磁碟 | 放不下的 partition 寫到磁碟,需要時讀回 |
MEMORY_ONLY_SER |
記憶體,序列化位元組 | 比較小,但反序列化要花 CPU;其餘重算 |
MEMORY_AND_DISK_SER |
記憶體(序列化),再磁碟 | 其餘溢寫而不是重算 |
DISK_ONLY |
只有本機磁碟 | — |
OFF_HEAP |
序列化,放在 JVM heap 之外 | 需要 spark.memory.offHeap.enabled 與大小設定 |
…_2(例如 MEMORY_AND_DISK_2) |
在不同 executor 上的兩份複本 | 復原更快,記憶體加倍 |
在 PySpark 裡,資料在 JVM 端一律以序列化形式儲存,所以 _SER 變體在那裡沒有差別。
7-3) Cache / persist vs checkpoint
Persist 保留 lineage,在 application 存活期間把資料存在 executor 上;checkpoint 把資料寫到可靠的儲存 並切斷 lineage,所以它撐得過 executor 遺失,也讓計畫保持簡短。
persist / cache |
checkpoint |
|
|---|---|---|
| 存在 | executor 記憶體 / 本機磁碟 | 可靠的儲存 —— HDFS、S3(sc.setCheckpointDir) |
| Lineage | 保留 —— 遺失的 block 會重算 | 截斷 —— checkpoint 成為新的來源 |
| 存活期 | 跟著 application 結束 | 檔案一直留著,直到你刪除 |
| 成本 | 便宜 | 多一次完整寫入;除非先 persist,否則會重算資料 |
| 用途 | job 內重用 | 很長的 lineage(迭代 ML、圖演算法)、串流狀態 |
persist(DISK_ONLY)存在本機磁碟,不是 RAM —— 而且仍會跟著 executor 一起遺失。rdd.checkpoint()會在下一個 action 之後跑一個獨立的 job,並重算該 RDD —— 所以 checkpoint 前先 persist。DataFrame.checkpoint()預設是 eager。localCheckpoint()截斷 lineage,但存在 executor 上:比較快,但不容錯。- Structured Streaming 的
checkpointLocation是另一回事:用於復原的 offset 與狀態(見 11-3)。
7-4) 如何清理累積的 metadata?
Spark 的 ContextCleaner 會在 driver 不再參照時移除 shuffle 檔案、broadcast 與快取的 RDD;
對長時間執行的 application,你要靠 unpersist 與丟掉參照來幫它。
spark.cleaner.ttl—— 舊面試題清單裡的答案 —— 已在 Spark 2.0 移除。- 用完快取的資料集或 broadcast 時,明確呼叫
unpersist()/destroy()。 spark.cleaner.periodicGC.interval(30 分鐘)會強制 driver 做 GC,讓長壽 driver 找到弱參照。- 很長的 lineage(上千步的迭代迴圈)會讓 driver 的計畫膨脹:定期
checkpoint(),或把中間結果寫到 儲存再讀回來。
8) 記憶體與 OOM 優先度 5/5 — 必備 — 幾乎每一輪面試都會出現
8-1) Executor 記憶體是怎麼配置的?
JVM heap 裡有 300 MB 保留區、一塊放你自己物件的 user 區,以及 execution 與 storage 共用的 unified 區;heap 之外還有 memory overhead。
Executor container (YARN container / K8s pod)
├── spark.executor.memoryOverhead       max(384 MB, 10% of executor memory): JVM internals,
│                                       thread stacks, NIO buffers, Python workers
└── spark.executor.memory (JVM heap)
    ├── Reserved memory                 300 MB, fixed
    ├── User memory                     (1 − spark.memory.fraction) × (heap − 300 MB)
    │                                   your data structures, UDF objects
    └── Unified memory                  spark.memory.fraction (0.6) × (heap − 300 MB)
        ├── Storage                     cache, broadcasts; spark.memory.storageFraction (0.5)
        │                               of it is protected from eviction
        └── Execution                   shuffles, joins, sorts, aggregations
- 借用:execution 可以拿走空閒的 storage 記憶體,並逐出受保護部分以上的快取 block; storage 可以借空閒的 execution 記憶體,但永遠不能逐出它。
- Off-heap(
spark.memory.offHeap.enabled+.size)把 Tungsten 的緩衝區移出 heap,避開 GC。
以 --executor-memory 8g 實算:unified = 0.6 × (8192 − 300) MB ≈ 4.6 GB,其中約 2.3 GB 是受保護的
storage;user ≈ 3.1 GB;overhead = 819 MB,所以 container 要約 8.8 GB。深入解析:../de/spark.md §9-1。
8-2) 如何預防與修正 out-of-memory 錯誤?
先搞清楚是誰的記憶體用完了 —— driver 的、executor 的 heap,還是 container 的 overhead —— 因為每一種的修法都不同。
| 症狀 | 常見原因 | 修法 |
|---|---|---|
Driver OutOfMemoryError: Java heap space |
對大結果 collect() / toPandas();broadcast 大表;超大的計畫 |
改寫到儲存而不是 collect;用 take(n);縮小 broadcast;調高 spark.driver.memory |
Total size of serialized results … is bigger than spark.driver.maxResultSize |
同上,只是提早被攔下 | 別再 collect;只有真的需要該結果時才調高上限 |
一兩個 task 發生 executor OutOfMemoryError |
傾斜的 partition;對熱門 key 做 groupByKey |
修正傾斜(第 6 節),增加 partition |
| 很多 task 都 executor OOM | partition 太大;太多核心共用一個 heap | 調高 spark.sql.shuffle.partitions;每個 executor 少一點核心;加記憶體 |
Container killed … exceeding memory limits / exit code 137 |
是 overhead,不是 heap —— Python worker、off-heap、原生緩衝區 | 調高 spark.executor.memoryOverhead |
GC overhead limit exceeded、GC 時間很長 |
存活物件太多 | 少快取物件、用 DataFrame 取代 RDD、縮小 partition |
能預防大多數 OOM 的習慣:永遠不要把大資料集拉到 driver、partition 維持在 100–200 MB 左右, 並且修正傾斜而不是一直加記憶體。
延伸閱讀:Spark OOM error closeup。
8-3) 什麼是 spill?它是問題嗎?
Spill 是運算子因為 execution 記憶體滿了,把記憶體中的緩衝寫到本機磁碟;它讓 task 活下來,但會慢很多。
- UI 裡每個 task 都會顯示 Spill (memory) 與 Spill (disk)。
- 偶爾 spill 沒關係。每個 task 都大量 spill 代表 partition 太大 —— 增加 partition 數。 只有少數 task 大量 spill 代表傾斜。
- OOM 發生在某個東西無法 spill 的時候:一筆超大紀錄、shuffle-hash 的 build side、 Python worker,或 overhead 用完。
9) 容錯與故障 優先度 4/5 — 高價值 — 這裡有缺口就會掉關
9-1) Executor 或節點故障 —— 會發生什麼?
Spark 會在別處重跑遺失的 task,並從 lineage 重算遺失的 partition;如果 shuffle 輸出也遺失了, 就重跑產生它的 map stage。
- Task 失敗 —— 在另一個 executor 上重試,最多
spark.task.maxFailures(4)次; 第四次失敗會讓 stage 與 job 失敗。 - Executor 遺失 —— 它正在跑的 task 被重新排程;它快取的 block 在下次需要時重算。
- Shuffle 檔案遺失 —— reducer 遇到
FetchFailedException;排程器重新提交父 map stage 來重新產生它們。如果死掉的只是 executor 而不是節點,external shuffle service 可以避免這種情況。 - 壞節點 ——
spark.excludeOnFailure.enabled會停止在一直失敗的 executor 或節點上排程。 - 落後者(straggler) ——
spark.speculation=true會為慢的 task 啟動一個複本,取先完成的那個。 只有在輸出寫入是冪等的時候才用。
當原因是過載時(節點因記憶體被砍,或 GC 下心跳逾時):重試會以同樣方式失敗,所以要修正負載 ——
增加 partition、修正傾斜、調高 memory overhead、縮小 executor —— 而不是調高 maxFailures。
9-2) 如果 driver 故障呢?
Application 跟著它一起死 —— executor 屬於 driver —— 所以復原要靠 cluster manager 重啟它, 以及 job 可以安全地重跑。
- YARN
cluster模式會重試 ApplicationMaster(spark.yarn.maxAppAttempts);Standalonecluster模式有--supervise。 - 重啟的批次 job 會從頭開始,所以它的寫入必須是冪等的(13-2)。
- 重啟的串流查詢會從它的 checkpoint 繼續(11-3)。
10) Spark SQL、Catalyst 與 AQE 優先度 4/5 — 高價值 — 這裡有缺口就會掉關
10-1) Catalyst 最佳化器怎麼運作?
Catalyst 把查詢變成一棵樹,在讀任何資料之前分四個階段改寫它 —— 分析、邏輯最佳化、實體規劃與程式碼產生。
- 分析 —— 依 catalog 解析表名與欄位名:未解析的邏輯計畫變成已解析的,或以
AnalysisException失敗。 - 邏輯最佳化 —— 以規則為基礎的改寫:predicate pushdown、column pruning、constant folding、 合併過濾條件、簡化運算式。
- 實體規劃 —— 產生實體計畫(用哪種 join 策略、哪種聚合),並在可用時用統計資訊與成本模型挑選一個。
- 程式碼產生 —— whole-stage codegen 把一串運算子編譯成每個 stage 一個 JVM 函式,避免逐列的虛擬呼叫。
Tungsten 是執行端:精簡的二進位資料列(UnsafeRow)、off-heap 緩衝區,以及上述產生的程式碼。
深入解析:../de/spark.md §4-1。
10-2) 怎麼讀實體計畫?
由下往上讀 explain():先看掃描,再看過濾與投影,然後看每一個 Exchange(shuffle),
以及它周圍的 join 與聚合策略。
# python
df.explain("formatted")
| 節點 | 它告訴你什麼 |
|---|---|
FileScan parquet … PushedFilters: […], ReadSchema: … |
下推與裁剪有沒有生效 |
Filter、Project |
資料列過濾與欄位選擇 |
Exchange hashpartitioning(key, 200) |
依 key 做 shuffle,分成 200 個 partition |
BroadcastExchange + BroadcastHashJoin |
broadcast join |
Sort + SortMergeJoin |
shuffle join |
HashAggregate → Exchange → HashAggregate |
部分聚合、shuffle、最終聚合 |
*(n) 前綴 |
被 whole-stage codegen 融合進 stage n 的運算子 |
AdaptiveSparkPlan isFinalPlan=true |
AQE 在執行期重新規劃了這個查詢 |
10-3) 什麼是 AQE?它和 Catalyst 有什麼不同?
Catalyst 在執行前根據估計值規劃;Adaptive Query Execution 在執行中、於每個 shuffle 邊界, 根據已完成 stage 回報的真實大小重新規劃。 從 Spark 3.2 起預設開啟。
AQE 做三件事:
- 合併 shuffle partition —— 把很多很小的 shuffle 後 partition 合併成較少、大小剛好的 partition,
所以
spark.sql.shuffle.partitions可以放心設高。 - 切換 join 策略 —— 當某一邊結果很小時,把 sort-merge join 改成 broadcast join。
- 切開傾斜的 partition —— 把過大的 join partition 拆成多個 task。
# python
spark.conf.set("spark.sql.adaptive.enabled", "true")
spark.conf.set("spark.sql.adaptive.coalescePartitions.enabled", "true")
spark.conf.set("spark.sql.adaptive.skewJoin.enabled", "true")
AQE 幫不了第一個 shuffle 之前的問題(例如掃描時讀到太多小檔案),也幫不了 groupBy 裡的傾斜 ——
那些還是要你自己修。
10-4) Predicate pushdown 與 column pruning
Pushdown 把過濾條件移進資料來源,pruning 只讀你用到的欄位,所以被跳過的資料根本不會從磁碟讀出來。
- Parquet / ORC 每個 row group 都存 min / max 統計,所以下推的過濾條件可以跳過整個 row group; 而且因為是欄式格式,只會讀選取的欄位。
- Partition pruning 跳過整個目錄:對依
dt分區的表下WHERE dt = '2026-11-06',只會列出一個資料夾。 - Dynamic partition pruning(3.0+)在執行期把維度表上的過濾條件套用到已分區的事實表。
- 什麼會破壞它:過濾條件裡有 UDF、對被過濾的欄位做 cast,或沒有統計資訊的 CSV / JSON 來源。
用計畫裡的
PushedFilters確認。
11) 串流 優先度 4/5 — 高價值 — 這裡有缺口就會掉關
11-1) Spark Streaming(DStreams)vs Structured Streaming
DStreams 是舊的、以 RDD 為基礎的串流 API;Structured Streaming 把串流當成一張無界的表, 經由 SQL 引擎執行,應該用的是它。
| DStreams | Structured Streaming | |
|---|---|---|
| API | 每個批次區間一組 RDD | DataFrame / SQL |
| 最佳化器 | 沒有 | Catalyst + Tungsten |
| 事件時間與 watermark | 手動 | 內建 |
| 端到端 exactly-once | 自己做 | 搭配可重播的來源 + 冪等或交易式的 sink |
| 狀態 | 舊版,不再加新功能 | 現行 |
執行預設是 micro-batch —— 每次 trigger 把新資料當成一個小批次 job 處理。 實驗性的 continuous 模式可達毫秒級延遲,但只支援類似 map 的查詢。
# python
events = (spark.readStream.format("kafka")
          .option("kafka.bootstrap.servers", "broker:9092")
          .option("subscribe", "events")
          .load())

query = (events.selectExpr("CAST(value AS STRING) AS json")
         .writeStream.format("parquet")
         .option("path", "s3://bucket/output/")
         .option("checkpointLocation", "s3://bucket/checkpoints/events/")
         .outputMode("append")
         .start())
11-2) 事件時間、watermark 與輸出模式
事件時間是事件發生的時間,處理時間是 Spark 看到它的時間;watermark 說明事件最晚可以遲到多久 仍被計入,這也讓 Spark 能丟掉舊的狀態。
# python
from pyspark.sql import functions as F

counts = (events
          .withWatermark("event_time", "10 minutes")
          .groupBy(F.window("event_time", "5 minutes"), "country")
          .count())
- Watermark = 目前看到的最大事件時間 − 10 分鐘。一旦 watermark 越過某個 window 的結束時間, 該 window 就定案,狀態被丟掉。比 watermark 舊的資料可能被丟掉 —— 唯一的保證是門檻內的資料一定不會被丟。
- 沒有 watermark 的話,window 聚合或 stream–stream join 的狀態會無限成長。
- 深入解析 —— 遲到資料列、各輸出模式下的清理、join、多個 watermark 與正式環境的監控訊號:
spark.md§12-2 到 §12-6。
| 輸出模式 | 輸出什麼 | 適用 |
|---|---|---|
append |
只輸出永遠不會再變的資料列 | 聚合必須搭配 watermark |
update |
這次 trigger 改變的資料列 | 聚合;sink 必須支援 upsert |
complete |
每次 trigger 輸出整張結果表 | 只有聚合;狀態永不縮小 |
11-3) Checkpoint 與 exactly-once
Checkpoint 為每個 micro-batch 保存來源 offset 與運算子狀態,所以重啟的查詢會從停下的地方精確續跑; exactly-once 的輸出還需要可重播的來源,以及冪等或交易式的 sink。
- 來源 —— 必須可重播(Kafka、檔案),崩潰後才能重讀同一批。
- Checkpoint —— offset 在批次執行前寫入、執行後提交;每個查詢一個目錄,放在持久儲存上,絕不共用。
- Sink —— file sink 與 Delta / Iceberg 每批原子提交;用
foreachBatch時要自己讓寫入冪等, 例如以 batch id 或業務鍵做MERGE。 - Checkpoint 綁定查詢的形狀:改變聚合或狀態 schema 通常意味著要換新的 checkpoint 並回補資料。
11-4) Spark 串流會出現哪些錯誤?怎麼修?
大多數串流事故都是以下其中一種:批次耗時比 trigger 長、狀態無限成長、來源在被讀之前就丟了資料, 或重啟產生重複資料。
| 症狀 | 原因 | 修法 |
|---|---|---|
| 批次耗時 > trigger 間隔,延遲一直增加 | 輸入速率高於吞吐量;批次傾斜或 shuffle 很重 | 加 executor 或 partition;用 maxOffsetsPerTrigger 限制批次大小;簡化查詢 |
| 跑了幾小時或幾天後 executor OOM | 狀態無界 —— 沒有 watermark,或 dropDuplicates 視窗很長 |
加 watermark;改用 RocksDB state store(spark.sql.streaming.stateStore.providerClass) |
OffsetOutOfRangeException / 資料遺失警告 |
Kafka retention 刪掉了查詢還沒讀的 offset | 拉長 retention;對延遲設警報;failOnDataLoss 只在有意識的選擇下關閉 |
| 重啟後出現重複 | foreachBatch 裡的 sink 不冪等 |
以 batch id 或業務鍵做冪等寫入 |
| 改了程式碼後查詢無法重啟 | 對 checkpoint 中的狀態做了不相容的修改 | 換新的 checkpoint 位置並回補 |
| 太多小檔案 | file sink 搭配很短的 trigger | 拉長 trigger;對 Delta / Iceberg 做 compaction(OPTIMIZE) |
11-5) Spark Streaming(DStreams)裡的快取
DStream 可以像 RDD 一樣 persist(),當同一個串流被多個操作使用時有幫助;網路接收器(Kafka、socket)
預設已經把收到的資料複製存在兩個節點上。
Structured Streaming 沒有針對單一串流的快取 —— 在 foreachBatch 裡,如果批次 DataFrame 要餵給多個寫入,
就 persist() 它,結束時再 unpersist()。
12) 排錯演練 優先度 5/5 — 必備 — 幾乎每一輪面試都會出現
能區分 Spark 使用者與 Spark 工程師的題目都是開放式的:「這個 job 很慢 —— 你會怎麼做?」 用調查的順序來回答,而不是列一串設定。
12-1) Job 變慢了 —— 從哪裡開始?
在 Spark UI 找出慢的 stage,弄清楚時間是花在一個 task 還是所有 task 上,再讓答案決定修法。
- Jobs / Stages —— 哪個 stage 佔了大部分的實際時間?
- 該 stage 的 task 摘要 —— 比較 duration 的 max 與 median。
- 少數 task 慢很多 → 傾斜(第 6 節)或壞節點。
- 所有 task 都慢 → 每個 task 的資料太多,或每列的工作太多。
- 每個 task 的指標 —— input size、shuffle read、spill、GC time。
- Spill 很大 → partition 太大:增加 partition 數。
- GC time 很高 → 記憶體壓力:少快取物件、加記憶體、每個 executor 少一點核心。
- Shuffle 很大 → 某個 join 或聚合其實可以 broadcast、預先聚合或避開。
- SQL 分頁 —— 實體計畫:少了
PushedFilters、意料外的SortMergeJoin、CartesianProduct、 沒預期到的Exchange。 - Executors 分頁 —— 失敗的 task、遺失的 executor、某個 executor 比其他慢很多。
- 然後一次只改一件事,再量一次。
Symptom in the UI                          Most likely cause → fix
max task time ≫ median                     skew → AQE skew join, broadcast, salting
every task spills                          partitions too big → more partitions
thousands of tasks of a few ms             partitions too small / small files → coalesce, compact
one stage reads far more than it outputs   no pushdown → filter early, fix the predicate
job fine yesterday, slow today             input grew or a new hot key → check sizes and key counts
12-2) 一個 task 跑了 850 秒,其他都只要十秒
這是落後者(straggler)—— 把它的 shuffle read 大小和其他 task 比較,就能分辨是傾斜還是機器慢。
- 它的 shuffle read 大很多 → 熱門 key。用
groupBy(key).count()找出來,再套用第 6 節。 - 它的輸入正常,但跑在慢或忙碌的 executor 上 → 節點問題;speculation 或排除該節點有幫助。
- 它的 spill 或 GC time 很大 → 這個 partition 對每個核心分到的記憶體來說太大。
- 重試後就正常 → 暫時性的(吵鬧的鄰居、一次慢的 S3 讀取);考慮開 speculation。
12-3) 輸出有 50,000 個小檔案
太多 writer task 各自寫了幾 MB;在寫入前刻意控制輸出大小,並把已經存在的檔案做 compaction。
| 配置 | 10 GB 寫成 | 效果 |
|---|---|---|
| A | 10,000 個檔案 × 1 MB | 列目錄慢、每個檔案的 metadata 與 API 成本高,讀取時每個檔案一個 task |
| B | 100 個檔案 × 100 MB | 列目錄與讀取都快 |
- 寫入前:用
repartition(n)或repartition("dt"),讓每個輸出 partition 大約 128 MB–1 GB; 過濾後只是稍微減少時用coalesce(n)。 - 限制檔案大小:
spark.sql.files.maxRecordsPerFile。 - 讓 AQE 合併最後一次 shuffle(
spark.sql.adaptive.advisoryPartitionSizeInBytes)。 - 事後 compaction:Delta 用
OPTIMIZE,Iceberg 用rewrite_data_files,純 Parquet 則跑定期的 compaction job。 - 不要對高基數欄位做
partitionBy—— 每個 user ID 一個目錄就是小檔案工廠;改用 clustering 或 bucketing。
12-4) 哪些設定值得記住名字?
少數幾個設定就能解釋大部分調校討論;知道每一個控制什麼,並說明你會先看 Spark UI 再改任何一個。
| 設定 | 預設值 | 控制什麼 |
|---|---|---|
spark.executor.memory / .cores / .instances |
1g / 1(YARN)/ 2 | executor heap、每個 executor 的 task 槽數、executor 數量 |
spark.executor.memoryOverhead |
max(384 MB, 10%) | heap 外的餘裕 —— PySpark 要調高 |
spark.driver.memory |
1g | driver heap —— 只有計畫或結果真的很大時才調高 |
spark.sql.shuffle.partitions |
200 | DataFrame shuffle 後的 partition 數 |
spark.default.parallelism |
總核心數 | RDD shuffle 的 partition 數 |
spark.sql.adaptive.enabled |
true(3.2+) | AQE |
spark.sql.autoBroadcastJoinThreshold |
10 MB | 自動 broadcast join 的大小上限 |
spark.sql.files.maxPartitionBytes |
128 MB | 檔案掃描的輸入切分大小 |
spark.memory.fraction |
0.6 | heap 中分給 execution + storage 的比例 |
spark.dynamicAllocation.enabled |
false | 依工作量增減 executor |
spark.serializer |
Java | RDD 為主的 job 設成 KryoSerializer |
經驗法則:每個 executor 4–5 個核心;shuffle partition 數 ≈ shuffle 資料量 ÷ 128–200 MB,至少是總核心數的
2–3 倍,再讓 AQE 合併。深入解析:../de/spark.md §13-2。
13) 管線設計題 優先度 4/5 — 高價值 — 這裡有缺口就會掉關
設計題考的是你能不能把 Spark 放進一個系統裡。先講答案的形狀,再一個階段一個階段說明。
13-1) 設計一條 Kafka → Spark → lakehouse → 倉儲 的管線
原始事件只落地一次,用 Spark 分層精煉,再把聚合結果提供給 BI —— 每一層都能從下一層重播。
要複述的需求:每天約 1 TB 事件、接近即時的儀表板、能重新處理歷史資料、故障時不遺失資料、資料品質檢查。
Event producers
      │
      ▼
   Kafka ─────────────────────────────┐
      │ Structured Streaming          │ (retention = the replay window)
      ▼                               │
Bronze: raw events, append-only       │  Delta / Iceberg on S3 / GCS, partitioned by ingest date
      │ batch or streaming Spark
      ▼
Silver: parsed, typed, deduplicated, quality-checked
      │ batch Spark
      ▼
Gold: business aggregates (daily revenue, sessions)
      │
      ▼
BigQuery / Redshift / Snowflake ──► BI dashboards
| 層 | 存什麼 | Spark 的工作 |
|---|---|---|
| Bronze | 收到時的原始資料 | 帶 checkpoint 從 Kafka 附加寫入;payload 原封不動 |
| Silver | 清理過、統一格式、去重 | 用明確的 schema 解析、依 event_id 去重、隔離壞資料 |
| Gold | 業務層級的聚合 | join 與聚合;發布到倉儲 |
不用等面試官問就該提出的重點:
| 考量 | 答案 |
|---|---|
| 可靠性 | 每個串流查詢都有 checkpoint;Kafka retention 長到足以重播一次停機 |
| 重複 | Kafka 是 at-least-once:在 Silver 去重(13-3),sink 要冪等 |
| 重新處理 | Bronze 是重播來源;Silver 與 Gold 依日期從它重建 |
| 資料品質 | 一層發布前先做 schema、null、範圍與唯一性檢查 |
| 小檔案 | 串流寫入用排程的 OPTIMIZE 做 compaction |
| 成本 | 批次用 autoscaling 或 spot executor;串流叢集依尖峰而不是平均來配置 |
| 監控 | 輸入速率 vs 處理速率、批次耗時、consumer lag、每層的筆數檢查 |
13-2) 設計一個冪等、可重跑的每日批次
讓每次執行都是其邏輯日期的純函數:只讀一個輸入 partition,並原子地取代一個輸出 partition —— 這樣跑兩次和跑一次的結果一樣。
Job: daily_transactions(run_date = 2026-11-06)
input : s3://raw/transactions/dt=2026-11-06/
output: s3://gold/transactions/dt=2026-11-06/   (replaced, never appended to)
- 以邏輯日期參數化,由排程器傳入 —— 絕不在 job 裡用
current_date()。 - 只讀該日期的 partition,並使用明確的 schema。
- 確定性的轉換 —— 輸出值裡不要有
rand()或牆上時鐘的時間。 - 覆寫,不要附加:dynamic partition overwrite
(
spark.sql.sources.partitionOverwriteMode=dynamic)、Delta 的replaceWhere,或以業務鍵做MERGE。 - 原子發布 —— 用 table format 的提交,或先寫到 staging 再切換。
- 記錄每次執行 —— run ID、輸入版本、筆數 —— 讓回補可以被稽核。
- 回補就是對一段日期範圍重跑同一個 job;其他什麼都不用改。
# python
spark.conf.set("spark.sql.sources.partitionOverwriteMode", "dynamic")

(daily_df
 .write
 .mode("overwrite")
 .partitionBy("dt")
 .parquet("s3://gold/transactions/"))      # replaces only the dt partitions present in daily_df
13-3) 對串流去重
在 watermark 範圍內依唯一的事件 ID 去重,讓 Spark 為「看過的 ID」保留的狀態維持有界 —— 並讓 sink 冪等,處理漏網之魚。
# python
deduped = (events
           .withWatermark("event_time", "10 minutes")
           .dropDuplicates(["event_id", "event_time"]))
- 加入事件時間欄位,Spark 才能在 watermark 越過後丟掉狀態。Spark 3.5 新增
dropDuplicatesWithinWatermark(["event_id"]),不需要時間戳也相同。 - 狀態被丟掉之後才抵達的重複資料不會被抓到 —— 所以 sink 仍需要依
event_id做MERGE(或主鍵)作為最後防線。
13-4) AWS 與 GCP 上的託管 Spark
知道哪個託管服務在跑 Spark、周圍有哪些元件,設計題的答案才能講出真實的元件名稱。
| 雲端 | 服務 | 角色 |
|---|---|---|
| AWS | EMR(跑在 EC2、EKS 或 Serverless) | 託管的 Spark / Hadoop 叢集 |
| AWS | Glue | serverless 的 Spark ETL,加上 Glue Data Catalog |
| AWS | S3 · MSK · Redshift | 儲存 · 託管 Kafka · 倉儲 |
| GCP | Dataproc(叢集或 Serverless) | 託管的 Spark / Hadoop |
| GCP | Dataflow | 託管的 Apache Beam —— 管線上 Spark 的替代方案 |
| GCP | GCS · Pub/Sub · BigQuery | 儲存 · 訊息 · 倉儲 |
| 任何雲 | Databricks | 搭配 Delta Lake 的託管 Spark |
可以提的成本槓桿:每個 job 用臨時叢集、autoscaling、批次用 spot / preemptible executor、 partition 大小合適,叢集才不會閒著等落後者。
14) 讀書計畫與題庫 優先度 3/5 — 值得會 — 多半是必備模式的變形
14-1) 先學什麼
架構、job → stage → task 模型、shuffle、傾斜與 join 幾乎每場 Spark 面試都會出現; 先精通這些,再去管調校參數或 table format。
| 優先度 | 主題 | 本文位置 |
|---|---|---|
| P0 | 架構、spark-submit、driver vs executor |
2-1、2-2 |
| P0 | Job / stage / task、窄 vs 寬 | 3-1、3-3 |
| P0 | Shuffle 與 partition | 5-1、3-4 |
| P0 | 資料傾斜 | 6-1、6-2 |
| P0 | Join 策略 | 5-5 |
| P1 | Catalyst 與 AQE | 10-1、10-3 |
| P1 | 記憶體模型與 OOM | 8-1、8-2 |
| P1 | 用 Spark UI 排錯 | 12-1 |
| P1 | Structured Streaming、watermark、checkpoint | 11-2、11-3 |
| P2 | Table format 與管線設計 | 13-1、13-2 |
| P2 | 雲端上的託管 Spark | 13-4 |
14-2) 依難度排列的題庫
每題都大聲說出答案、控制在一分鐘內,再對照連結的章節檢查。
| # | 題目 | 難度 | 答案 |
|---|---|---|---|
| 1 | Spark 是什麼?它和 MapReduce 有什麼不同? | 基礎 | 1-1、1-2 |
| 2 | Driver 與 executor 是什麼? | 基礎 | 2-1 |
| 3 | Transformation vs action —— Spark 為什麼要延遲執行? | 基礎 | 4-3 |
| 4 | 什麼是 RDD?RDD vs DataFrame vs Dataset? | 基礎 | 4-1、4-2 |
| 5 | cache vs persist;有哪些儲存層級? |
基礎 | 7-1、7-2 |
| 6 | Job、stage、task —— stage 怎麼切? | 中級 | 3-1、3-2 |
| 7 | 窄依賴 vs 寬依賴? | 中級 | 3-3 |
| 8 | Task 是一個行程嗎?增加 executor 會讓 task 變多嗎? | 中級 | 3-1 |
| 9 | 什麼會觸發 shuffle?為什麼它很貴? | 中級 | 5-1、5-2 |
| 10 | repartition vs coalesce? |
中級 | 3-5 |
| 11 | reduceByKey vs groupByKey? |
中級 | 4-5 |
| 12 | Broadcast 變數與 accumulator —— 有什麼要注意的? | 中級 | 5-4 |
| 13 | Cache vs checkpoint? | 中級 | 7-3 |
| 14 | Executor 死掉時會發生什麼? | 中級 | 9-1 |
| 15 | 事件時間 vs 處理時間;什麼是 watermark? | 中級 | 11-2 |
| 16 | 怎麼偵測與修正資料傾斜? | 進階 | 6-1、6-2 |
| 17 | Broadcast join vs sort-merge join —— 10 TB 的 join 你會怎麼最佳化? | 進階 | 5-5、6-2 |
| 18 | Catalyst 怎麼運作?AQE 多做了什麼? | 進階 | 10-1、10-3 |
| 19 | 讀這份實體計畫 —— shuffle 在哪裡? | 進階 | 10-2 |
| 20 | Driver OOM vs executor OOM vs container 被砍? | 進階 | 8-2 |
| 21 | 一個 job 很慢 —— 帶我走一遍你怎麼除錯。 | 進階 | 12-1、12-2 |
| 22 | Structured Streaming 怎麼做到 exactly-once 的輸出? | 進階 | 11-3 |
| 23 | 串流 job 的延遲一直增加 —— 你會檢查什麼? | 進階 | 11-4 |
| 24 | 你怎麼處理小檔案? | 進階 | 12-3 |
| 25 | 設計一條從 Kafka 到倉儲的 TB 級管線。 | 設計 | 13-1 |
| 26 | 設計一個可回補的冪等每日批次 job。 | 設計 | 13-2 |
| 27 | 這個場景用 Spark 還是 Flink? | 設計 | 1-7 |
14-3) 面試前的自我檢查
能不看筆記做到以下每一項,就準備好了。
- [ ] 畫出 driver、cluster manager 與 executor,並從頭到尾講一遍
spark-submit。 - [ ] 給一段簡短的 DataFrame 程式,說出它跑幾個 job、幾個 stage,以及 shuffle 在哪裡。
- [ ] 說出為什麼 task 不是行程,以及一個給定的 cluster 同時能跑幾個 task。
- [ ] 解釋為什麼
reduceByKey勝過groupByKey,以及為什麼 DataFrame 讓這個問題不再重要。 - [ ] 說出每一種 join 策略,以及 Spark 何時選它。
- [ ] 從 Spark UI 的 task 表診斷出傾斜,並憑記憶寫出加鹽聚合。
- [ ] 畫出 executor 記憶體配置,並說出某個錯誤訊息指向哪一種 OOM。
- [ ] 讀一份
explain()輸出,指出下推、Exchange與 join 策略。 - [ ] 解釋 watermark、輸出模式,以及端到端 exactly-once 需要什麼。
- [ ] 設計一個可重跑的每日批次,並說明你會怎麼回補一個月的資料。
- [ ] 說出什麼時候你會選 Flink、資料倉儲或 DuckDB 而不是 Spark。